عملية تطوير متعددة الذكاء الاصطناعي موجهة بالوثائق في Naia ADK: اختبار الكفاءة باستخدام Jev
 مرحباً. أنا لوك، مطور Naia.
قد تبدو Naia للمستخدمين العاديين كمنتج لوكلاء شخصيات، ولكن جزءاً كبيراً من عملي اليومي ينصب على تطوير البرمجيات، لذا نقوم ببناء البنية التحتية اللازمة للتطوير وندير مشاريع تطوير البرمجيات لعملاء الشركات باستخدام البنية التحتية لتطوير Naia. في السابق، قمت بنشر كتاب بعنوان "هندسة Harness: هندسة برمجيات الذكاء الاصطناعي انطلاقاً من Re:Zero" (النسخة الكورية، النسخة الإنجليزية). ومنذ ذلك الحين، نواصل بذل جهود كبيرة لتأسيس عملية تطوير قائمة على وكلاء الذكاء الاصطناعي بشكل أفضل وأكثر إحكاماً.
واليوم، أشارك عملية تطوير البرمجيات والمخرجات التي تم إنشاؤها لتطوير Naia، وكيف نحاول دمج نموذج اتخاذ القرار Jev، الذي حظي باهتمام واسع مؤخراً، في عملية التطوير هذه.
كانت هناك ثلاثة أهداف رئيسية سعيت لتحقيقها في عملية التطوير هذه: الرؤية الواضحة، والتوازي، وتحسين التكلفة.
- الرؤية الواضحة : معرفة ما إذا كان التطوير يسير بشكل صحيح، وفي حال حدوث انحراف في النموذج، تحديد المرحلة التي نشأت فيها المشكلة بدقة.
- التوازي : توزيع المهام على وكلاء متعددين بالتوازي لزيادة سرعة التطوير.
- تحسين التكلفة : استخدام نماذج محسنة من حيث التكلفة. ويعد Jev بديلاً ممتازاً هنا.
الإطار الأساسي لنظام قواعد العمل (Harness) متاح كرمز مفتوح المصدر أدناه:
- الإطار الأساسي لمساحة العمل الفردية ونظام قواعد العمل (Harness): nextain/naia-adk
- الإطار الأساسي لتعاون الفرق والمشاريع: nextain/naia-pj-adk
- دليل المشاركة المجتمعية: nextain/naia-comm-public
- Jev هو نموذج اتخاذ قرار أطلقته شركة TypeSafe AI.
طابور المهام ولوحة المتابعة والمشغل (Runner) ووثائق التخطيط الموضحة في هذا المقال لا تزال قيد التطوير الداخلي وهي خاصة حالياً. وفي الوقت الحالي، تمر هذه العملية أيضاً بـ مرحلة التحقق، حيث يتم اختبارها على ميزة جديدة ستظهر لأول مرة على منصة Naia عبر الويب: تطوير Naia Visual Agent Studio، وهو أفتار فيديو قادر على مزامنة الشفاه والغناء. والسبب في عدم الكشف عنها للجمهور بعد هو أنها لم تصقل بشكل كافٍ بعد لتكون صالحة للاستخدام المشترك في مشاريع الفرق؛ وسنكشف عنها تباعاً بمجرد تنظيمها.
الاختصارات المستخدمة في هذا المقال ووثائق التطوير لدينا
أولاً، تستخدم وثائق التطوير والمهام وطوابير المهام لدينا الاختصارات التالية، ولدينا قاموس مصطلحات قياسي للمشروع. يرجع ذلك إلى عدم الرغبة في كتابة توجيهات طويلة للذكاء الاصطناعي وتجنباً لحدوث أي التباس في المصطلحات.
| الاختصار | الاسم الكامل | المصطلح | المعنى في سطر واحد |
|---|---|---|---|
| PC | Product / Project Concept | التخطيط عالي المستوى | لماذا نبني: جوهر المنتج، سبب الوجود، قيمة المستخدم، وهيكلية المعلومات العامة |
| SP | Screen Plan | تخطيط الشاشات | المخطط الهيكلي للشاشات التي سيراها المستخدم (التخطيط، التوزيع، التنقل) |
| UC | User Scenario | رحلة المستخدم (سيناريو المستخدم) | الرحلة الكاملة للمستخدم من دخوله في سياق معين، وتحقيق هدفه، وحتى خروجه |
| RQ | Requirements | المتطلبات | الشروط ومعايير القبول القابلة للقياس التي يجب أن يستوفيها النظام لتلبية UC وSP |
| PL | Plan / Architecture | التحليل الفني وخطة التصميم | التأكد من الحقائق التقنية من خلال القياس الفعلي ووضع خطة معمارية وتنفيذية مرحلية |
| FE | FEature | مواصفات الميزة | وحدات وظيفية ملموسة يتم بناؤها لتحقيق UC وRQ. ليست الواجهة الأمامية (Frontend) |
| UT | Unit Test | اختبار الوحدة | التحقق من أن الوحدة الوظيفية تعمل وفقاً للمواصفات |
| IT | Integration Test | اختبار التكامل | اختبار يخترق مكونات الخلفية الحقيقية من البداية إلى النهاية بدون واجهة مستخدم. ليس تقنية المعلومات (IT) |
| E2E | End-to-End Test | اختبار رحلة المستخدم الشامل | اختبار يخترق رحلة مستخدم واحدة كاملة من الشاشات الحقيقية إلى الخلفية الحقيقية |
| QC | Quality Control / Validation | الفحص المستقل | التحقق الصارم من وعود المنتج بالاعتماد حصراً على PC وSP دون الاطلاع على سيناريو المطور أو التنفيذ الداخلي |
1. دواعي الاعتماد وإدراك المشكلات
إذا تركت مهمة التطوير لوكلاء الذكاء الاصطناعي بشكل فضفاض، فإنهم يميلون إلى إنشاء واجهة المستخدم (UI, User Interface) دون وجود خلفية برمجية (Backend)، أو يبلغون بنجاح اختبارات تم إجراؤها باستخدام كائنات وهمية (Mocks). لذلك، نتبع منهجية التخطيط من الأعلى إلى الأسفل (Top-down) والتطوير من الأسفل إلى الأعلى (Bottom-up). ينحدر التخطيط من تجربة المستخدم الكلية، بينما يُبنى التطوير من أصغر وحدة عاملة، ولا يتم ربط الشاشة إلا بعد اختراق الخلفية الحقيقية بنجاح. لأن البدء بالشاشة يرجح بنسبة كبيرة حدوث تعديلات جذرية أثناء التكامل.
2. تدفق العمل الموجه بالوثائق وعملية التطوير
الهدف من كتابة الوثائق أولاً هو تحديد نطاق العمل ومعايير القبول مسبقاً. فتوثيق المتطلبات بدلاً من الاكتفاء بتوجيهات نصية بسيطة يتيح تتبع السبب الجذري عند حدوث المشكلات.
نقوم بسرد كافة وثائق عملية التطوير في قائمة، وبعد التحقق البشري ننشئ المشكلات (Issues) وبنود طابور المهام. وقبل إنشاء مشكلة جديدة، يفحص الذكاء الاصطناعي الوثائق المرتبطة بها ويطلع على المشكلات المفتوحة سابقاً. فالمهمة لا تُعتبر مكتملة إلا عند توفر المشكلة وبند الطابور وإيصالات الاختبار بشكل سليم وكامل.
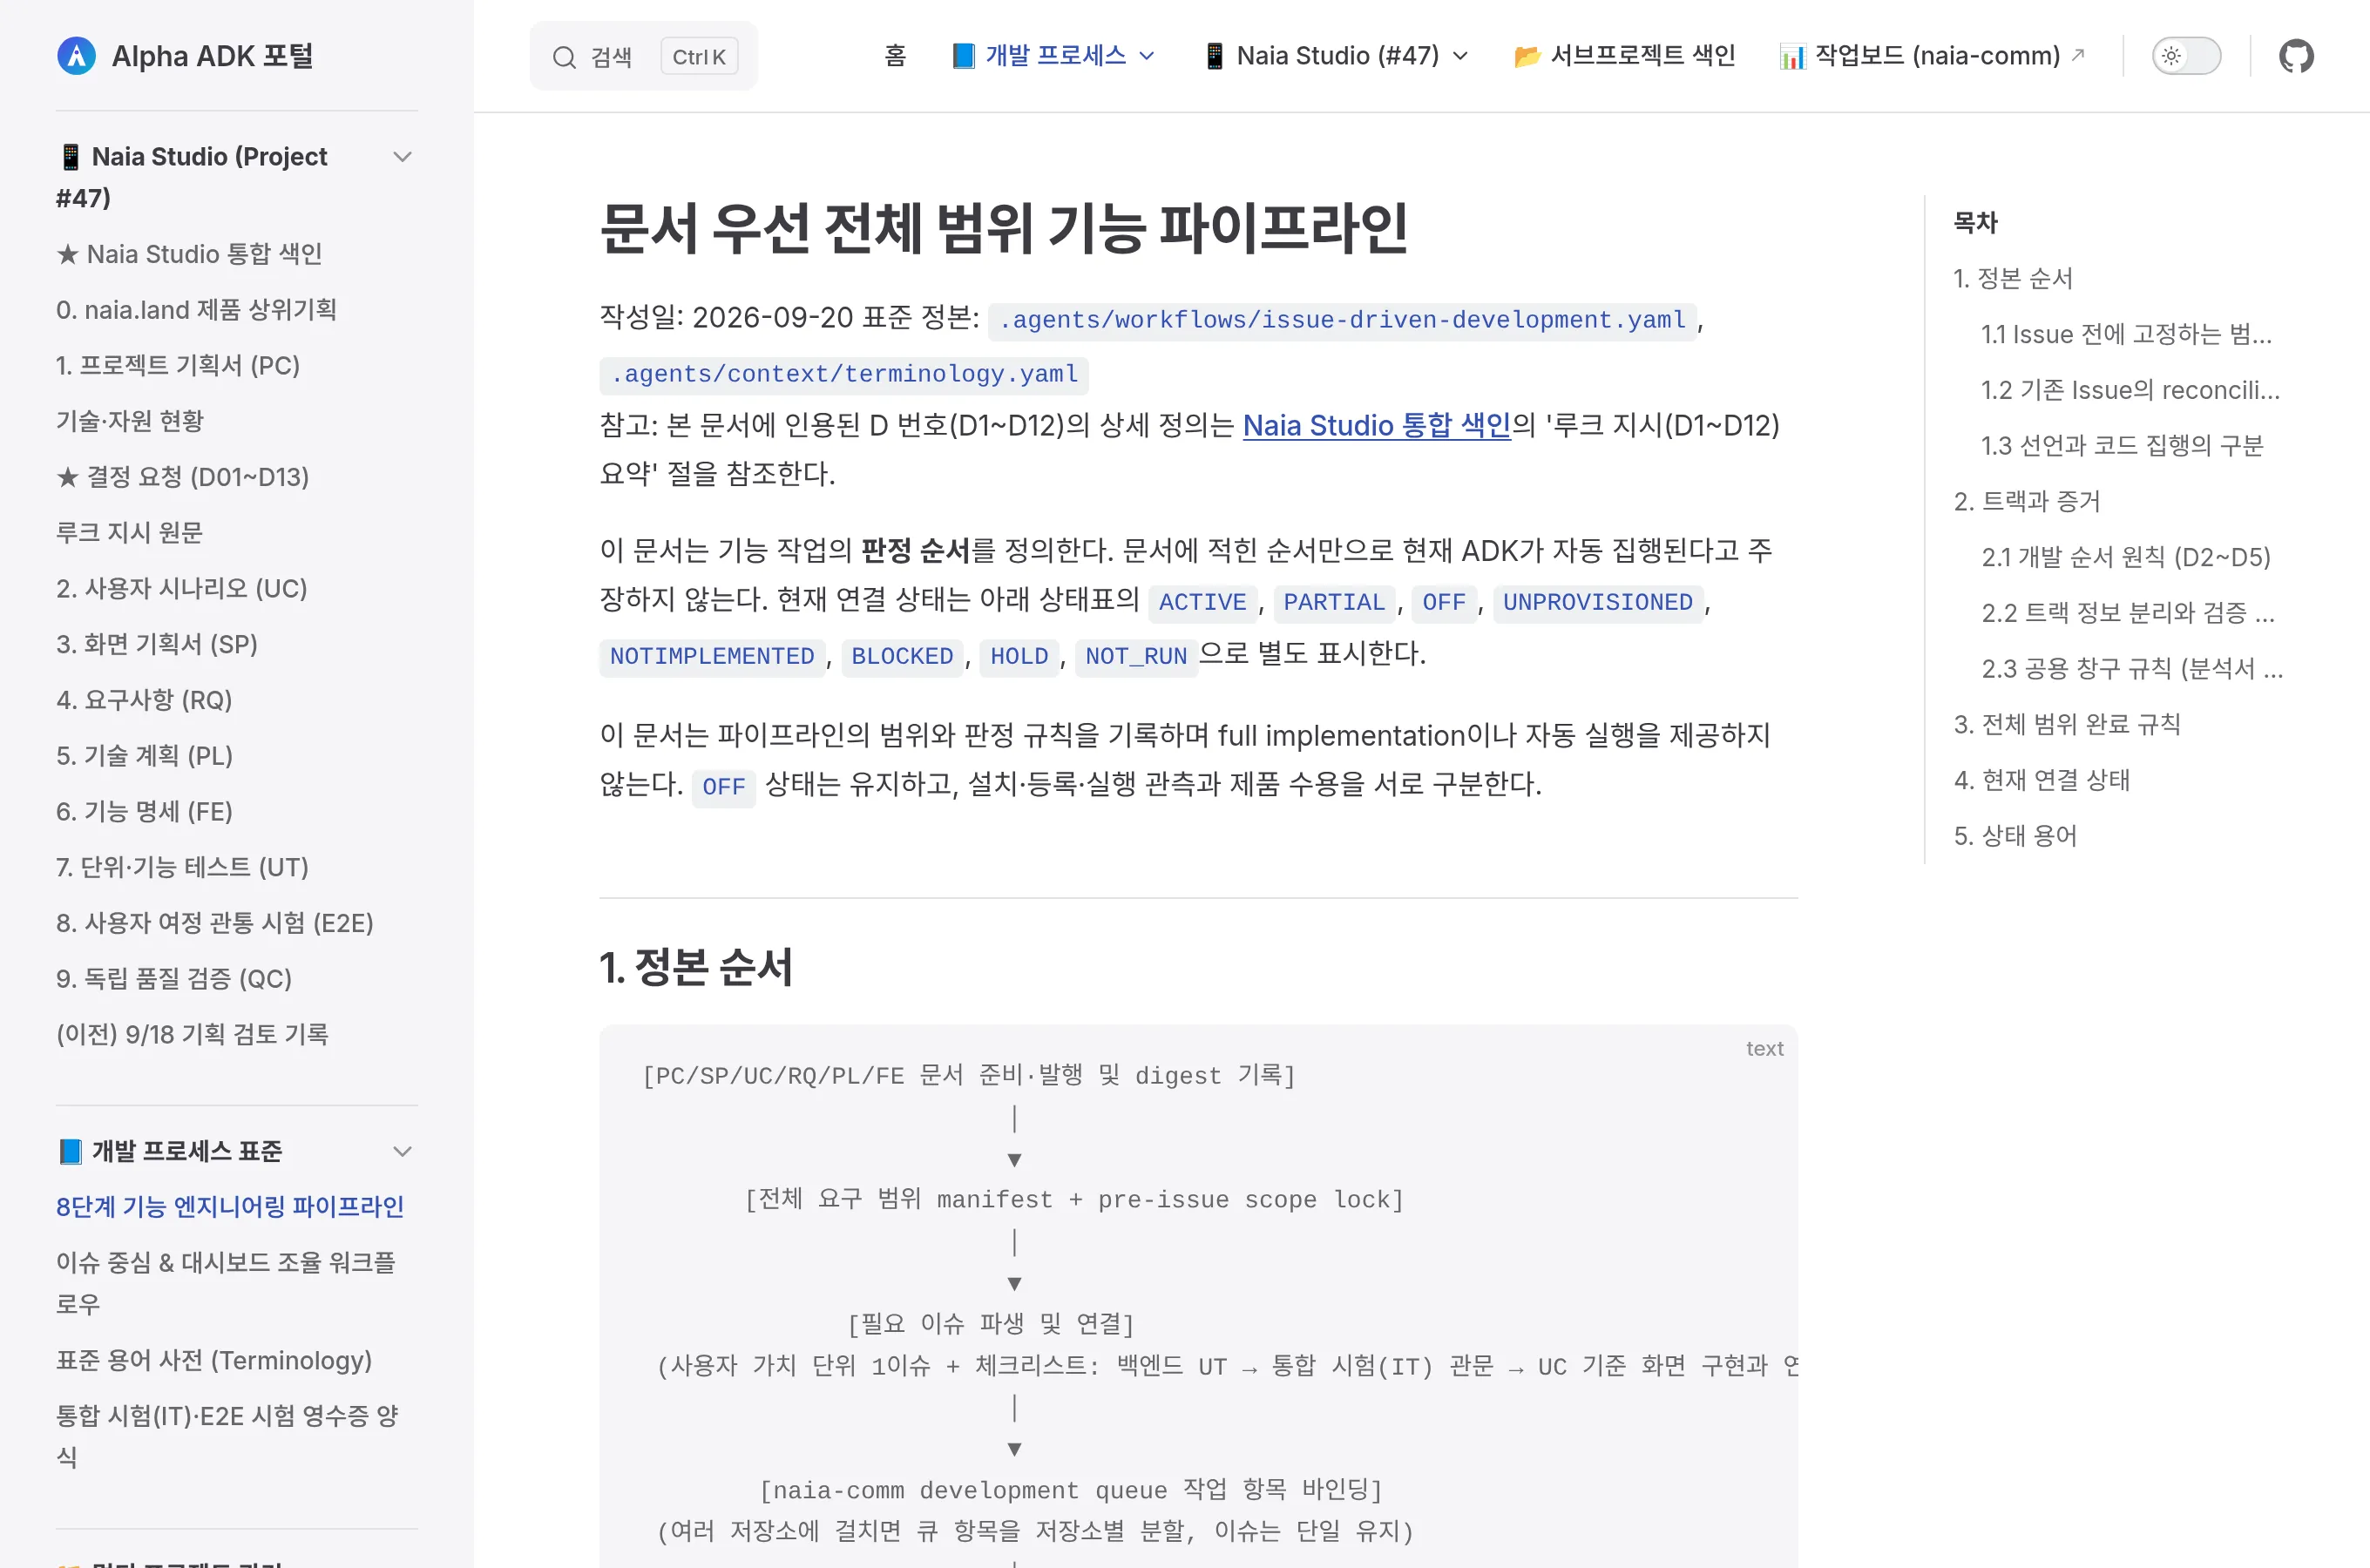 صفحة إجراءات التطوير في عارض الوثائق.
تتدرج الوثائق حسب ترتيب المخطط من سبب البناء (PC) نزولاً إلى وحدات الميزات المطلوب بناؤها (FE)، ولا توضع خطة التصميم (PL) إلا بعد قياس حدود النماذج والمحركات عملياً أولاً. ولا يتم تقسيم المشكلات وفقاً للطبقات التقنية، بل يتم تخصيص مشكلة واحدة لكل قيمة مستخدم حتى لو امتدت عبر مستودعات متعددة. وتحدد المراحل من الخلفية إلى الفحص كقائمة مراجعة داخل تلك المشكلة لضمان عدم إغفال أي شيء، ولا يُحكم بالاكتمال إلا عند اكتمال الأدلة لكافة النطاق المقفل بالوثائق.
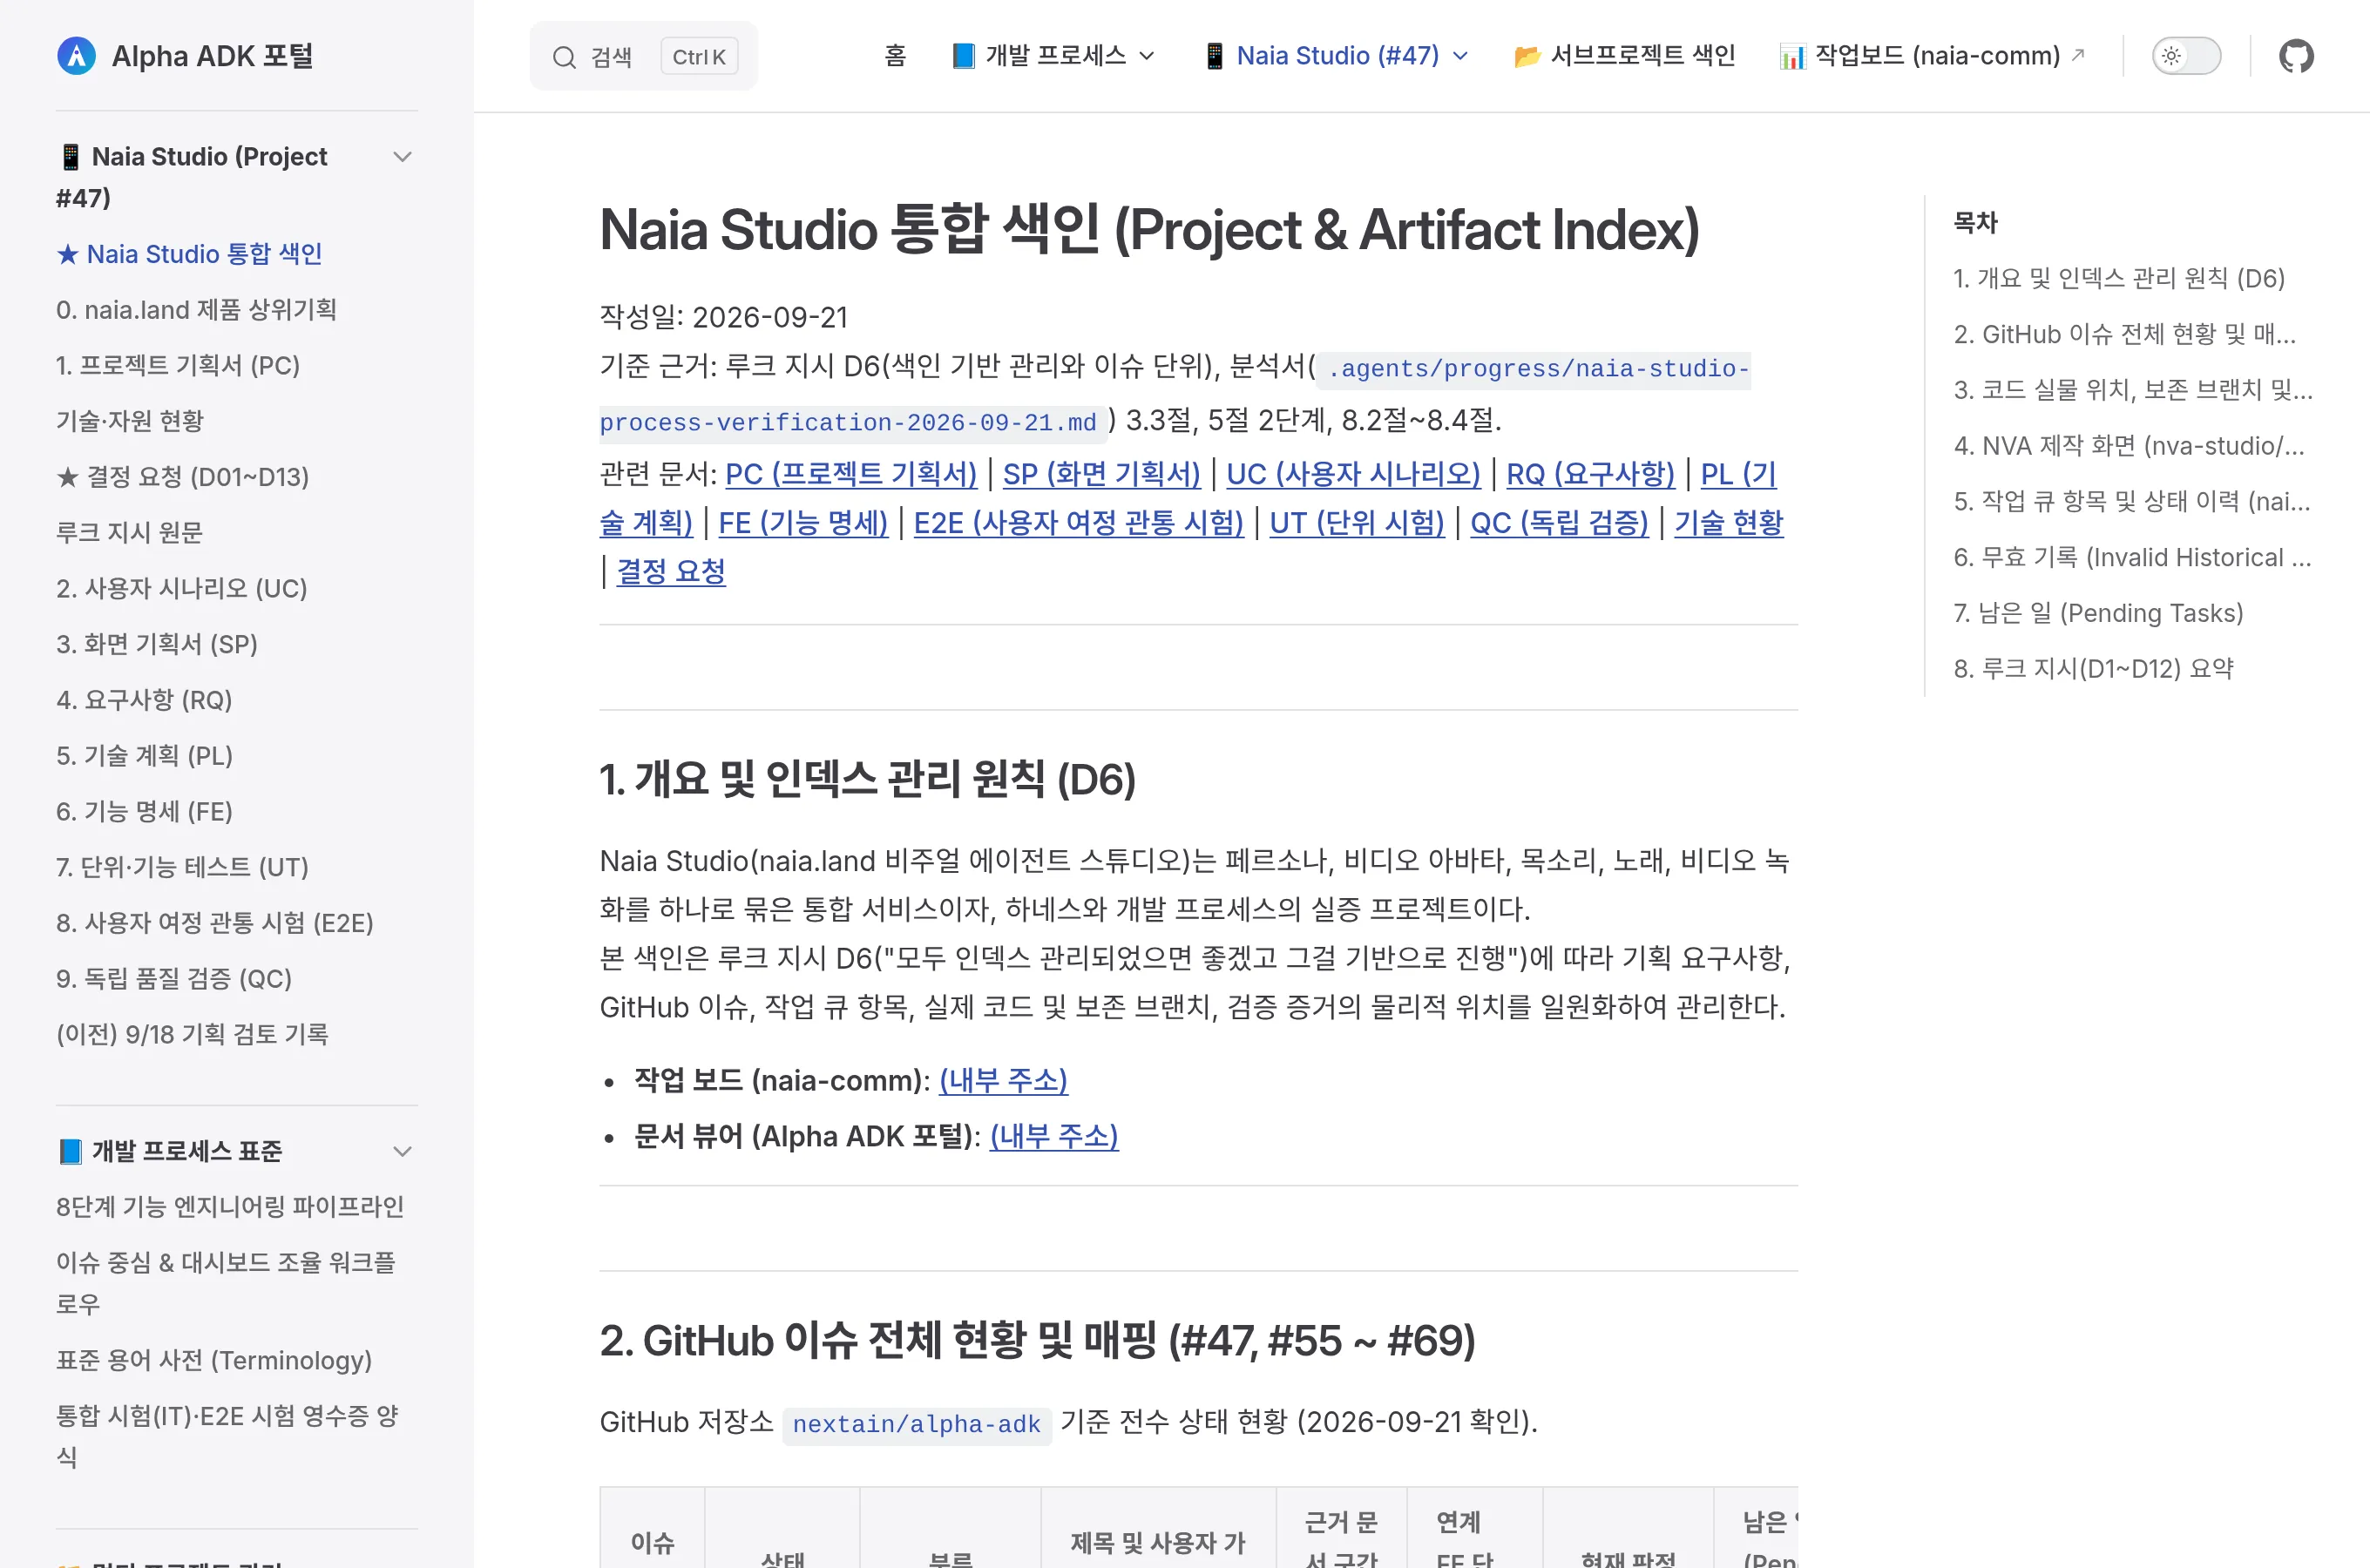 فهرس Studio المتكامل الذي يعرض المشكلات وأماكن التنفيذ وحالة الحكم لكل قسم من وثائق التخطيط في مكان واحد.
3. هيكل الاختبار ثلاثي الطبقات وقواعد التسلسل
يُقسم الاختبار إلى ثلاث طبقات وفقاً للتسميات القياسية في الصناعة.
- اختبار الوحدة (UT): يتحقق مما إذا كانت الوحدة الوظيفية (FE) تعمل وفقاً للمواصفات.
- اختبار التكامل (IT): يخترق مكونات الخلفية الحقيقية بالكامل دون واجهة مستخدم. ولا يُعتد بالاختبارات التي تقتصر على الكائنات الوهمية (Mocks).
- اختبار رحلة المستخدم الشامل (E2E): يخترق رحلة مستخدم واحدة من شاشات المتصفح الحقيقية إلى الخلفية الحقيقية. تُغلق الوحدات التي لا تتضمن شاشات في SP باختبار التكامل دون E2E؛ أما في حال وجود شاشات، فإن اختبار E2E يكون إلزامياً حتى لو كان التغيير مقتصراً على الخلفية. فالمعيار المعتمد هو SP وليس الفارق البرمجي للمنفذ.
الجوهر يكمن في التسلسل: يتم تطوير الواجهة الأمامية (الشاشة) فقط بعد اجتياز الخلفية لاختبار التكامل (IT). وحالياً لا يتم منع هذا التسلسل آلياً بواسطة Harness، بل يتم التحقق منه عبر عقود المهام والمراجعات المستقلة بواسطة الإيصالات، وهو ما يترك مجالاً للتحسين.
يتم إجراء الفحص المستقل (QC) بمعزل عن اختبارات المنفذ، وبدون الاطلاع على UC وFE، حيث يتحقق بقوة من الوفاء بوعود المنتج في ظل مدخلات قسرية وظروف استثنائية بالاعتماد على PC وSP فقط. ذلك لأن الاطلاع على UC وFE قد يدفع المراجع للتحقق من ذلك النطاق الضيق فقط. ونظراً لوقوع هذا الفحص في مرحلة لاحقة من التطوير، فإننا لم نتمكن بعد من إجراء تحقق تجريبي كامل له.
4. طابور المهام ولوحة المتابعة القائمان على Git
لضمان مصداقية من قام بالعمل ومتى وماذا أنجز، تُدار المهام عبر طابور مهام في مستودع Git (naia-comm). لا يوجد خادم مشترك حتى الآن؛ والهدف هو بناء خادم تطوير بعد مرحلة التحقق لتمكين التعاون بين أجهزة ومطورين متعددين.
يقوم كل جهاز مشارك باستنساخ المستودع وسحب التحديثات دورياً للعثور على المهام الجديدة والإبلاغ عن سجلات العمل. ويقتصر التنفيذ على المشغلات (Runners) المسجلة محلياً بواسطة مالك الجهاز (برامج تستلم المهام من الطابور وتشغل الذكاء الاصطناعي نيابة عنها)، حيث يسجل في الطابور اسم المشغل فقط دون تضمين الأوامر المراد تنفيذها.
يتم تدوين كل مرحلة من مراحل المهمة في ملف JSON جديد. وتُسجل أدلة التنفيذ ورموز الخروج في إيصالات النتائج، وتُضاف عمليات الإلغاء بنفس الطريقة، مما يوثق كافة العمليات ويعزز إمكانية التتبع. ولوحة العمل ليست سوى شاشة تعيد قراءة وعرض هذه السجلات عند الطلب.
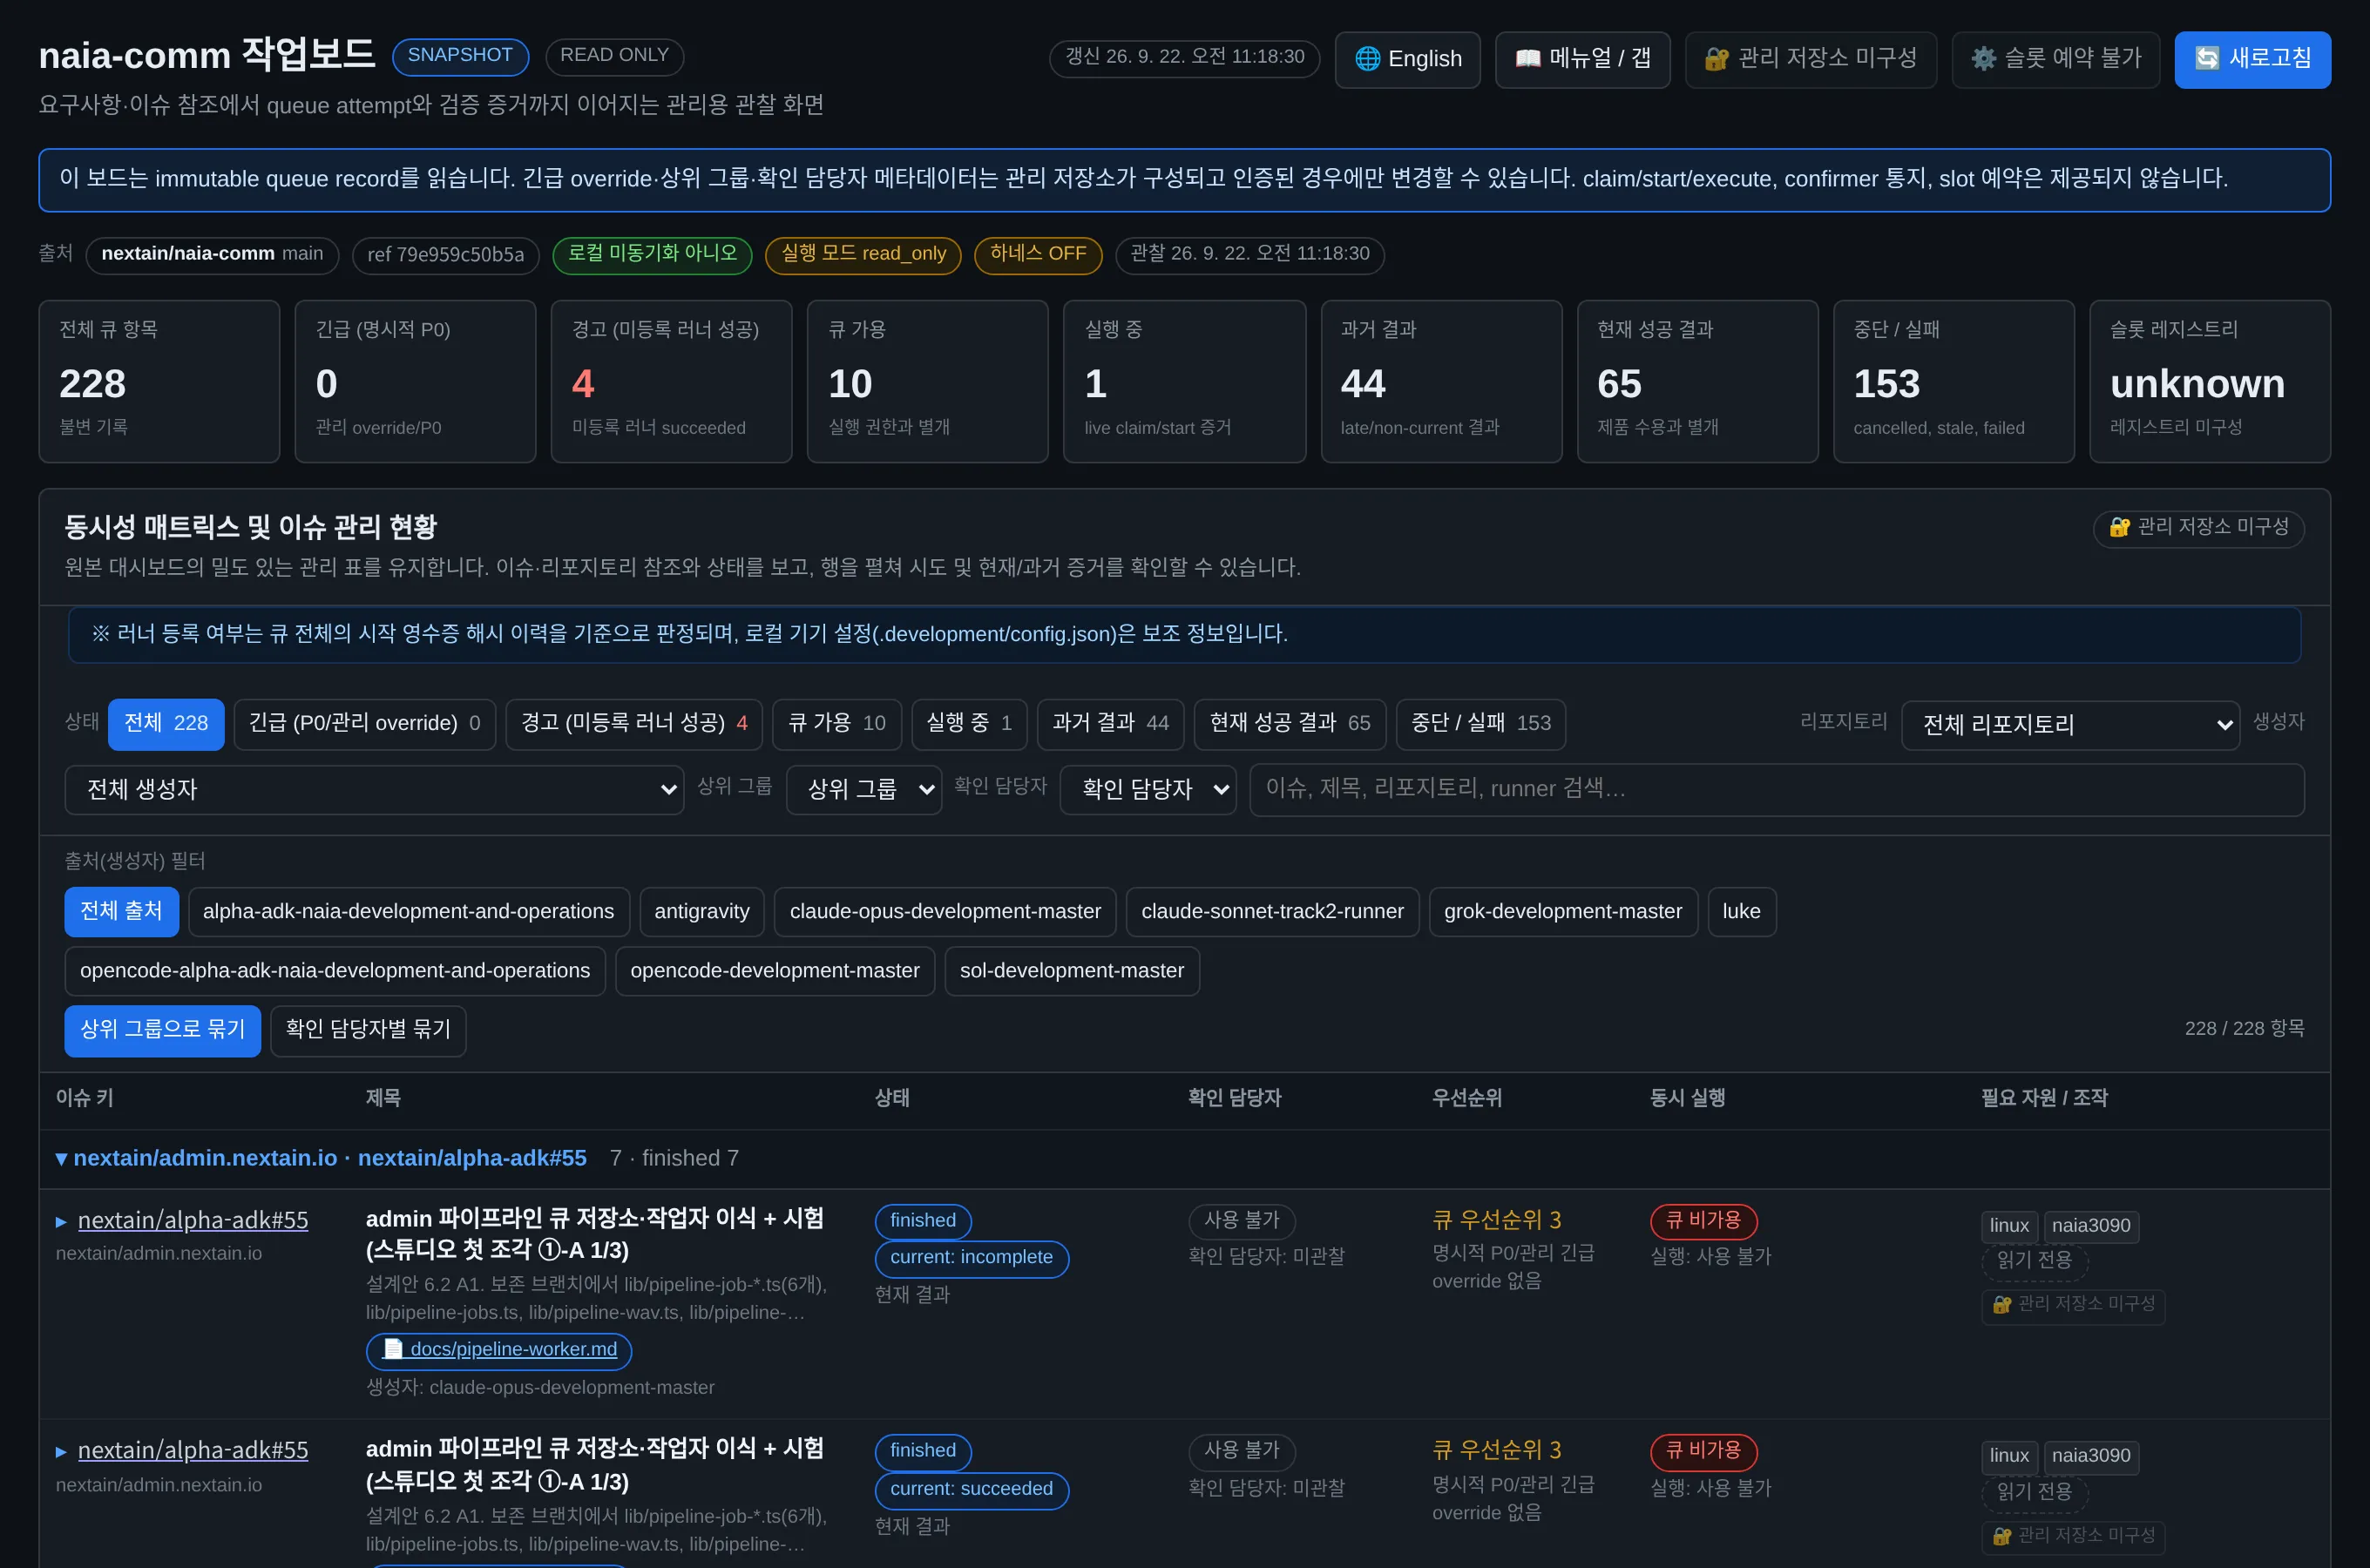 هذه هي شاشة لوحة العمل (تم حجب العناوين الداخلية). تُجمع المؤشرات العلوية سجلات الطابور من الفرع الرئيسي main لمستودع naia-comm: في وقت التقاط الصورة، من أصل 228 بند مهمة، كان هناك 10 متاحة، و1 قيد التشغيل، و65 نتيجة ناجحة حالياً، مع وضع تحذيرات على 4 سجلات ناجحة بأسماء مشغلات غير مسجلة.
5. نظام قواعد العمل وهيكل التعاون متعدد الوكلاء
نظام قواعد العمل هو القواعد المحددة بالوثائق وإجراءات التحقق منها. أدوات الفحص التلقائي معطلة حالياً في وضع الاسترداد ("HARNESS OFF" على شاشة اللوحة)، ولا توجد بعد بوابات تمنع المخالفات عبر الكود البرمجي، لذا تضمن عقود مهام المنسق ونصوص المراقبة والمراجعات المستقلة الالتزام بالقواعد.
إن الاعتماد على النماذج المتقدمة فقط يرفع التكاليف بشكل كبير، والاعتماد على النماذج الخفيفة فقط يؤدي إلى فشل التصميم والتحقق مما يضر بالمشروع. لذلك، قمنا بتوزيع النماذج وفقاً لطبيعة المهام وجعلناها تتحقق من بعضها البعض.
| الدور | النموذج المسؤول | أسلوب التنفيذ والمهمة |
|---|---|---|
| التحليل وخطة التصميم | Claude Fable | تحليل سياق النظام بأكمله، وضع خطة التحليل الفني والهندسة المعمارية (PL)، وتصميم خطة التحقق من العملية |
| تنسيق المهام (Master) | Claude Opus | التوزيع العام للمهام والتحكم في التدفق، مراقبة الوكلاء دون كتابة كود المنتج مباشرة |
| تنفيذ الكود والاختبار | Gemini 3.8 Flash | تنفيذ أدوات سطر الأوامر (CLI, Command-Line Interface) بدون حوار (التشغيل غير المراقب مصمم للمرور عبر المشغل). يتولى الاختبار جلسة Flash مختلفة عن جلسة التنفيذ |
| المراجعة النزاعية | Claude Opus | إشراك جلسة جديدة في كل جولة، إجراء تحقيق مستقل بالاستناد إلى المواد الأصلية ومقارنة التسليمات، واستخراج العيوب التي تغير النتائج |
| تنفيذ كود المشغل | Claude Sonnet | تنفيذ الكود بواسطة نموذج آخر لمنع العامل (agy) من كتابة كود يوسع صلاحياته الخاصة، مثل جعل المشغل يستدعي عمال agy بموافقة تلقائية شاملة |
※ توزيع النماذج قيد التجربة وهو قابل للتغيير.
من خلال كفاءة التكلفة وفصل الصلاحيات، نعهد بالكميات الكبيرة من التنفيذ وتكرار الاختبارات إلى Gemini 3.8 Flash لتوفير حصص النماذج المتقدمة، مع استمرار استكشاف وتعديل النماذج المناسبة لكل دور. ولا يستطيع العمال توسيع صلاحياتهم بأنفسهم، مما يقلل من احتمالية منح الوكلاء لأنفسهم امتيازات والتسبب في مشكلات. ومع ذلك، فإن الأخطاء البرمجية في هذه الميزة تؤدي بشكل متكرر إلى توقف المهام وعزلها في حالات غير قابلة للتنفيذ، لذلك نواصل الاختبار والتحسين المستمر.
على سبيل المثال، لا تعمل عمليات فحص الموقع مثل "مطابقة checkout للمستودع المعلن" إلا عند المرور عبر المشغل، ولا تنطبق على عمليات التشغيل التي تبدأ مباشرة عبر تعليمات العمل.
6. المراجعة النزاعية القائمة على التحقيق المستقل
قبل فتح المخرجات المقدمة، يقوم المراجع أولاً بالتحقيق بنفسه في التعليمات الأصلية والمستودع والالتزامات وسجلات طابور المهام لتدوين استنتاجاته الخاصة، ثم يقارنها بعد ذلك بما تم تسليمه. فالاعتماد على التسليمات وحدها يؤدي إلى إغفال المقدمات الخاطئة أو المستودعات غير الصحيحة. وفي كل مرة يقوم مراجع جديد بالفحص، ويتم الاجتياز إذا لم تكن هناك ملاحظات تغير الاستنتاجات لجولتين متتاليتين. وإذا تكررت حلقة من الملاحظات البسيطة غير الجوهرية، يتوقف المسار ويحال الأمر إلى العنصر البشري لاتخاذ القرار.
7. النتائج الملحوظة والحدود القائمة
النتائج الملحوظة
يعمل حالياً هيكل متكامل ينفذ فيه نموذج منخفض التكلفة (Gemini 3.8 Flash) المهام عبر جلسات سطر أوامر غير تفاعلية، ويراقب المنسق الحدود عبر عقود المهام ونصوص المراقبة، ويقارن النموذج المتقدم النتائج بعد إجراء تحقيق مستقل في جلسة جديدة في كل جولة. وتكشف نصوص المراقبة لاحقاً عن الأوامر التي نفذها العامل، وأصبح بإمكان المراجع التقاط أي وقائع غير صحيحة يقدمها العامل.
الحدود ونقاط الضعف الملحوظة
كثيراً ما تميل النماذج الرخيصة ذات الأداء الأقل إلى المضي قدماً دون الامتثال للتعليمات. فهي تسجل معرفات طوابير غير موجودة وتبلغ عن الاكتمال، أو تدرج شروط إعفاء غير مطلوبة في وثائق الإجراءات، أو تغير الشروط الأصلية بمهارة أثناء التلخيص. وتقتصر جلسة الاختبار على مراقبة ما إذا كان النص البرمجي ينجح أم لا، دون القدرة على تمييز ما إذا كان هذا الاختبار يعمل بالفعل على الخلفية الحقيقية.
ورغم أن المراجعة المستقلة تصفي مثل هذه العيوب، إلا أن تكلفة التحقق باهظة. ويرجع ذلك إلى أن جهداً كبيراً من نماذج المراجعة المتقدمة يُستهلك في التدقيق الميكانيكي للحقائق. وهذا هو السبب أيضاً وراء استمرارنا في اختبار تكوينات النماذج المناسبة لكل دور.
8. تعزيز كفاءة التحقق بواسطة Jev والمهام المستقبلية
لتخفيف عبء المراجعة، حاولنا تقسيم التحقق إلى ثلاث طبقات. وفي الطبقة الثانية، نجري حالياً تحققاً تقنياً لتقييم إمكانية دمج Jev، الذي يتميز بتكلفته المنخفضة وسرعته العالية.
- الطبقة الأولى، التحقق الميكانيكي (نصوص برمجية): الأمور التي تتطلب مجرد مقارنة بسيطة: نجاح أو فشل إيصالات الاختبار (0 حالات فشل، رمز الخروج 0)، استجابة الروابط، وجود الملفات.
- الطبقة الثانية، تحديد النوع (Jev): عندما تشير إيصالات اختبار التكامل (IT) وE2E إلى "نجاح"، يتم التمييز بين ما إذا كان الاختبار قد اخترق الخلفية الحقيقية بالفعل أم أنه اجتاز فقط كائنات وهمية. ونظراً لأن اختبارات الوحدة (UT) يُسمح فيها بالأصل باستخدام كائنات وهمية، فهي ليست مستهدفة هنا.
- الطبقة الثالثة، الحكم التوجيهي (النماذج المتقدمة والبشر): التأكد من توافق النطاق والهدف.
Jev هو نموذج اتخاذ قرار من TypeSafe AI، وهو نموذج منخفض التكلفة يجيب بسرعة بالاعتماد حصراً على خيارات واحتمالات محددة مسبقاً. ونظراً لأن تطوير البرمجيات ينطوي على العديد من مسائل الاختيار، يمكن من خلال القياس المستمر العثور على العتبة المناسبة (Threshold) لتحقيق كفاءة التكلفة والسرعة. وتعد هذه طريقة تحسين كانت شائعة الاستخدام في تطوير برمجيات الذكاء الاصطناعي التقليدي قبل ظهور نماذج LLM، وفيما يلي نتائج التحقق.
نتائج التحقق
من خلال اعتماد قرارات Jev فقط عندما تكون نسبة الثقة 0.85 أو أعلى وتعطي نفس الإجابة عند إعادة صياغة السؤال — مع تفويض الباقي إلى نماذج اللغة الكبيرة (LLM) —، وعلى عينة من 871 ملف اختبار (257 في التقييم النهائي)، قمنا بقياس وتقدير إمكانية تقليل الوقت بنحو 66% والتكلفة بنحو 60~70% (تم قياس الوقت مقارنة بـ Gemini 3.8 Flash، وحُسبت التكلفة بناءً على سعر وحدة نماذج مثل Opus وLuna).
| أسلوب الحكم | الملفات التي تولاها Jev | إجابات خاطئة | الوقت المستغرق (مقارنة بالاعتماد على LLM فقط) |
|---|---|---|---|
| الاعتماد على LLM فقط | 0% | معيار الأساس | 100% |
| القاعدة الحالية (الثقة >= 0.85 + نفس الإجابة مع اختلاف الصياغة) | نحو 72% | 0 حالة في الملفات المتوافق عليها بين النموذجين | 34% (48% عند التشغيل المتوازي لـ 4 ملفات) |
| عند خفض العتبة إلى 0.59 | نحو 89% | زيادة قدرها 1.8%p | 17% |
بلغت تكلفة 971 استدعاءً لـ Jev ما مقداره 0.22 دولار، واستغرق الحكم الواحد لـ Jev نحو 0.7 ثانية مقارنة بنحو 12 ثانية لنموذج LLM.
نحن نواصل البحث عن القيم المثلى من خلال توسيع نطاق التجارب. وعلى الرغم من تأكيد الإمكانات الواعدة، إلا أننا لم نقم بدمجها بعد في عملية التطوير الفعلية. ونظراً لأن الإجابات الصحيحة اقتصرت على الملفات التي قدم فيها كلا النموذجين نفس الإجابة، فقد تكون النتائج متحيزة نحو الملفات الأسهل.
المهام المستقبلية
من خلال هذا الإجراء، تم إنجاز أولى ميزات Studio (إدخال سيناريو لتوليد الصوت والاستماع إليه وتنزيله) من الخلفية البرمجية وحتى اختبار رحلة المستخدم الشامل. وتتمثل المهام المتبقية في زيادة أتمتة التحقق، وجعل الأدوات تفرض القواعد التي يحافظ عليها البشر وعقود المهام حالياً. كما نخطط لإجراء تجربة منفصلة لمعرفة ما إذا كان يمكن استخدام Jev ليس فقط لعلامات التحقق، بل أيضاً للتحكم في التدفق لاختيار المهمة التالية عند انتهاء مهمة ما. ذلك لأن هذا الحكم على التدفق يتطلب حالياً استدعاء نموذج متقدم لكل مهمة، مما يجعله جزءاً مكلفاً ويسبب تأخيراً زمنياً كبيراً.
آمل أن تكون هذه التفاصيل المشتركة مفيدة لكم. ويسعدنا جداً اهتمامكم بمنتجات Naia. يتعين علينا إطلاق المنتجات بسرعة وإظهار النتائج للانتقال إلى المرحلة التالية، لكن يبدو أننا ما زلنا نكرس الكثير من الوقت لأساليب التحكم الدقيق والتطوير الخاصة بالذكاء الاصطناعي شديد التعقيد.
