Dokumentengesteuerter Multi-KI-Entwicklungsprozess in Naia ADK: Effizienzsteigerung mit Jev im Test
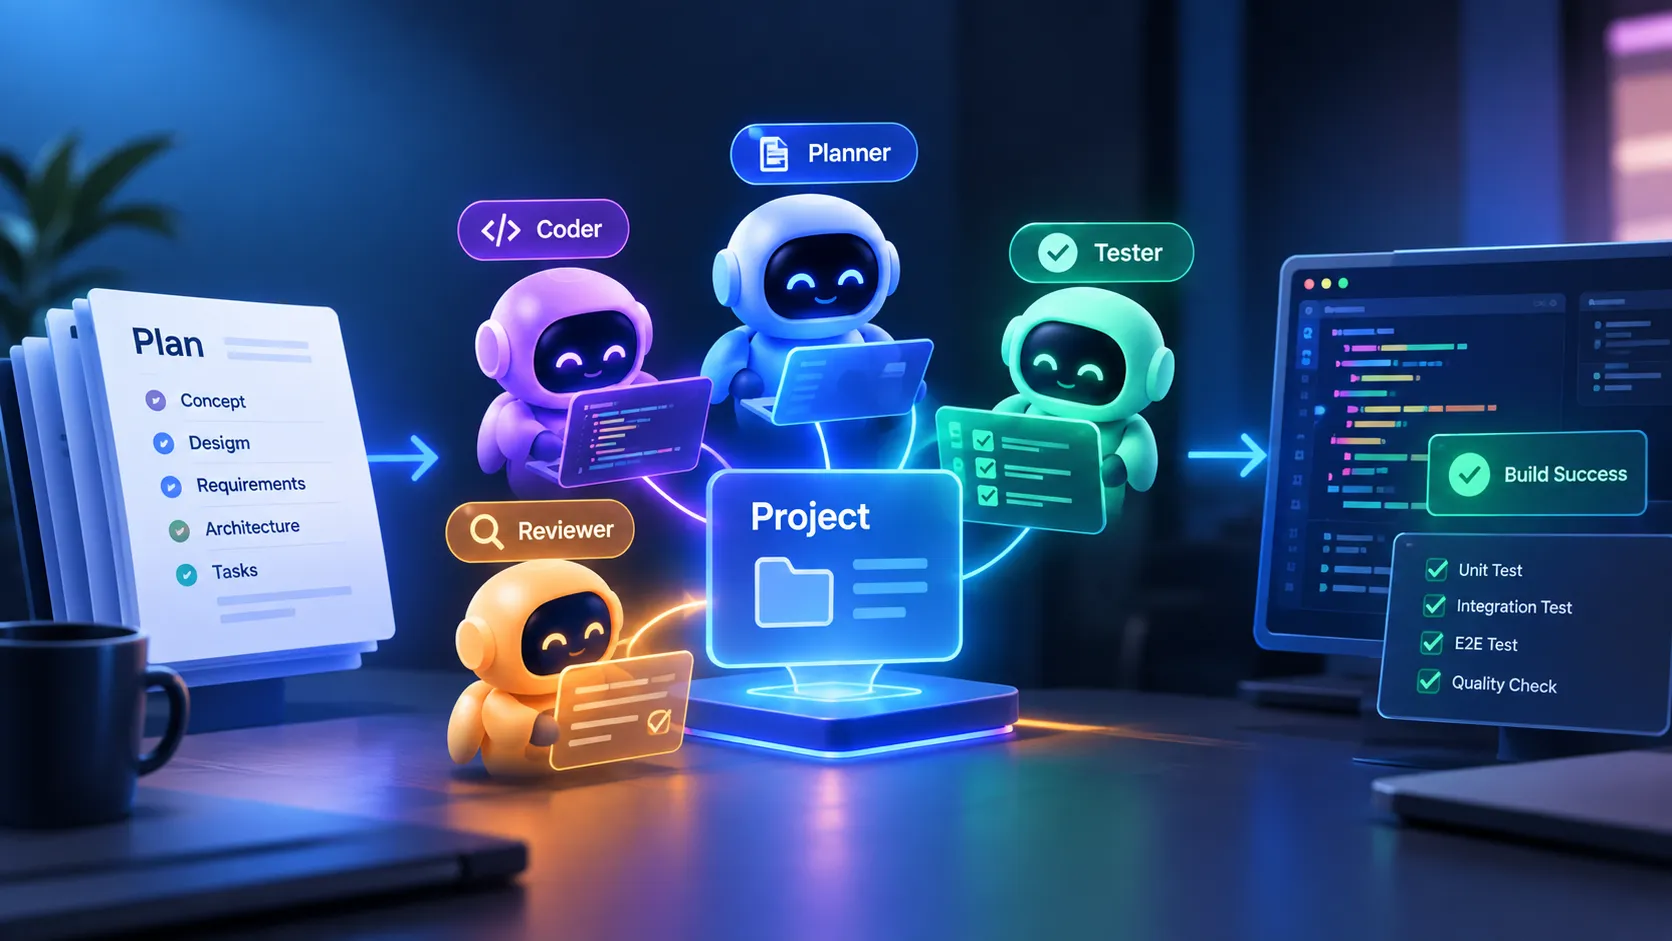 Hallo. Ich bin Luke, der Entwickler von Naia.
Naia mag für normale Nutzer wie ein Konsumprodukt aus Charakter-Agenten aussehen, doch ein Großteil meiner täglichen Arbeit besteht aus Softwareentwicklung. Daher bauen wir die entsprechende Entwicklungsinfrastruktur auf und führen Softwareentwicklungen für Unternehmenskunden über die Naia-Entwicklungsinfrastruktur durch. Zuvor hatte ich ein Buch mit dem Titel „Harness Engineering: KI-Softwaretechnik ab Re:Zero“ (koreanische Ausgabe, englische Ausgabe) veröffentlicht. Auch seither setzen wir kontinuierlich große Anstrengungen daran, einen auf KI-Agenten basierenden Entwicklungsprozess noch besser aufzustellen.
Heute veröffentliche ich den für die Entwicklung von Naia geschaffenen Softwareentwicklungsprozess und dessen Arbeitsergebnisse und berichte darüber, wie wir versuchen, das aktuell sehr gefragte Entscheidungsmodell Jev in diesen Entwicklungsprozess einzubinden.
In diesem Entwicklungsprozess wollte ich vor allem drei Ziele verfolgen: Sichtbarkeit, Parallelisierung und Kostenoptimierung.
- Sichtbarkeit : Wissen, ob ordnungsgemäß entwickelt wird, und bei einem Modell-Drift genau feststellen können, auf welcher Stufe das Problem aufgetreten ist.
- Parallelisierung : Aufgaben parallel an Multi-Agenten verteilen, um das Entwicklungstempo zu steigern.
- Kostenoptimierung : Kostenoptimierte Modelle einsetzen. Auch hier stellt Jev eine hervorragende Alternative dar.
Das Grundgerüst unseres Arbeitsregelsystems (Harness) ist unten als Open Source öffentlich zugänglich:
- Grundgerüst für persönliche Arbeitsbereiche und Arbeitsregelsystem (Harness): nextain/naia-adk
- Grundgerüst für Team- und Projektzusammenarbeit: nextain/naia-pj-adk
- Leitfaden zur Community-Beteiligung: nextain/naia-comm-public
- Jev ist ein von TypeSafe AI veröffentlichtes Entscheidungsmodell.
Die in diesem Artikel beschriebenen Komponenten wie Aufgabenwarteschlange, Board, Runner und Planungsdokumente befinden sich noch in der internen Entwicklung und sind daher privat. Derzeit befindet sich auch dieser Prozess in der Validierungsphase und wird für ein neues Feature erprobt, das im Naia-Web debütieren soll: die Entwicklung des Naia Visual Agent Studio, eines Video-Avatars mit Lippensynchronisation und Gesangsfähigkeit. Dass diese noch nicht öffentlich sind, liegt daran, dass sie für eine gemeinsame Nutzung in Teamprojekten noch nicht ausreichend ausgereift sind; sobald alles geordnet ist, werden wir weitere Teile offenlegen.
In diesem Artikel und unseren Entwicklungsdokumenten verwendete Abkürzungen
Zunächst verwenden unsere Entwicklungsdokumente, Issues und Aufgabenwarteschlangen die folgenden Abkürzungen und verfügen über ein Standard-Projektglossar. Der Grund dafür war, dass ich keine langen Prompts an die KI tippen wollte und das Risiko begrifflicher Verwechslungen vermeiden wollte.
| Abkürzung | Vollständiger Name | Begriff | Einzeilige Bedeutung |
|---|---|---|---|
| PC | Product / Project Concept | Übergeordnete Planung | Warum wir bauen: Wesen des Produkts, Existenzgrund, Nutzerwert, gesamte Informationsarchitektur |
| SP | Screen Plan | Bildschirmplanung | Struktureller Bauplan der Bildschirme, die der Nutzer sehen wird (Layout, Anordnung, Navigation) |
| UC | User Scenario | Nutzerreise (User Scenario) | Gesamte Reise, bei der ein Nutzer unter bestimmten Bedingungen eintritt, sein Ziel erreicht und wieder geht |
| RQ | Requirements | Anforderungen | Bedingungen und messbare Akzeptanzkriterien, die das System erfüllen muss, um UC und SP zu genügen |
| PL | Plan / Architecture | Technische Analyse & Entwurfsplanung | Technische Gegebenheiten durch reale Messungen überprüfen sowie Architektur- und schrittweise Implementierungspläne erstellen |
| FE | FEature | Funktionsspezifikation | Konkrete Funktionseinheit zur Realisierung von UC und RQ. Nicht Frontend |
| UT | Unit Test | Modultest (Unit-Test) | Überprüfen, ob eine Funktionseinheit gemäß Spezifikation funktioniert |
| IT | Integration Test | Integrationstest | Test, der ohne Benutzeroberfläche reale Backend-Komponenten bis zum Ende durchdringt. Nicht Informationstechnik (IT) |
| E2E | End-to-End Test | Nutzerreise-Durchdringungstest | Test, der eine gesamte Nutzerreise vom realen Bildschirm bis zum realen Backend durchdringt |
| QC | Quality Control / Validation | Unabhängige Prüfung | Aggressive Überprüfung der Produktversprechen allein anhand von PC und SP, ohne Entwicklerskripte oder interne Implementierung einzusehen |
1. Hintergrund der Einführung und Problembewusstsein
Wenn man die Entwicklung weitgehend KI-Agenten überlässt, neigen sie dazu, ohne Backend direkt Benutzeroberflächen (UI, User Interface) zu erstellen oder Tests, die mit Mock-Objekten liefen, als bestanden zu melden. Daher planen wir von oben nach unten (Top-down) und entwickeln von unten nach oben (Bottom-up). Die Planung geht vom gesamten Nutzererlebnis aus, während die Entwicklung aus kleinsten funktionierenden Einheiten aufgebaut wird – wobei die Benutzeroberfläche erst angebunden wird, nachdem das Backend tatsächlich durchgängig funktioniert. Beginnt man mit dem Bildschirm, ist die Wahrscheinlichkeit massiver Nacharbeiten bei der Integration sehr hoch.
2. Dokumentengesteuerter Arbeitsablauf und Entwicklungsprozess
Dokumente zuerst zu verfassen dient dazu, den Umsetzungsumfang und die Akzeptanzkriterien vorab verbindlich festzulegen. Indem Vorgaben dokumentiert statt als einfache Prompts erteilt werden, lässt sich die Ursache im Fehlerfall präzise zurückverfolgen.
Wir listen sämtliche Dokumente des Entwicklungsprozesses auf und erstellen erst nach menschlicher Prüfung Issues und Einträge in der Aufgabenwarteschlange. Bevor die KI ein neues Issue anlegt, prüft sie, über welche Dokumente sich das Issue erstreckt, und zieht zuvor geöffnete Issues zu Rate. Nur wenn Issues, Warteschlangeneinträge und Testbelege allesamt ordnungsgemäß vorliegen, kann eine Aufgabe als abgeschlossen beurteilt werden.
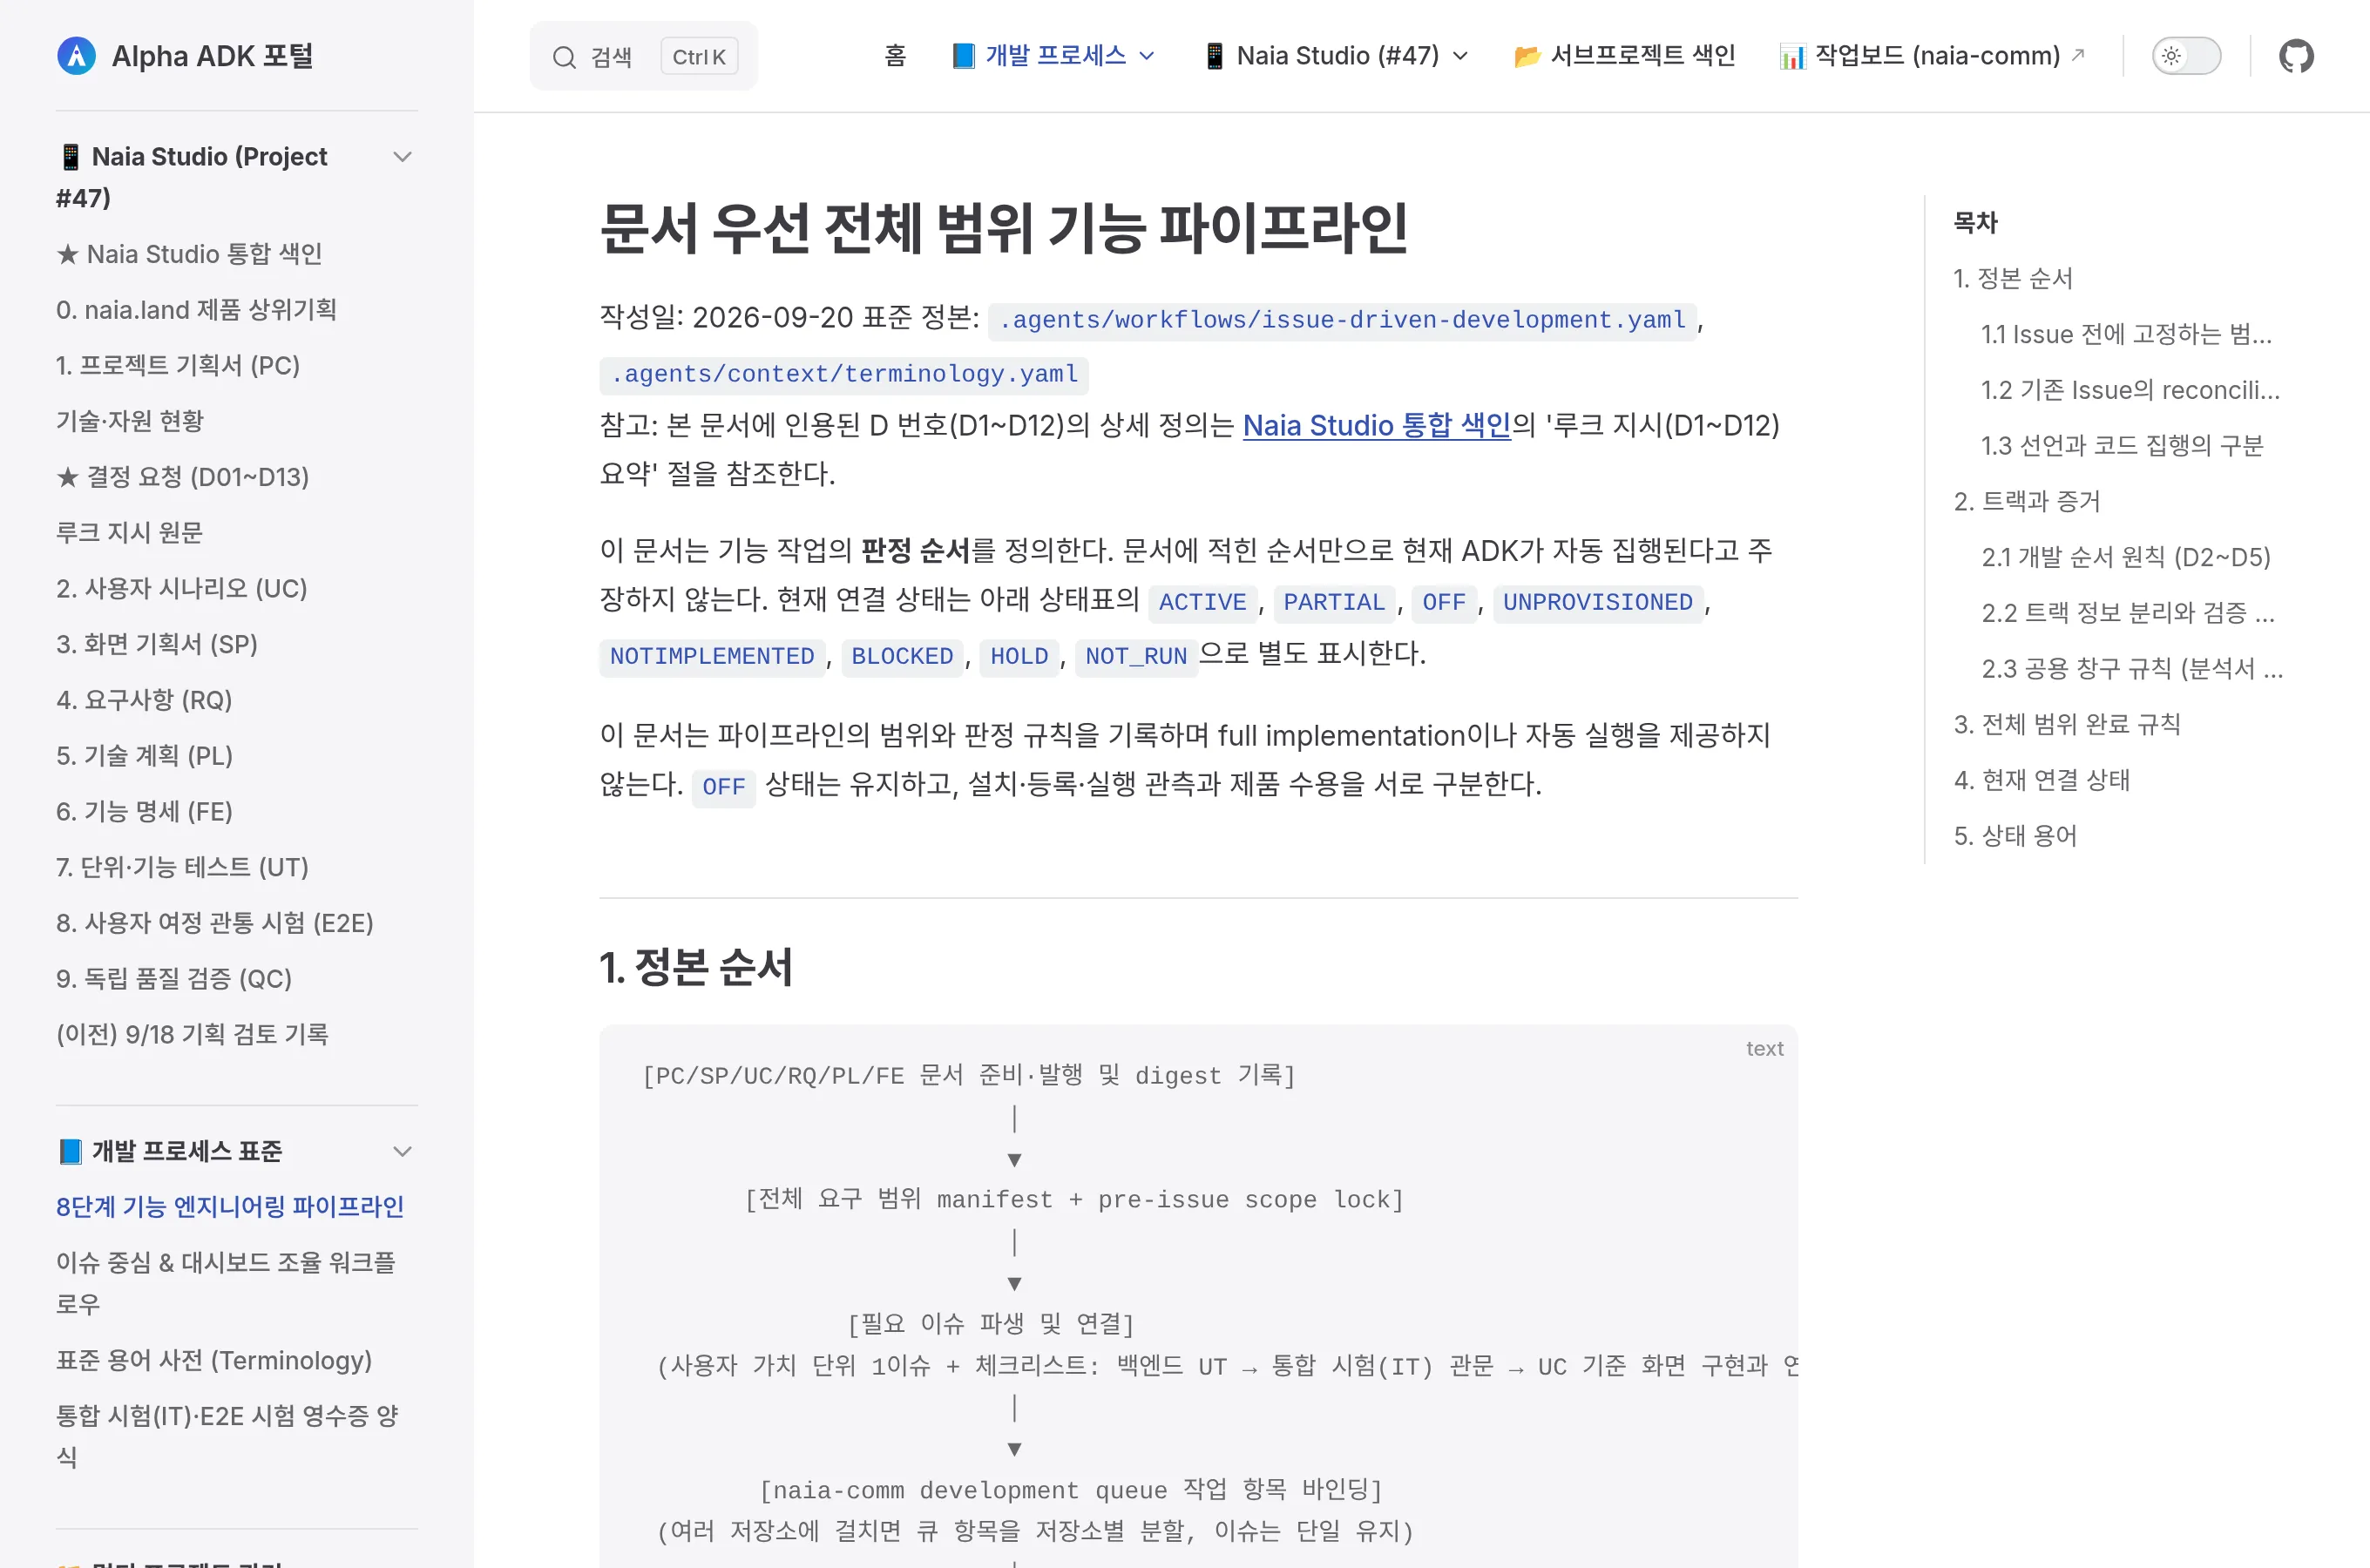 Entwicklungsablaufseite im Dokumenten-Viewer.
Dokumente bewegen sich in der Reihenfolge des Schemas vom Warum (PC) bis zu den zu bauenden Funktionseinheiten (FE) nach unten, und Entwürfe (PL) werden erst erstellt, nachdem die Grenzen von Modellen und Engines zuvor real nachgemessen wurden. Issues werden nicht nach Technologieschichten aufgeteilt, sondern es gibt genau ein Issue pro Nutzerwert, selbst wenn mehrere Repositories betroffen sind. Die Prozessschritte vom Backend bis zur Prüfung werden innerhalb dieses Issues als Checkliste definiert, um Auslassungen zu verhindern; der Abschluss wird erst dann festgestellt, wenn der gesamte durch die Dokumentation gesperrte Umfang mit Nachweisen belegt ist.
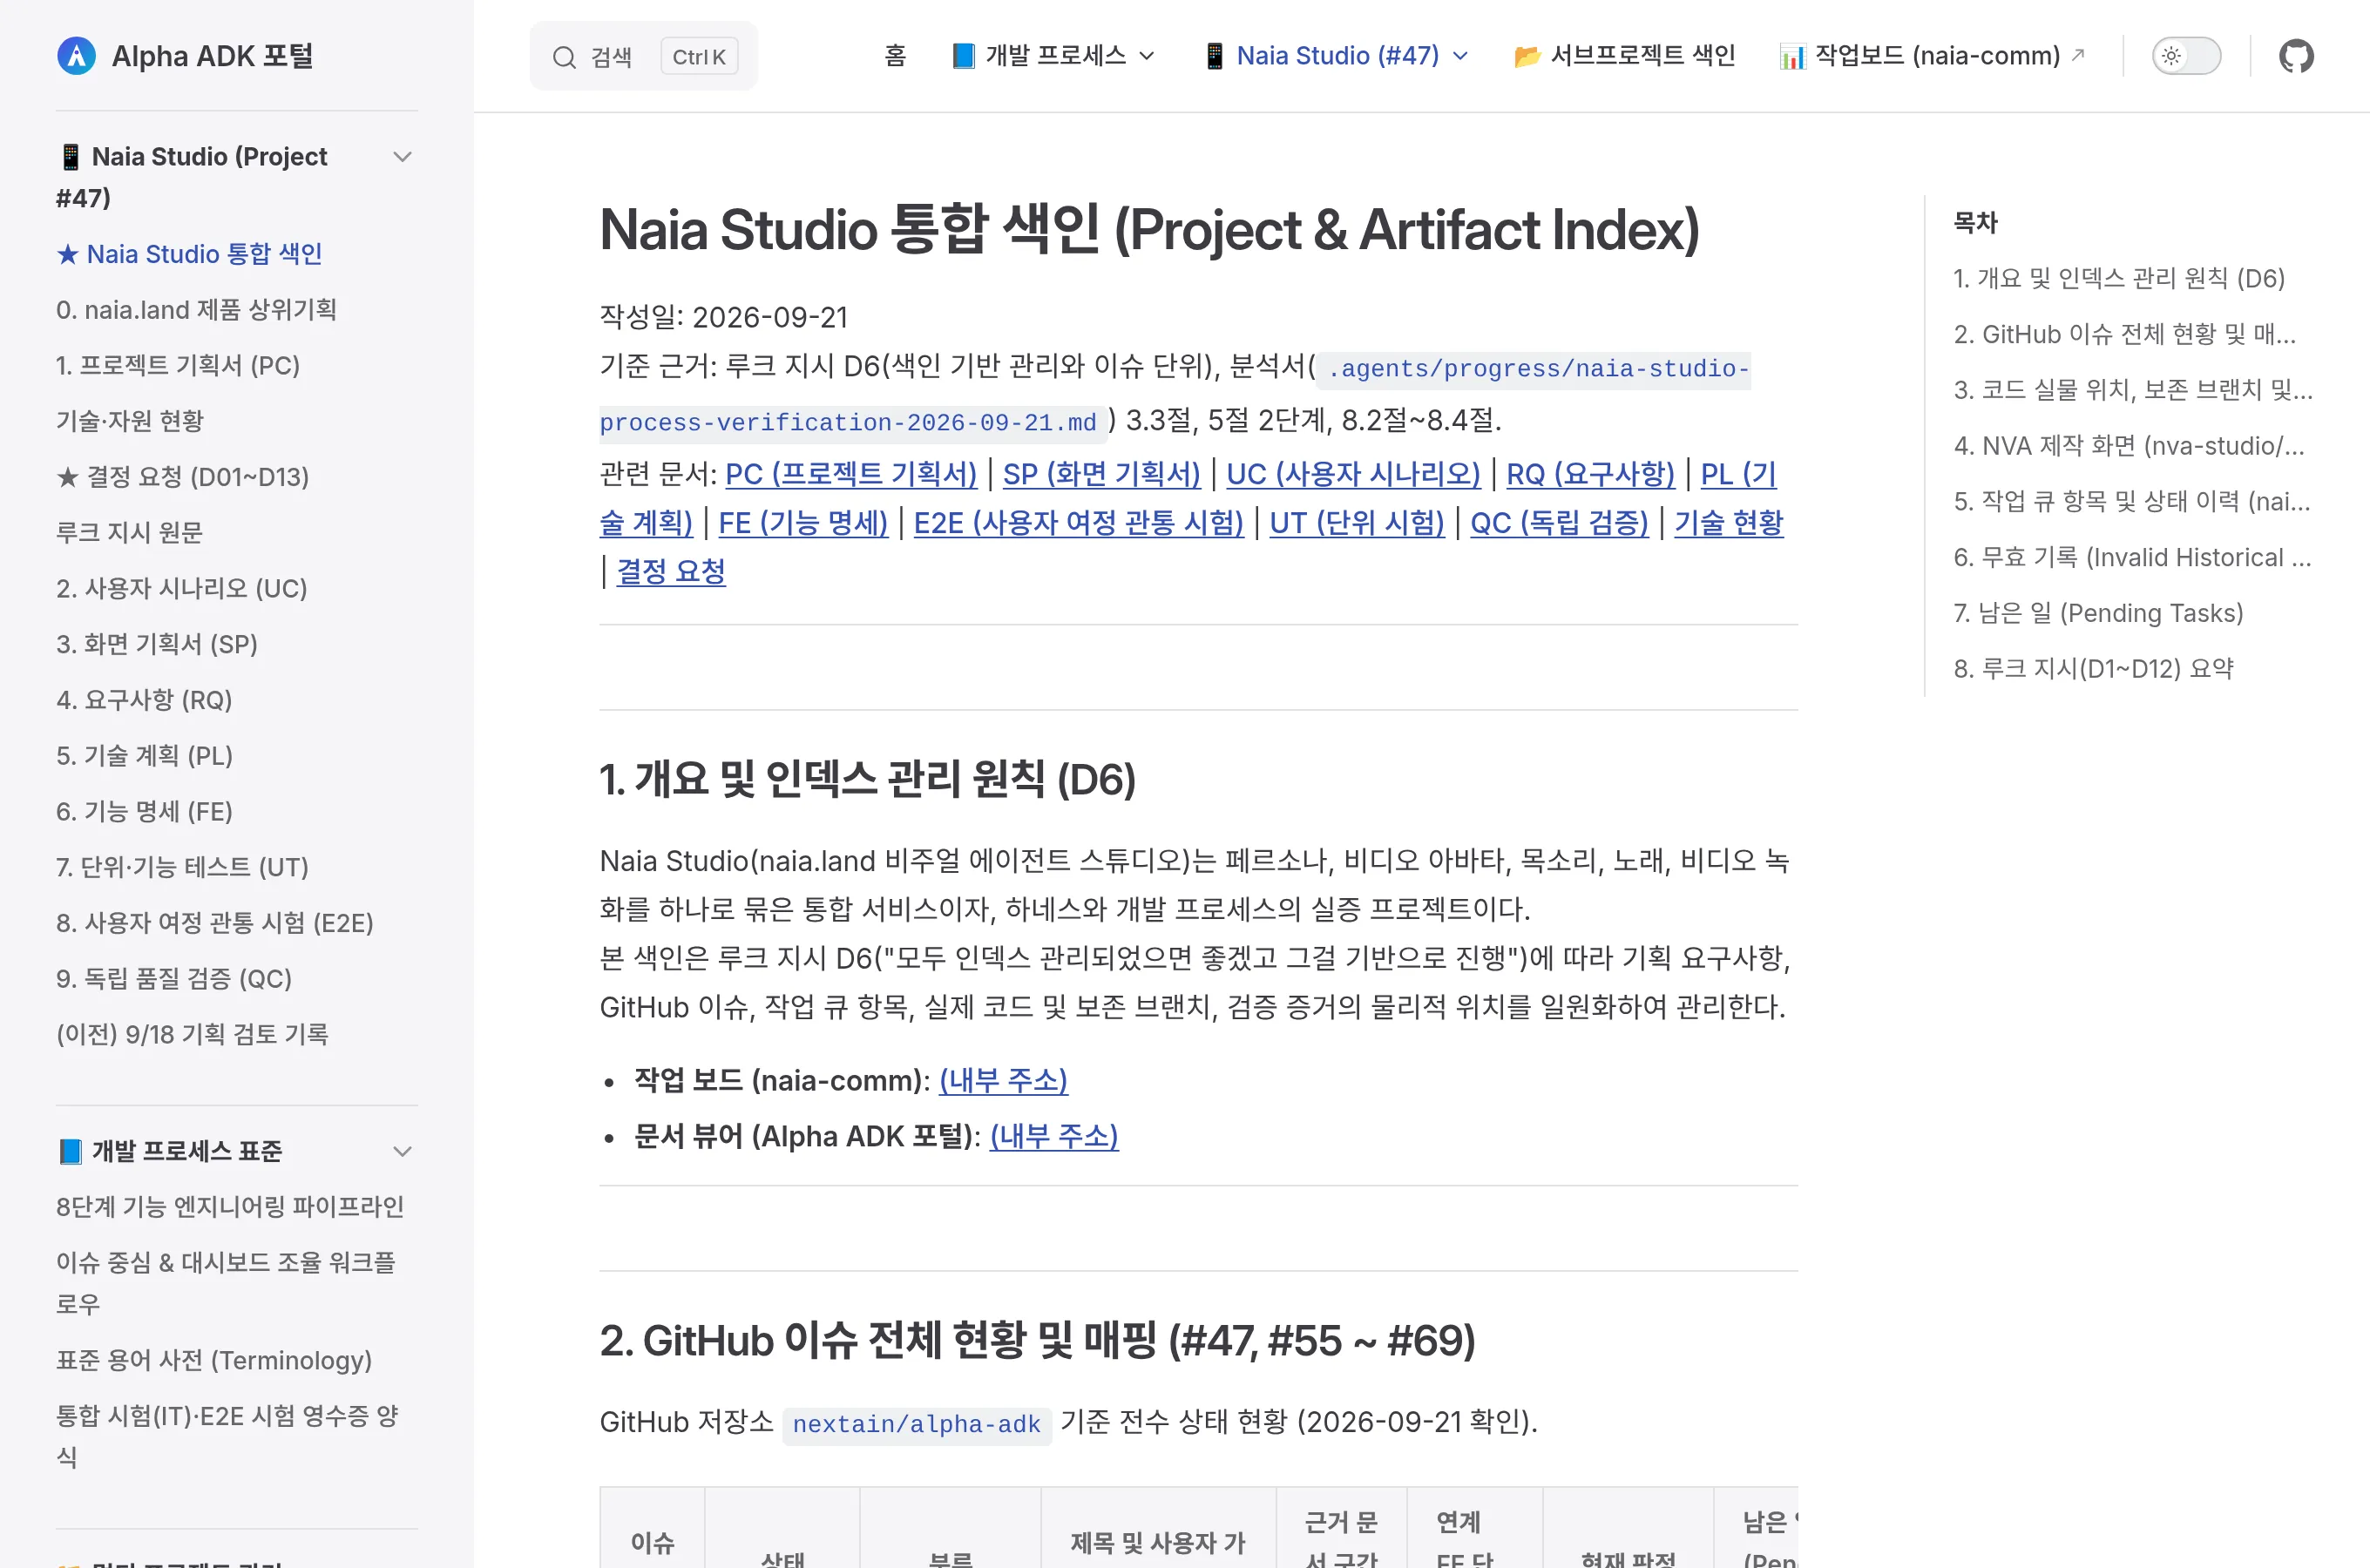 Integrierter Studio-Index, der Issues, Implementierungsorte und Prüfungsstatus für jeden Abschnitt der Planungsdokumente an einem zentralen Ort zeigt.
3. Dreistufige Teststruktur und Reihenfolgeregeln
Tests werden entsprechend den Branchenstandards in drei Schichten unterteilt.
- Modultest (UT): Prüft, ob eine Funktionseinheit (FE) gemäß Spezifikation arbeitet.
- Integrationstest (IT): Durchdringt reale Backend-Komponenten ohne Benutzeroberfläche bis zum Ende. Tests, die lediglich Mock-Objekte durchlaufen, werden nicht anerkannt.
- Nutzerreise-Durchdringungstest (E2E): Durchdringt eine gesamte Nutzerreise vom realen Browser-Bildschirm bis zum realen Backend. Nur Einheiten ohne Bildschirme im SP werden ohne E2E per Integrationstest abgeschlossen; sind Bildschirme vorhanden, ist E2E selbst dann erforderlich, wenn die aktuelle Änderung nur das Backend betrifft. Maßstab ist der SP, nicht das Diff des Entwicklers.
Der Kern liegt in der Reihenfolge: Das Frontend (UI) wird erst entwickelt, nachdem das Backend den Integrationstest (IT) bestanden hat. Gegenwärtig wird diese Reihenfolge noch nicht mechanisch durch das Harness blockiert, sondern anhand von Arbeitsaufträgen und unabhängigen Reviews über Belege kontrolliert, was Raum für Verbesserungen bietet.
Die unabhängige Prüfung (QC) findet getrennt von den Tests des Implementierers statt. Ohne UC und FE einzusehen, prüft sie allein anhand von PC und SP aggressiv nach, ob die Produktversprechen auch bei unzulässigen Eingaben und Ausnahmesituationen eingehalten werden. Würde man UC und FE einsehen, bestünde die Gefahr, lediglich diesen engen Rahmen abzuprüfen. Da dies in einer späteren Phase der Entwicklung angesiedelt ist, konnte es empirisch noch nicht abschließend erprobt werden.
4. Git-basierte Aufgabenwarteschlange und Arbeitsboard
Um verlässlich nachvollziehen zu können, wer wann was getan hat, werden Aufgaben über eine Aufgabenwarteschlange in einem Git-Repository (naia-comm) verwaltet. Einen gemeinsamen Server gibt es noch nicht; Ziel ist es, nach der Validierung einen Entwicklungsserver aufzubauen, um die Zusammenarbeit über mehrere Geräte und Entwickler hinweg zu ermöglichen.
Jedes teilnehmende Gerät klont das Repository und führt regelmäßige Pulls durch, um neue Aufgaben zu finden und Arbeitsberichte zu übermitteln. Die Ausführung erfolgt ausschließlich durch Runner, die vom Gerätebesitzer lokal registriert wurden (Programme, die Aufgaben aus der Warteschlange entgegennehmen und die KI an ihrer Stelle ausführen); in der Warteschlange steht lediglich der Name des Runners, nicht die auszuführenden Befehle.
Jede Phase einer Aufgabe wird in einer neuen JSON-Datei festgehalten. In Ergebnisbelegen werden Ausführungsnachweise und Exit-Codes dokumentiert, und auch Abbrüche werden im Append-Verfahren angefügt, sodass alle Operationen protokolliert werden und die Rückverfolgbarkeit gestärkt wird. Das Arbeitsboard ist lediglich eine Anzeige, die diese Protokolle bei jedem Aufruf erneut einliest und darstellt.
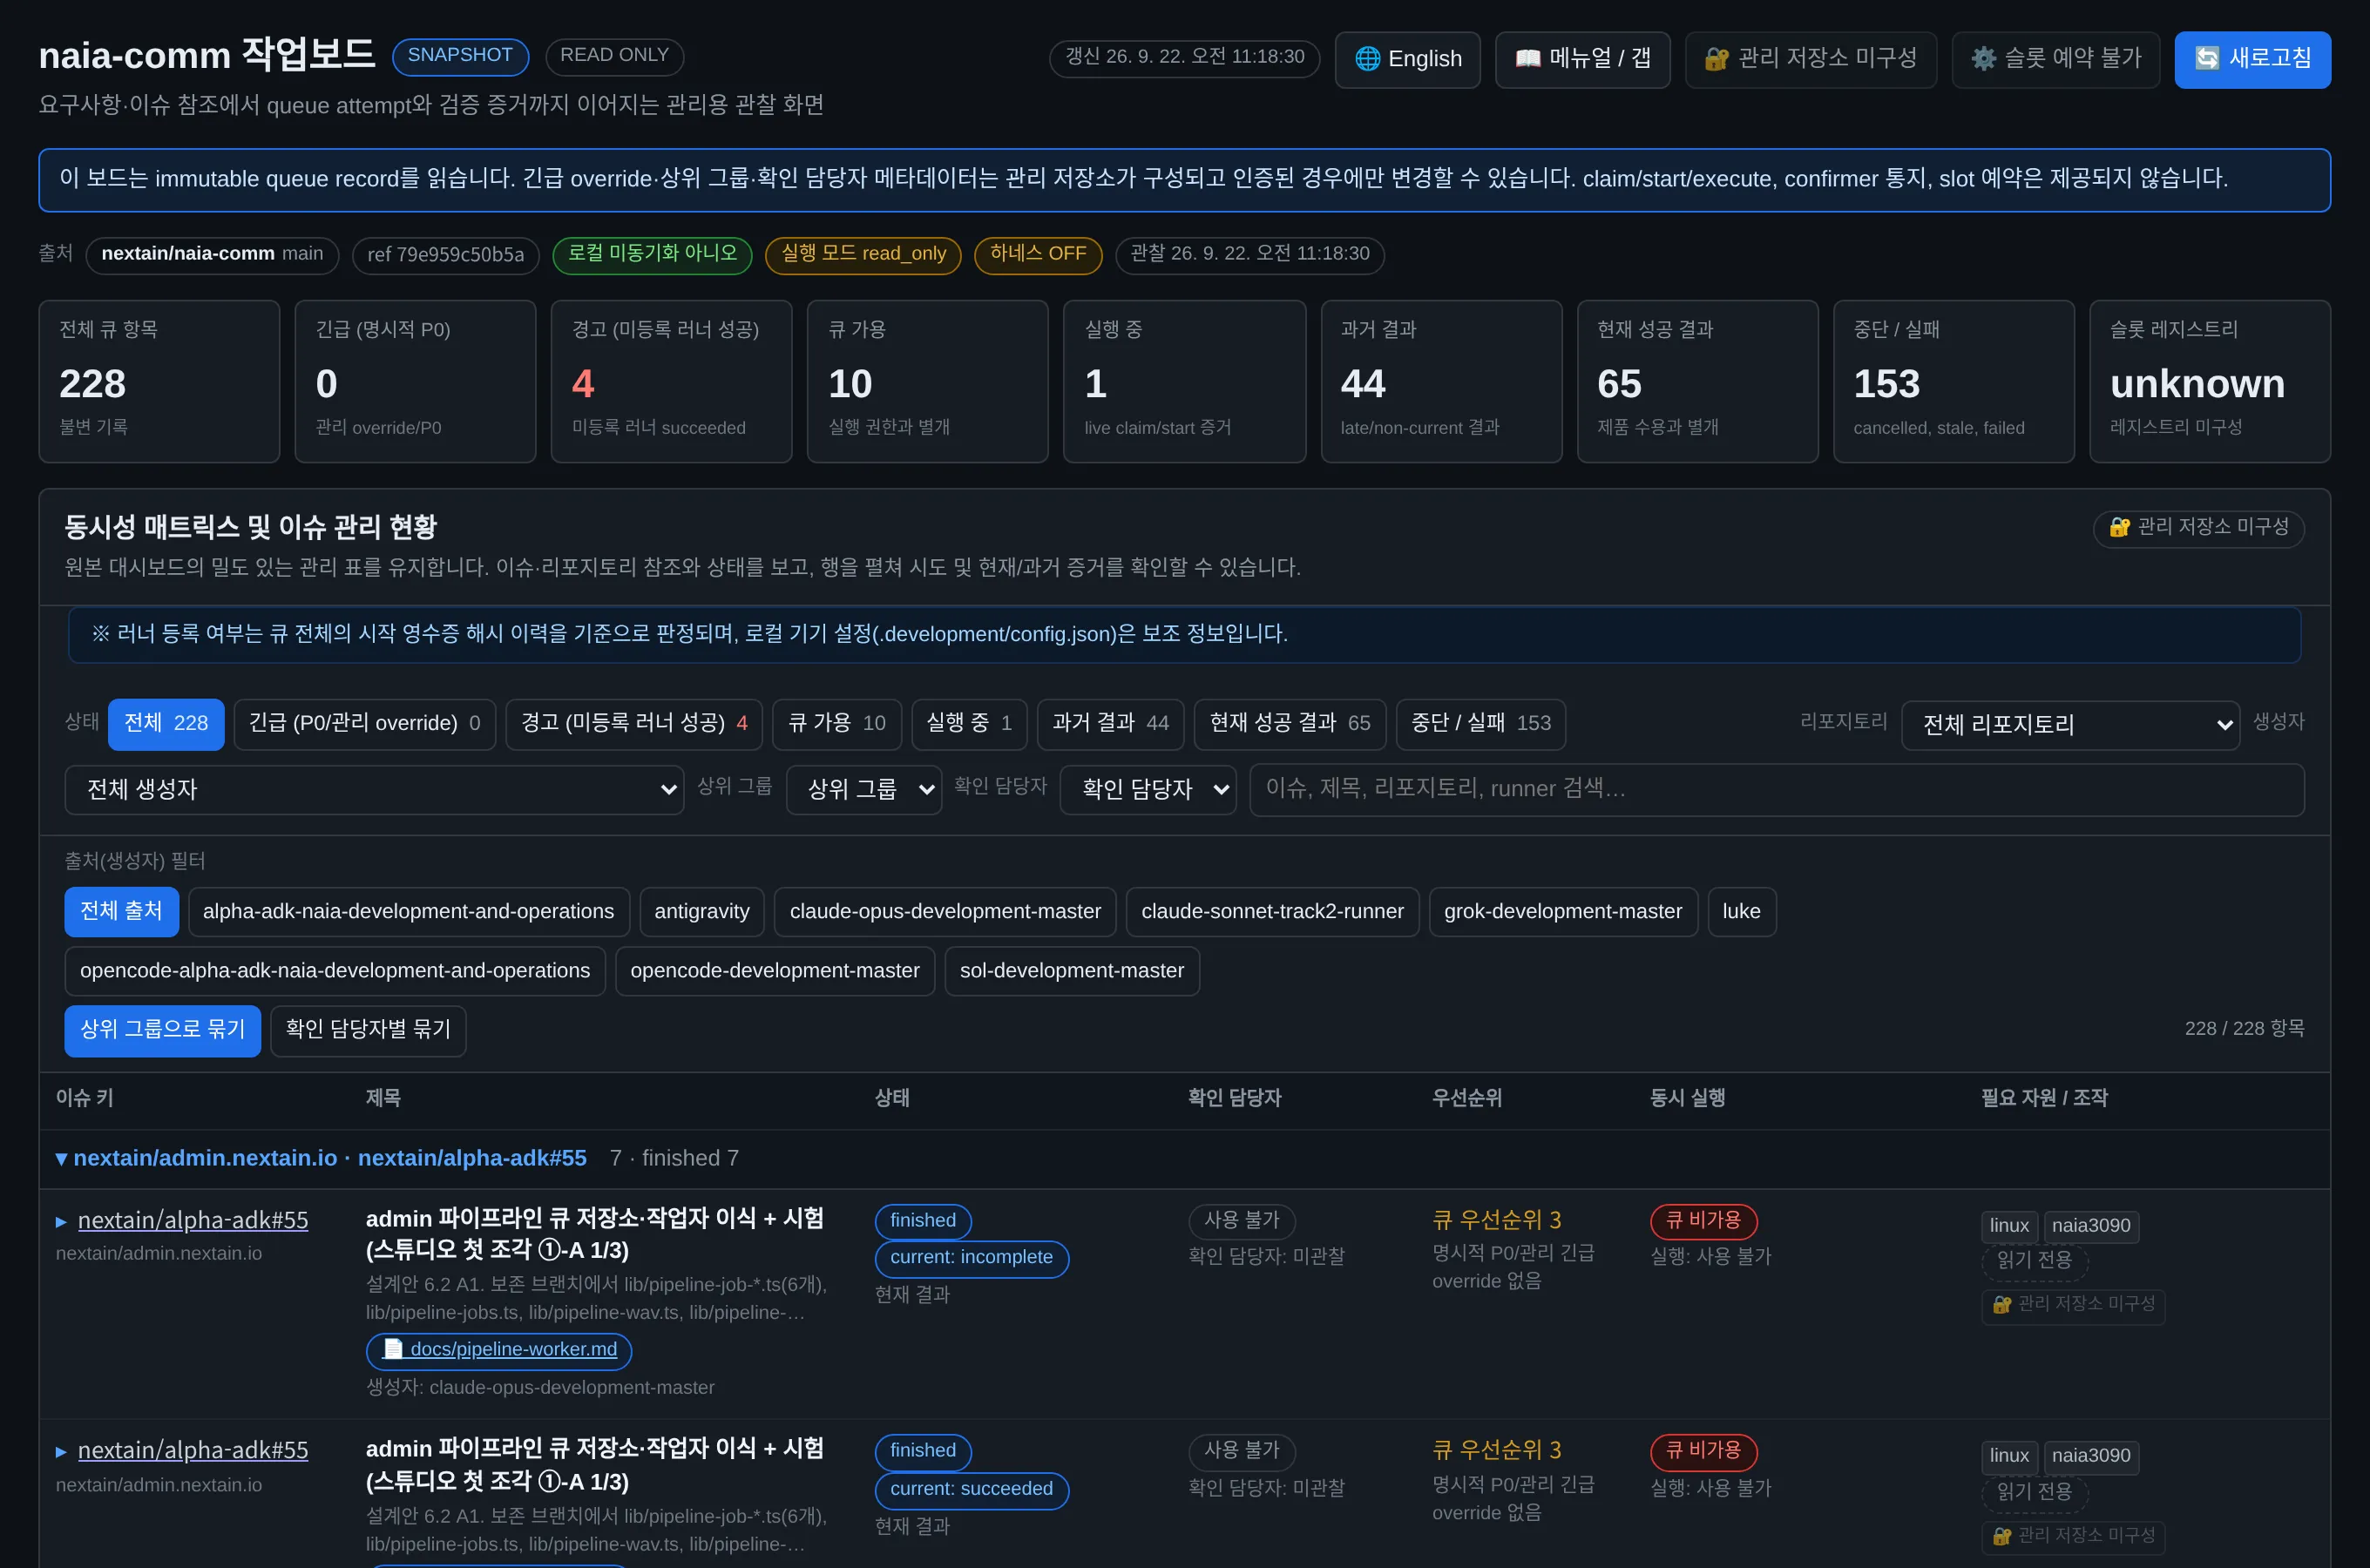 Dies ist die Ansicht des Arbeitsboards (interne URLs sind unkenntlich gemacht). Die oberen Kennzahlen aggregieren die Warteschlangenprotokolle des main-Branches von naia-comm: Zum Aufnahmezeitpunkt waren von 228 Aufgabenelementen 10 verfügbar, 1 in Ausführung und 65 aktuell erfolgreiche Ergebnisse, wobei 4 erfolgreiche Einträge von nicht registrierten Runner-Namen mit Warnungen versehen waren.
5. Arbeitsregelsystem und Struktur der Multi-Agenten-Zusammenarbeit
Das Arbeitsregelsystem bezeichnet die durch Dokumente festgelegten Regeln und deren Überprüfungsverfahren. Automatische Kontrollmechanismen sind derzeit im Wiederherstellungsmodus deaktiviert („HARNESS OFF“ auf dem Board), und schrankenartige Code-Sperren existieren noch nicht, sodass Arbeitsverträge des Koordinators, Überwachungsskripte und unabhängige Reviews die Einhaltung der Regeln sicherstellen.
Setzt man ausschließlich Spitzenmodelle ein, steigen die Kosten drastisch; nutzt man nur Leichtgewichtsmodelle, scheitern Entwurf und Validierung, was das Projekt gefährdet. Daher verteilen wir die Modelle je nach Aufgabencharakteristik und lassen sie sich gegenseitig überprüfen.
| Rolle | Zuständiges Modell | Ausführungsmodus und Aufgaben |
|---|---|---|
| Analyse und Entwurfsplanung | Claude Fable | Gesamtsystem-Kontextanalyse, Erstellung technischer Analyse- und Architekturpläne (PL), Entwurf von Prozessvalidierungsplänen |
| Aufgabenkoordination (Master) | Claude Opus | Gesamte Aufgabenverteilung und Ablaufsteuerung; überwacht Agenten ohne direkten Produktcode zu schreiben |
| Code-Implementierung und Test | Gemini 3.8 Flash | Führt Befehlszeilenwerkzeuge (CLI, Command-Line Interface) dialogfrei aus (unbeaufsichtigte Ausführung für Runner-Betrieb ausgelegt). Tests übernimmt eine separate Flash-Sitzung |
| Adversarielles Review | Claude Opus | Jede Runde in frischer Sitzung eingesetzt; führt quellbasierte unabhängige Recherchen durch, gleicht Einreichungen ab und deckt Mängel auf, die Schlussfolgerungen verändern |
| Runner-Code-Implementierung | Claude Sonnet | Wird von einem anderen Modell implementiert, um zu verhindern, dass Arbeiter (agy) Code schreiben, der ihre eigenen Rechte erweitert (wie z. B. der Runner-Aufruf von agy-Arbeitern mit pauschaler automatischer Genehmigung) |
※ Die Modellverteilung befindet sich in der Erprobung und kann angepasst werden.
Durch Kosteneffizienz und Privilegientrennung werden umfangreiche Implementierungen und Testiterationen Gemini 3.8 Flash überlassen, um das Kontingent von Spitzenmodellen zu schonen, während geeignete Modelle für jede Rolle fortlaufend evaluiert werden. Da Arbeiter ihre eigenen Berechtigungen nicht selbst erweitern können, wird das Risiko verringert, dass Agenten sich eigenmächtig Rechte erteilen und Störungen verursachen. Da jedoch Fehler in dieser Funktion häufig dazu führen, dass Aufgaben in isolierten, blockierten Zuständen verharren, arbeiten wir kontinuierlich an Tests und Verbesserungen.
Beispielsweise greifen Standortprüfungen wie der „Abgleich des deklarierten Repository-Checkouts“ nur bei der Ausführung über den Runner und gelten nicht für direkt per Arbeitsauftrag gestartete Durchläufe.
6. Adversarielles Review auf Basis unabhängiger Recherche
Bevor der Prüfer eine Einreichung öffnet, untersucht er zunächst selbstständig die ursprünglichen Anweisungen, Repositories, Commits und Aufgabenwarteschlangen-Einträge, formuliert eigene Schlussfolgerungen und gleicht diese anschließend mit der Einreichung ab. Betrachtet man nur die Einreichung, übersieht man leicht falsche Prämissen oder unpassende Repositories. Jedes Mal prüft ein neuer Reviewer; erst wenn zwei Runden in Folge keine Beanstandungen auftreten, die die Schlussfolgerung verändern, gilt der Durchlauf als bestanden. Wiederholt sich eine Schleife trivialer Beanstandungen, wird gestoppt und die Entscheidung an einen Menschen eskaliert.
7. Beobachtete Erfolge und Grenzen
Beobachtete Erfolge
Es hat sich eine funktionierende Struktur etabliert, in der ein kostengünstiges Modell (Gemini 3.8 Flash) Aufgaben über nicht-interaktive Befehlszeilensitzungen implementiert, der Koordinator über Arbeitsverträge und Überwachungsskripte die Grenzen überwacht und Spitzenmodelle in jeder Runde in einer frischen Sitzung nach unabhängiger Recherche den Abgleich vornehmen. Überwachungsskripte machen die vom Arbeiter ausgeführten Befehle im Nachhinein sichtbar, und der Prüfer ist strukturell in der Lage, vom Arbeiter behauptete falsche Tatsachen aufzudecken.
Beobachtete Grenzen und Schwachstellen
Günstige und leistungsschwächere Modelle neigen häufig dazu, Vorgaben zu missachten. Sie melden Aufgaben mit nicht existierenden Warteschlangen-IDs als abgeschlossen, fügen unaufgefordert Ausnahmeklauseln in Verfahrensdokumente ein oder verändern bei Zusammenfassungen unbemerkt ursprüngliche Bedingungen. Testsitzungen prüfen lediglich, ob das Skript durchläuft, können jedoch nicht unterscheiden, ob der Test tatsächlich gegen das reale Backend ausgeführt wurde.
Obwohl unabhängige Reviews solche Mängel herausfiltern, sind die Verifizierungskosten hoch, da ein erheblicher Arbeitsaufwand übergeordneter Review-Modelle für mechanische Faktenprüfungen gebunden wird. Dies ist auch der Grund, warum wir die passende Modellzusammensetzung für jede Rolle weiterhin intensiv testen.
8. Verifizierungseffizienz durch Jev und zukünftige Aufgaben
Um den Prüfaufwand zu verringern, haben wir die Validierung in drei Schichten unterteilt. In der zweiten Schicht führen wir derzeit technische Validierungen durch, um den Einsatz von Jev zu prüfen, das sich durch niedrige Kosten und hohe Geschwindigkeit auszeichnet.
- Erste Schicht, mechanische Prüfung (Skripte): Dinge, die lediglich einen simplen Abgleich erfordern: Bestehen/Nichtbestehen von Testbelegen (0 Fehler, Exit-Code 0), URL-Antworten, Vorhandensein von Dateien.
- Zweite Schicht, Typbeurteilung (Jev): Wenn Integrationstests (IT) und E2E-Belege „bestanden“ ausweisen, feststellen, ob der Test tatsächlich über das reale Backend lief oder lediglich Mock-Objekte durchlief. Da Unit-Tests (UT) ohnehin Mocks verwenden dürfen, fallen sie nicht darunter.
- Dritte Schicht, Richtungsbeurteilung (Spitzenmodelle und Menschen): Ob Umfang und Absicht übereinstimmen.
Jev ist ein Entscheidungsmodell von TypeSafe AI, ein kostengünstiges Modell, das schnell und ausschließlich anhand vorgegebener Auswahlmöglichkeiten und Wahrscheinlichkeiten antwortet. Da Softwareentwicklung viele Auswahlprobleme beinhaltet, lässt sich durch kontinuierliche Messung ein geeigneter Schwellenwert (Threshold) finden, um Kosten- und Geschwindigkeitsvorteile zu erzielen. Dies ist ein Optimierungsansatz, der in der traditionellen KI-Softwareentwicklung vor der Ära der LLMs weit verbreitet war; die Validierungsergebnisse stellen sich wie folgt dar.
Validierungsergebnisse
Indem Jev-Entscheidungen nur dann übernommen werden, wenn das Vertrauensmaß bei 0,85 oder höher liegt und auch bei abweichender Formulierung dieselbe Antwort resultiert – während der Rest an große Sprachmodelle (LLMs) übergeben wird –, konnten wir anhand von 871 Testdateien (257 in der Endauswertung) messen und schätzen, dass der Zeitaufwand um ca. 66 % und die Kosten um ca. 60–70 % gesenkt werden können (Zeit gemessen im Vergleich zu Gemini 3.8 Flash; Kosten geschätzt auf Basis der Einheitspreise von Modellen wie Opus und Luna).
| Entscheidungsmethode | Von Jev bearbeitete Dateien | Fehlantworten | Benötigte Zeit (im Vergleich zu reinem LLM-Einsatz) |
|---|---|---|---|
| Nur LLM verwendet | 0% | Referenz | 100% |
| Aktuelle Regel (Vertrauen >= 0,85 + gleiche Antwort bei anderer Formulierung) | Ca. 72% | 0 Fälle bei Dateien mit Konsens beider KIs | 34% (48% bei paralleler Ausführung zu je 4) |
| Bei Absenkung der Schwelle auf 0,59 | Ca. 89% | Um 1,8%p gestiegen | 17% |
Die Kosten für 971 Jev-Aufrufe beliefen sich auf 0,22 Dollar; eine Entscheidung dauerte bei Jev ca. 0,7 Sekunden, während ein LLM ca. 12 Sekunden benötigte.
Optimale Werte ermitteln wir kontinuierlich durch eine Ausweitung der Experimente. Das Potenzial ist bestätigt, der Ansatz ist jedoch noch nicht in den produktiven Entwicklungsprozess integriert. Da als korrekte Antworten nur Fälle herangezogen wurden, bei denen beide KIs übereinstimmten, könnte das Ergebnis zu einfacheren Dateien hin verzerrt sein.
Zukünftige Aufgaben
Mit diesem Verfahren wurde die erste Funktion des Studios (Eingabe eines Skripts zur Erzeugung, zum Anhören und Herunterladen von Sprache) vom Backend bis zum Nutzerreise-Durchdringungstest abgeschlossen. Zu den verbleibenden Aufgaben gehört es, die Validierung weiter zu automatisieren und Regeln, die derzeit von Menschen und Arbeitsaufträgen durchgesetzt werden, durch Werkzeuge verbindlich zu machen. Zudem planen wir ein separates Experiment, um zu untersuchen, ob Jev neben der Validierungsmarkierung auch für die Ablaufsteuerung eingesetzt werden kann, um bei Abschluss einer Aufgabe die nächste auszuwählen. Diese Ablaufentscheidung erfordert derzeit für jede Aufgabe den Aufruf eines Spitzenmodells, was einen wesentlichen Kosten- und Latenzfaktor darstellt.
Ich hoffe, dass die geteilten Inhalte hilfreich sind. Bitte schenken Sie auch den Produkten von Naia Ihre Aufmerksamkeit. Eigentlich müssten wir rasch Produkte veröffentlichen und Erfolge vorweisen, um den nächsten Schritt zu machen, doch wir verbringen weiterhin sehr viel Zeit mit den anspruchsvollen Steuerungs- und Entwicklungsmethoden für KI.
