Proceso de desarrollo multi-IA guiado por documentación en Naia ADK: probando la eficiencia con Jev
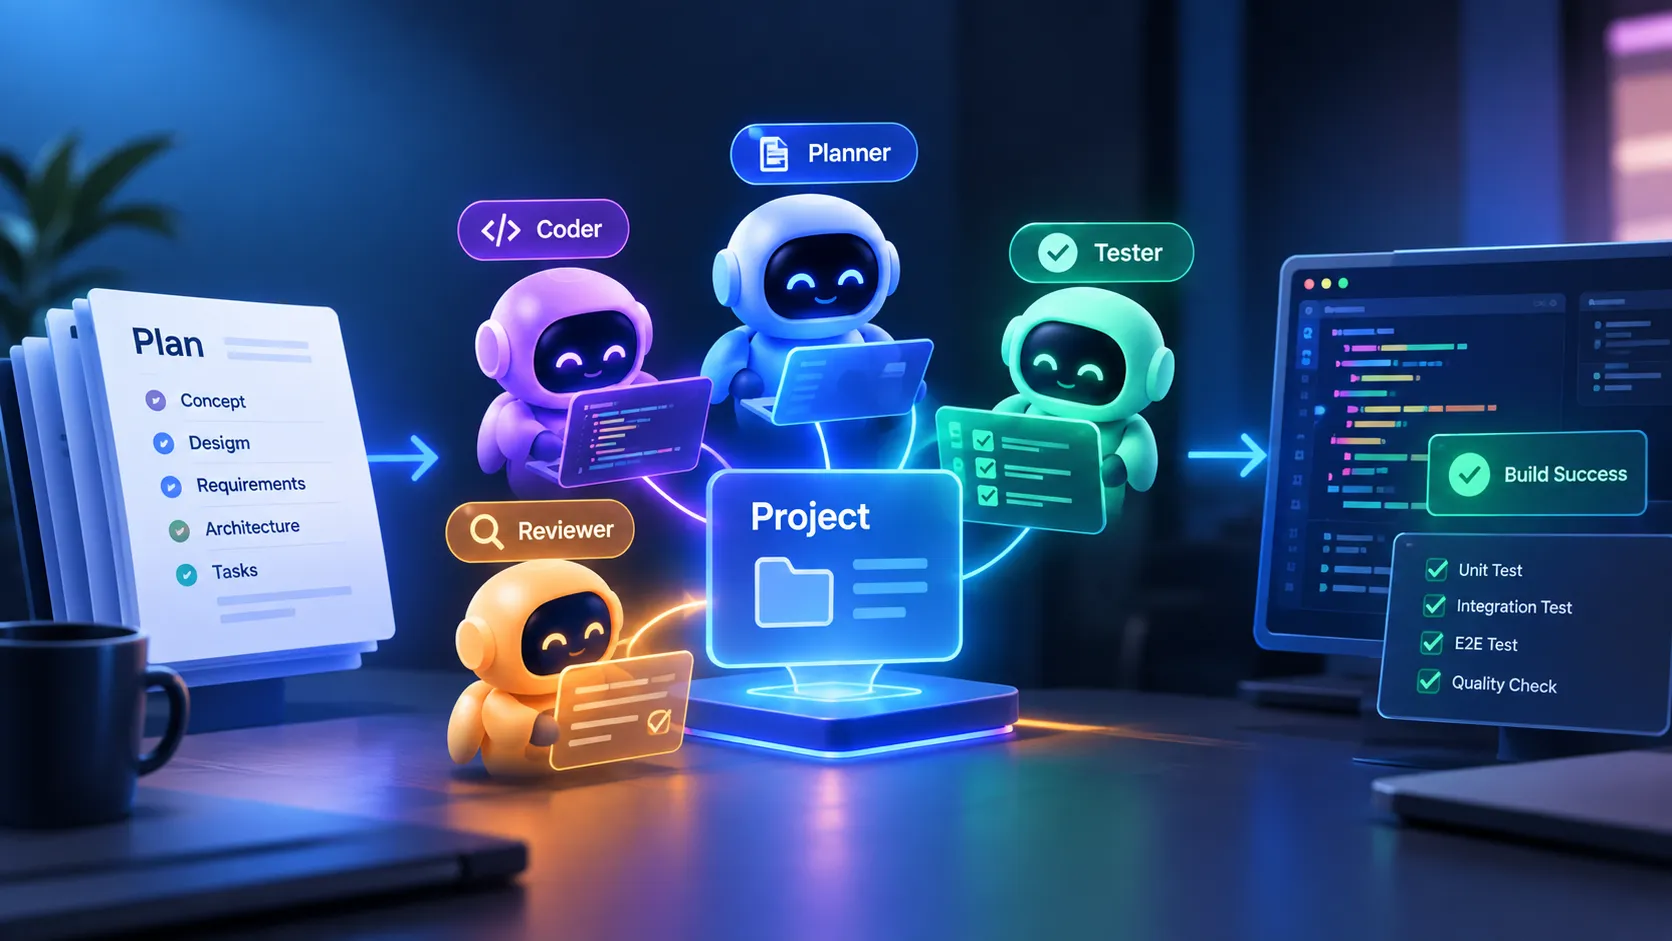 Hola. Soy Luke, creador de Naia.
Naia puede parecer un producto para usuarios finales centrado en agentes de personajes, pero gran parte de mi trabajo diario consiste en el desarrollo de software. Por ello, construimos la infraestructura de desarrollo correspondiente y llevamos a cabo el desarrollo de software para clientes empresariales utilizando la infraestructura de desarrollo de Naia. Anteriormente, publiqué un libro titulado «Harness Engineering: Ingeniería de software con IA desde Re:Zero» (edición en coreano, edición en inglés). Desde entonces, continuamos dedicando grandes esfuerzos a consolidar aún mejor un proceso de desarrollo basado en agentes de IA.
Hoy comparto el proceso de desarrollo de software y los artefactos creados para el desarrollo de Naia, así como la manera en que estamos intentando incorporar Jev, un modelo de decisión muy popular recientemente, en dicho proceso de desarrollo.
Los tres objetivos que busqué perseguir en este proceso de desarrollo fueron: visibilidad, paralelización y optimización de costes.
- Visibilidad : Saber si se está desarrollando correctamente y, en caso de deriva del modelo, identificar exactamente en qué etapa se produjo el problema.
- Paralelización : Distribuir tareas en paralelo entre múltiples agentes para aumentar la velocidad de desarrollo.
- Optimización de costes : Utilizar modelos optimizados en costes. Jev representa una excelente alternativa en este ámbito.
La estructura básica de nuestro sistema de reglas de trabajo (Harness) está publicada como código abierto a continuación:
- Estructura básica del espacio de trabajo personal y sistema de reglas de trabajo (Harness): nextain/naia-adk
- Estructura básica para colaboración en equipo y proyectos: nextain/naia-pj-adk
- Guía de participación en la comunidad: nextain/naia-comm-public
- Jev es un modelo de decisión publicado por TypeSafe AI.
La cola de tareas, el panel, el runner y los documentos de planificación descritos en este artículo aún se encuentran en fase de desarrollo interno y permanecen privados. En la actualidad, este proceso también se encuentra en fase de validación y se está probando en una nueva funcionalidad que debutará en la web de Naia: el desarrollo de Naia Visual Agent Studio, un avatar en vídeo capaz de sincronización labial y canto. El motivo de no hacerlo público todavía es que aún no está suficientemente pulido para ser utilizado conjuntamente en proyectos de equipo; lo iremos abriendo adicionalmente a medida que se organice.
Abreviaturas utilizadas en este artículo y en nuestros documentos de desarrollo
En primer lugar, nuestros documentos de desarrollo, incidencias y colas de tareas utilizan las siguientes abreviaturas y disponen de un glosario estándar del proyecto. Esto se introdujo porque resultaba tedioso escribir instrucciones largas a la IA y existía el riesgo de confusión terminológica.
| Abreviatura | Nombre completo | Término | Significado en una línea |
|---|---|---|---|
| PC | Product / Project Concept | Planificación de alto nivel | Por qué construimos: la esencia del producto, su razón de ser, valor de usuario y arquitectura general de información |
| SP | Screen Plan | Planificación de pantallas | Plano estructural de las pantallas que verá el usuario (maquetación, disposición, navegación) |
| UC | User Scenario | Recorrido de usuario (User Scenario) | El recorrido completo en el que un usuario entra bajo cierto contexto, logra su objetivo y sale |
| RQ | Requirements | Requisitos | Condiciones y criterios de aceptación medibles que el sistema debe cumplir para satisfacer UC y SP |
| PL | Plan / Architecture | Análisis técnico y plan de diseño | Confirmar la realidad técnica mediante mediciones reales y establecer la arquitectura y planes de implementación por fases |
| FE | FEature | Especificación funcional | Unidades funcionales concretas que se crean para materializar UC y RQ. No es Frontend |
| UT | Unit Test | Prueba unitaria | Verificar que la unidad funcional opere según las especificaciones |
| IT | Integration Test | Prueba de integración | Prueba que penetra los componentes reales del backend de extremo a extremo sin interfaz. No es tecnología de la información (IT) |
| E2E | End-to-End Test | Prueba de recorrido de usuario de extremo a extremo | Prueba que penetra un recorrido de usuario completo desde la pantalla real hasta el backend real |
| QC | Quality Control / Validation | Validación independiente | Verificación agresiva de las promesas del producto basándose únicamente en PC y SP, sin consultar los guiones del desarrollador ni la implementación interna |
1. Contexto de adopción y detección de problemas
Si se delega ampliamente el desarrollo a los agentes de IA, estos tienden a crear la interfaz de usuario (UI, User Interface) sin disponer de un backend, o a reportar como aprobadas pruebas ejecutadas con objetos simulados (mocks). Por ello, llevamos a cabo la planificación de arriba hacia abajo (Top-down) y el desarrollo de abajo hacia arriba (Bottom-up). La planificación desciende desde la experiencia global del usuario, mientras que el desarrollo se construye a partir de la unidad funcional mínima, conectando la pantalla únicamente después de que el backend haya sido atravesado de forma real. Empezar por la pantalla conlleva una alta probabilidad de sufrir modificaciones masivas durante la integración.
2. Flujo de trabajo guiado por documentación y proceso de desarrollo
Redactar primero la documentación tiene como fin fijar con antelación el alcance de lo que se va a construir y los criterios de aceptación. Al documentar las directrices en lugar de limitarse a redactar simples prompts, es posible rastrear la causa raíz cuando surge un problema.
Desplegamos todos los documentos del proceso de desarrollo en una lista y, tras la confirmación humana, creamos las incidencias y los elementos de la cola de tareas. Antes de crear una nueva incidencia, la IA analiza a qué documentos se vincula y consulta las incidencias abiertas previamente. Solo cuando las incidencias, las colas y los recibos de pruebas están debidamente presentes se puede dictaminar la finalización de la tarea.
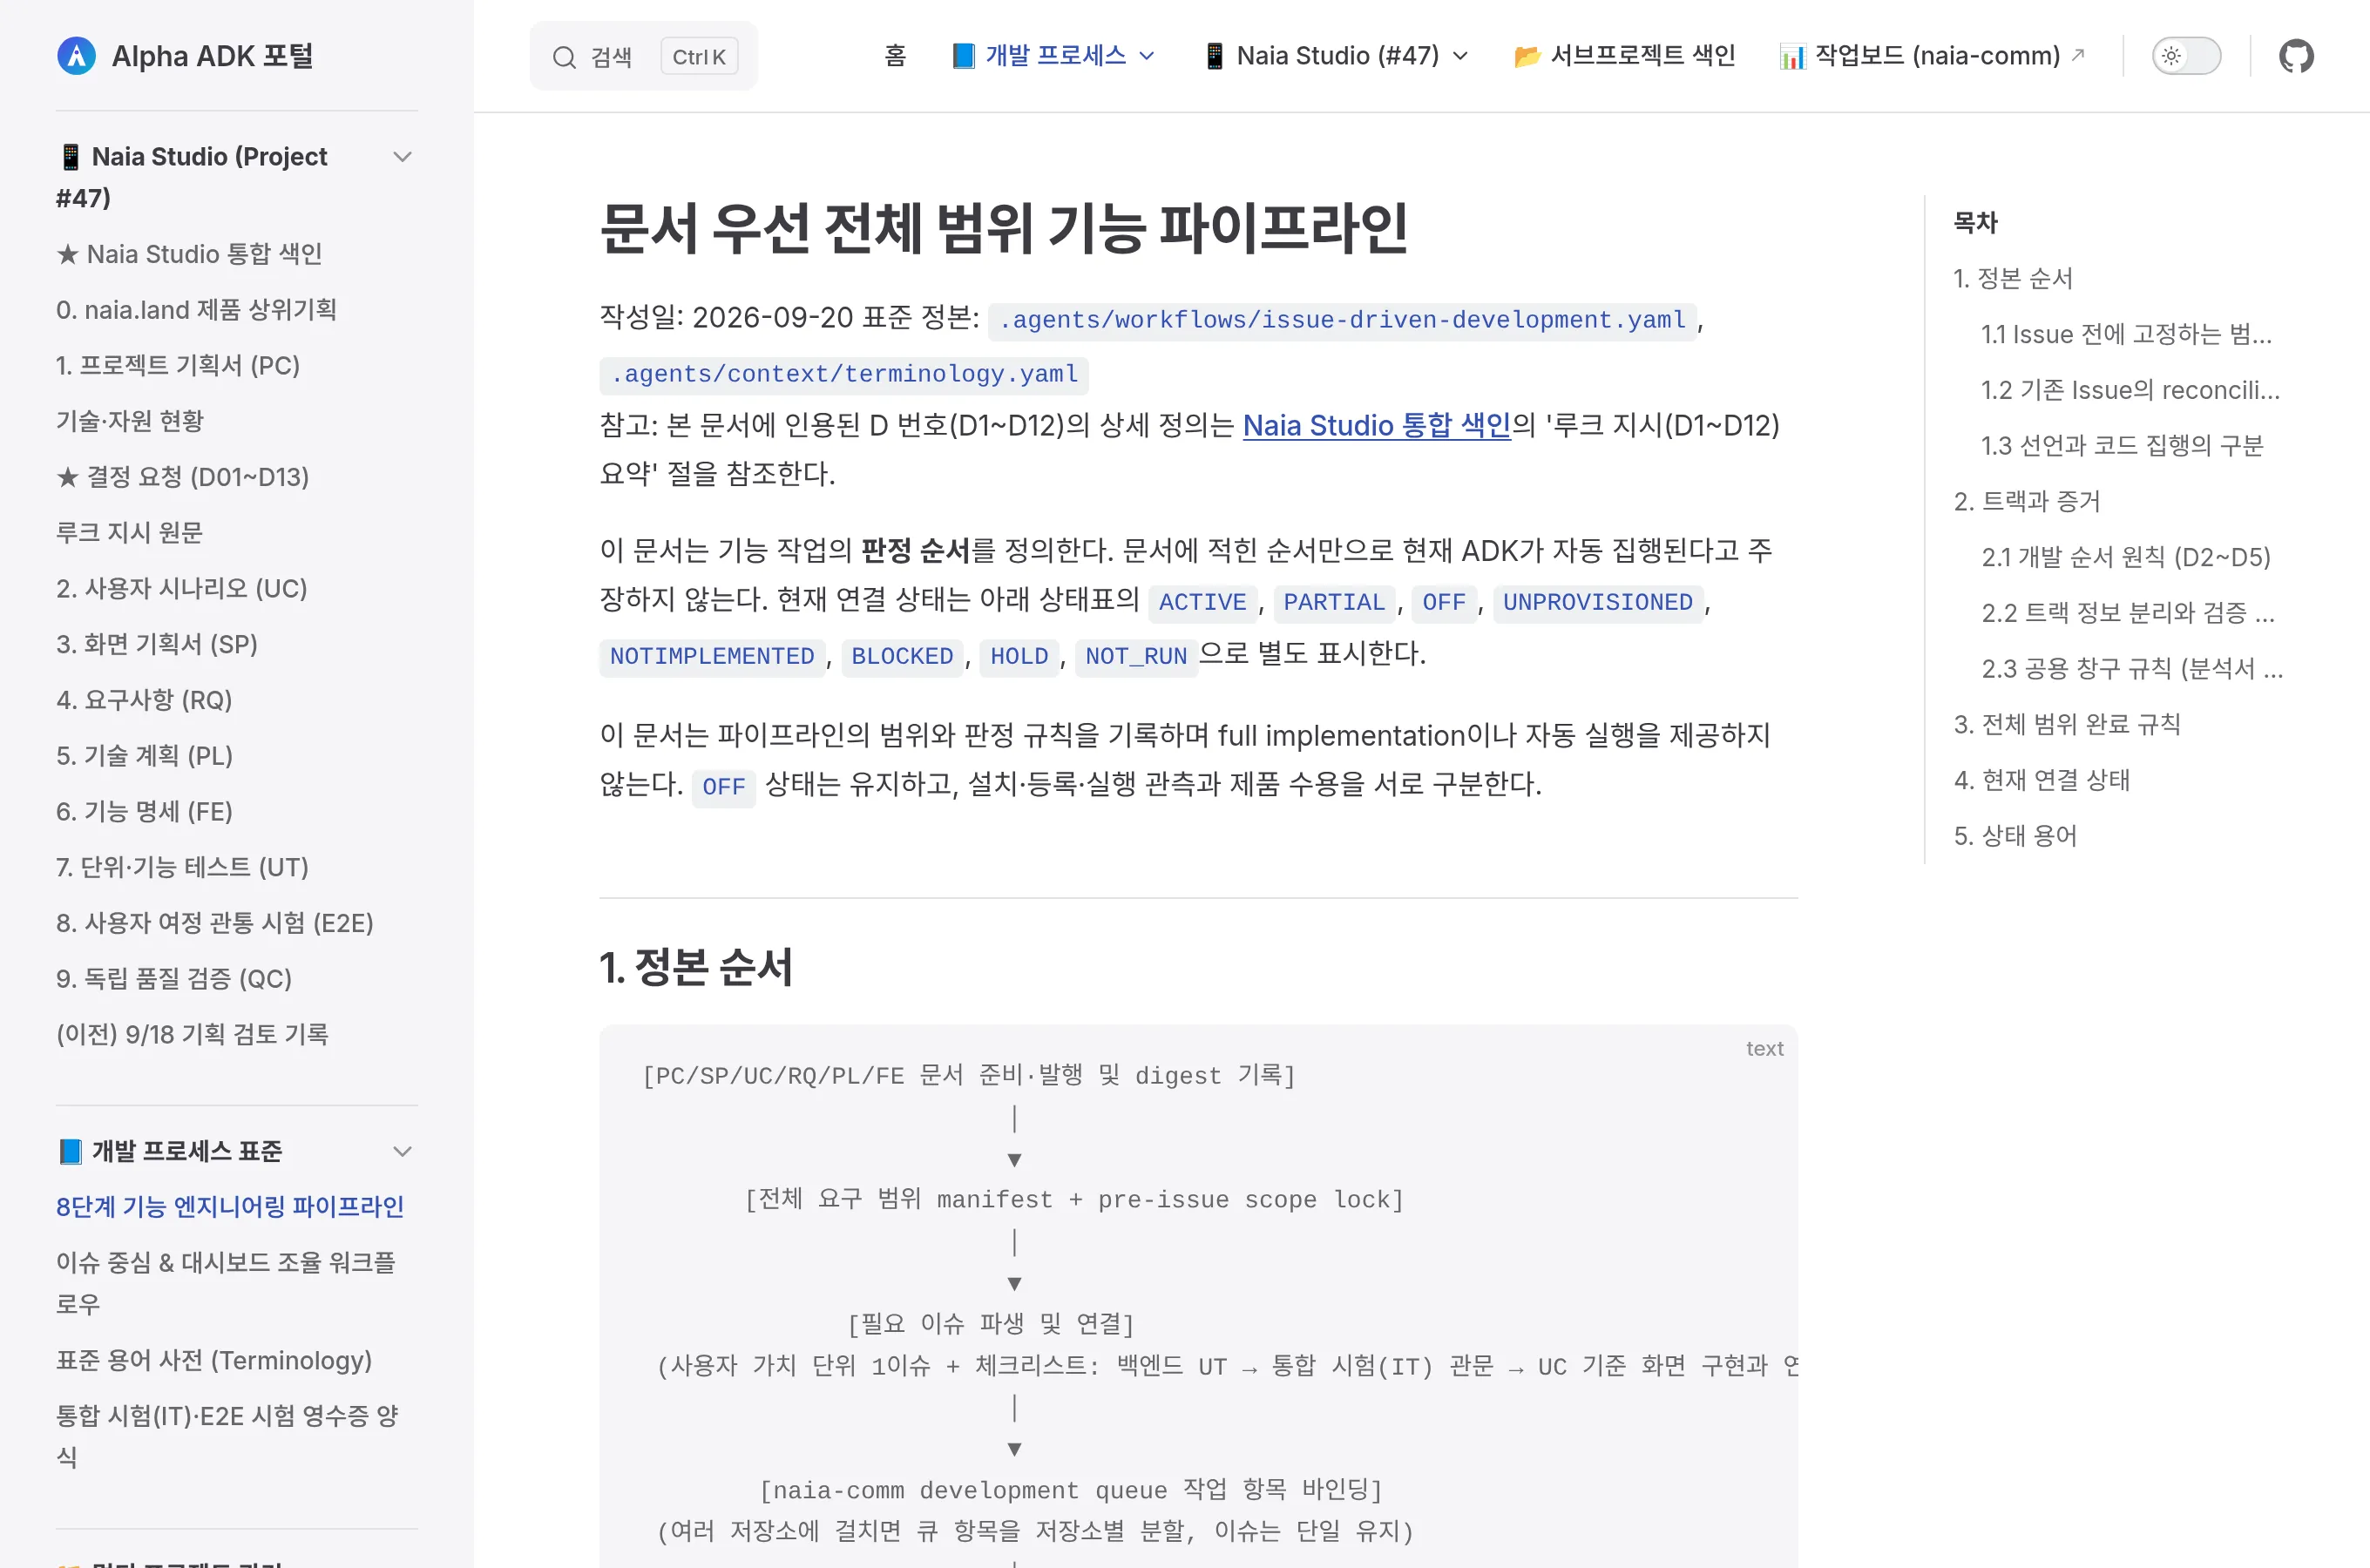 Página de procedimiento de desarrollo en el visor de documentos.
Los documentos descienden en el orden del diagrama, desde el porqué construimos (PC) hasta las unidades funcionales a construir (FE), y el diseño (PL) se establece únicamente después de haber medido previamente las limitaciones reales de modelos y motores. Las incidencias no se dividen por capas tecnológicas, sino que se asigna una sola por cada valor de usuario, incluso cuando abarcan múltiples repositorios. Los procesos desde el backend hasta la validación se designan como listas de verificación dentro de esa incidencia para no pasar nada por alto, y la finalización solo se determina cuando todo el alcance bloqueado por la documentación cuenta con pruebas demostrables.
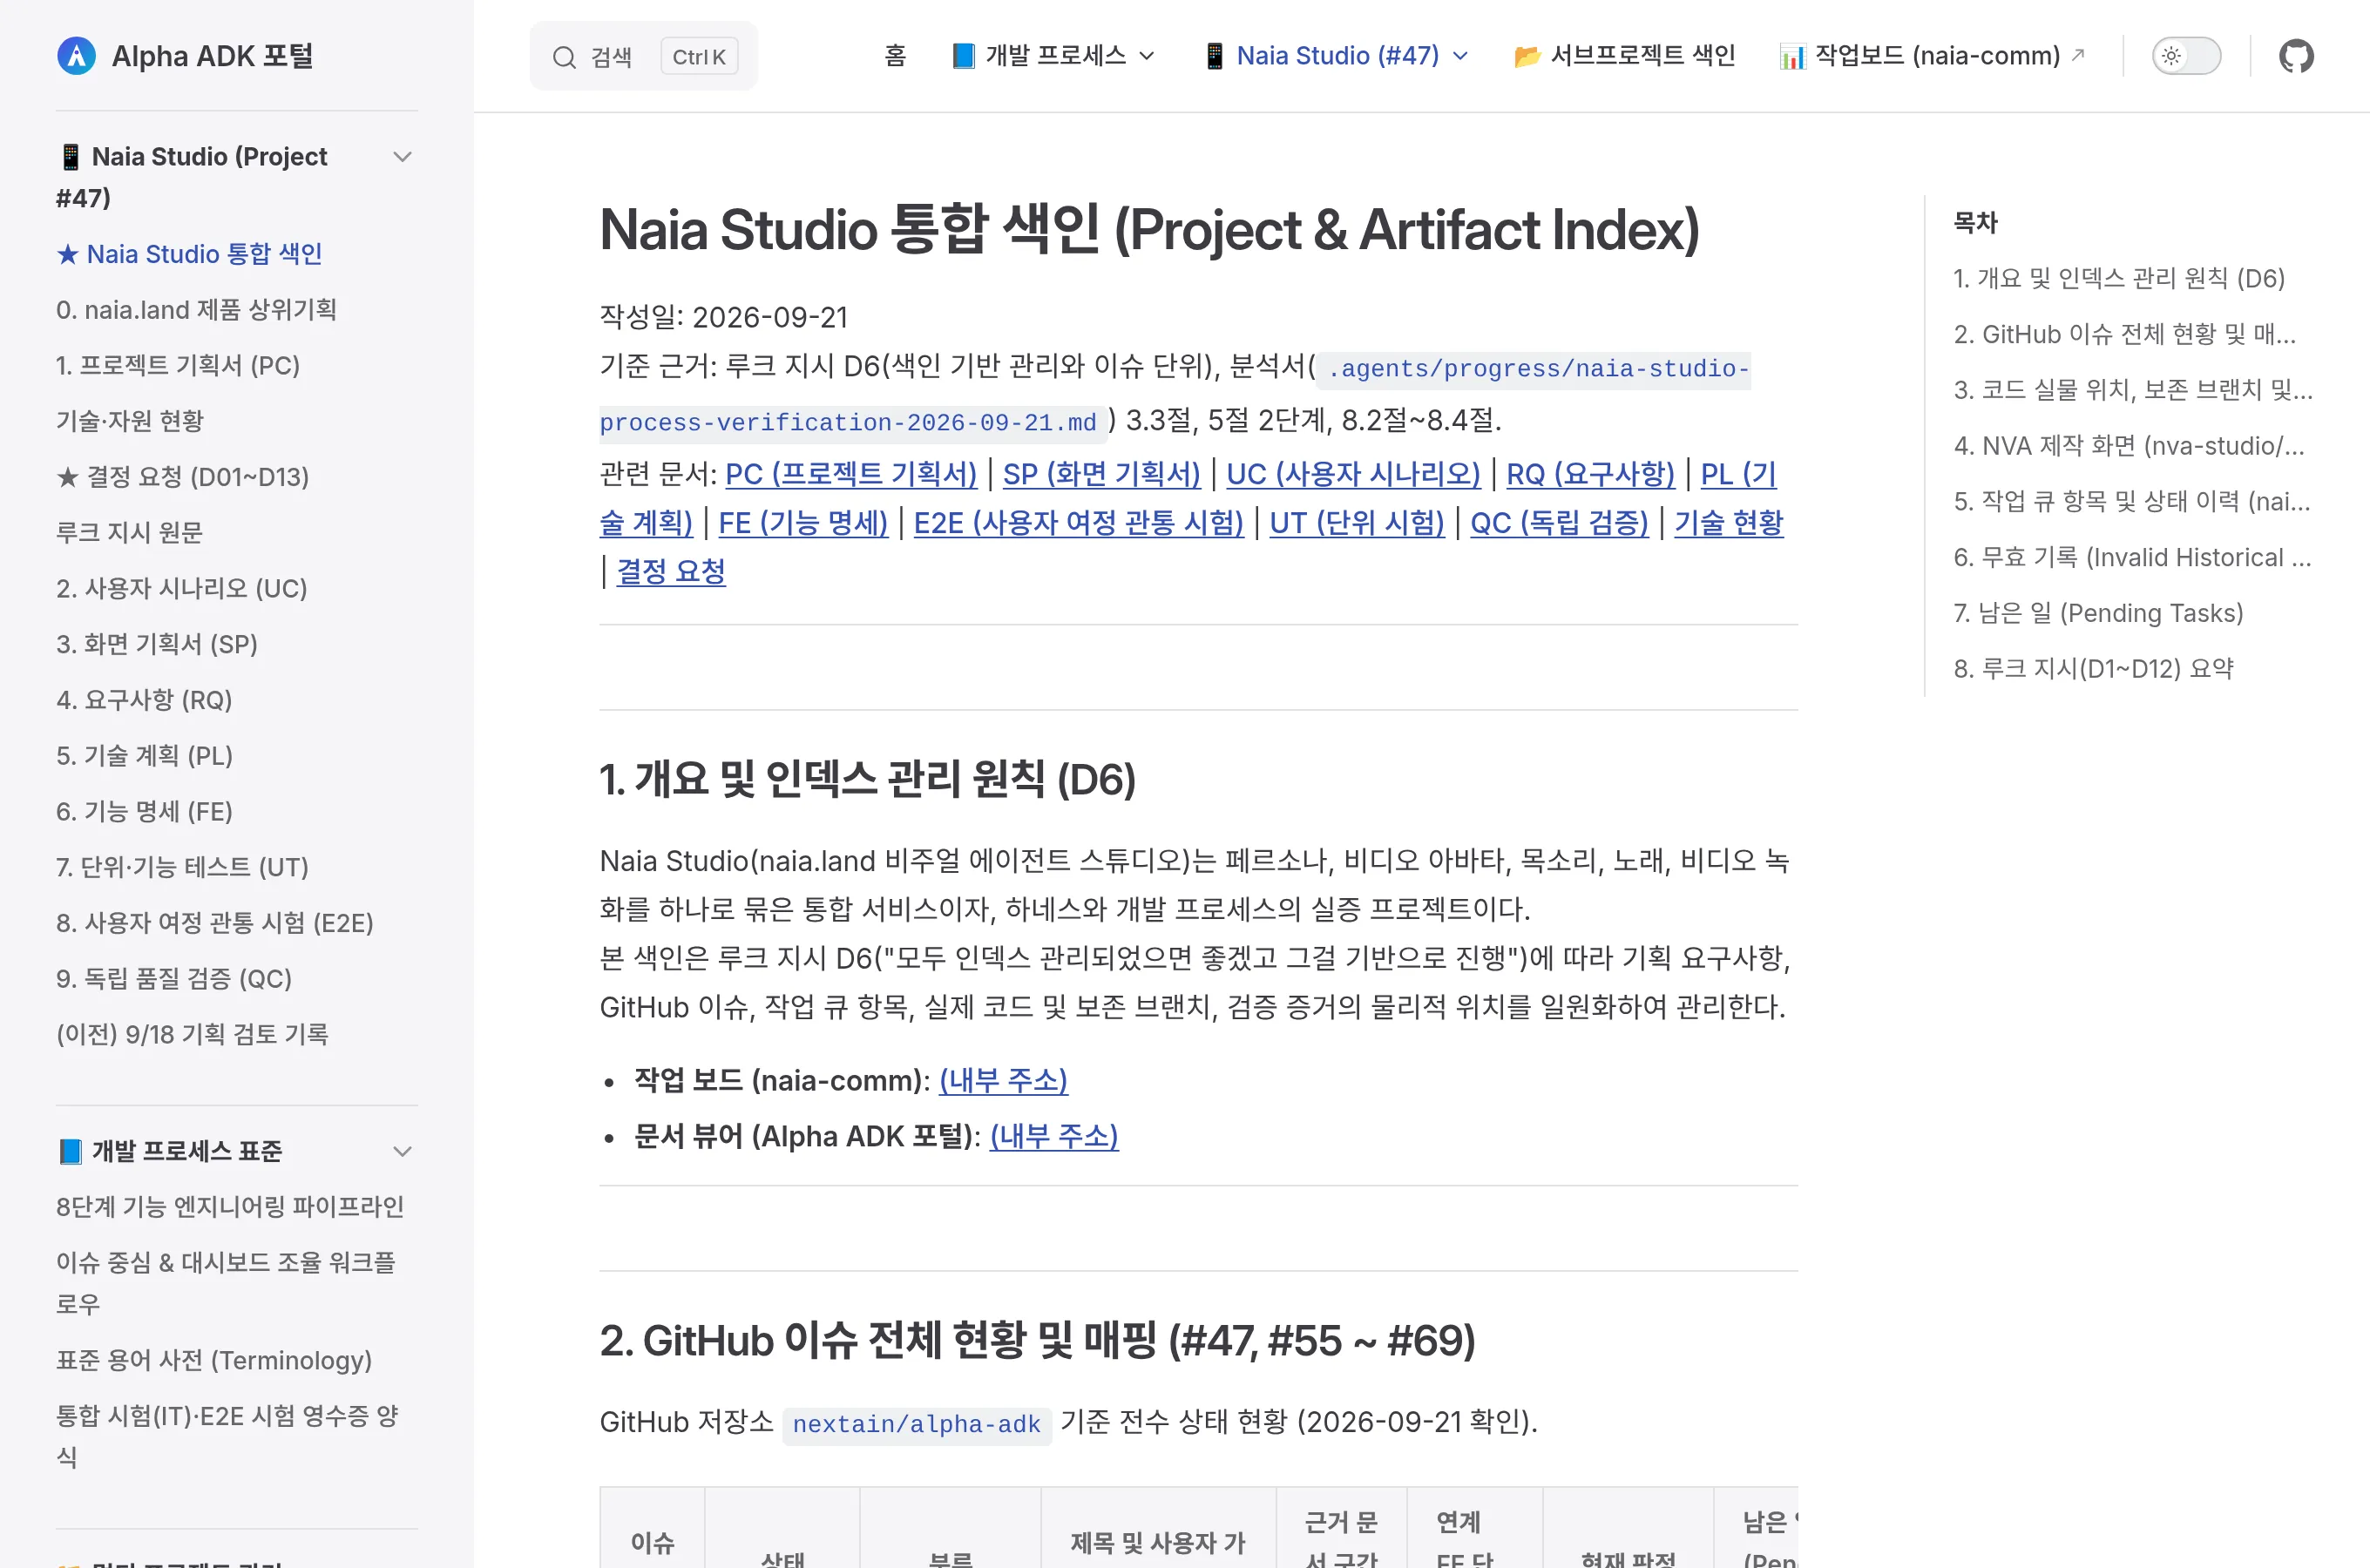 Índice integrado de Studio que muestra en un solo lugar las incidencias, ubicaciones de implementación y estados de dictamen de cada sección de los documentos de planificación.
3. Estructura de pruebas de tres niveles y reglas de secuencia
Las pruebas se dividen en tres niveles de acuerdo con las denominaciones estándar de la industria.
- Prueba unitaria (UT): Comprueba si la unidad funcional (FE) opera según las especificaciones.
- Prueba de integración (IT): Atraviesa los componentes reales del backend de principio a fin sin interfaz. No se reconocen las pruebas que únicamente pasaron por objetos simulados (mocks).
- Prueba de recorrido de usuario de extremo a extremo (E2E): Atraviesa un recorrido de usuario individual desde la pantalla real del navegador hasta el backend real. Solo las unidades que carecen de pantallas en el SP se cierran mediante pruebas de integración sin E2E; si existen pantallas, la E2E es obligatoria incluso si el cambio actual atañe únicamente al backend. El estándar es el SP, no el diff del desarrollador.
La clave reside en la secuencia: el frontend (pantalla) se desarrolla solo después de que el backend haya superado las pruebas de integración (IT). Actualmente, esta secuencia no está bloqueada mecánicamente por el Harness, sino que se verifica a través de contratos de trabajo y revisiones independientes mediante recibos, lo que deja margen de mejora.
La validación independiente (QC) se ejecuta al margen de las pruebas del desarrollador. Sin consultar UC ni FE, verifica de forma agresiva basándose únicamente en PC y SP si las promesas del producto se mantienen ante entradas forzadas y situaciones excepcionales. Si se consultaran UC y FE, existiría el riesgo de limitarse a comprobar únicamente ese alcance estrecho. Al situarse en una fase posterior del desarrollo, aún no se ha podido validar empíricamente a gran escala.
4. Cola de tareas basada en Git y panel de control
Para garantizar la fiabilidad sobre quién hizo qué y cuándo, las tareas se gestionan a través de una cola de tareas en un repositorio de Git (naia-comm). Todavía no disponemos de un servidor compartido; el objetivo es construir un servidor de desarrollo tras la validación, permitiendo la colaboración entre múltiples dispositivos y desarrolladores.
Cada dispositivo participante clona el repositorio y realiza pull periódicos para descubrir nuevas tareas y reportar registros de trabajo. La ejecución corre a cargo exclusivamente de los runners registrados localmente por el propietario del dispositivo (programas que recogen tareas de la cola y ejecutan la IA en su nombre); en la cola solo se anota el nombre del runner, sin incluir los comandos a ejecutar.
Cada etapa de una tarea se registra en un nuevo archivo JSON. En los recibos de resultado se escriben las pruebas de ejecución y los códigos de salida, y las cancelaciones se van anexando del mismo modo, registrando todas las operaciones para reforzar la trazabilidad. El panel de trabajo es simplemente una pantalla que vuelve a leer y mostrar estos registros cada vez que se solicita.
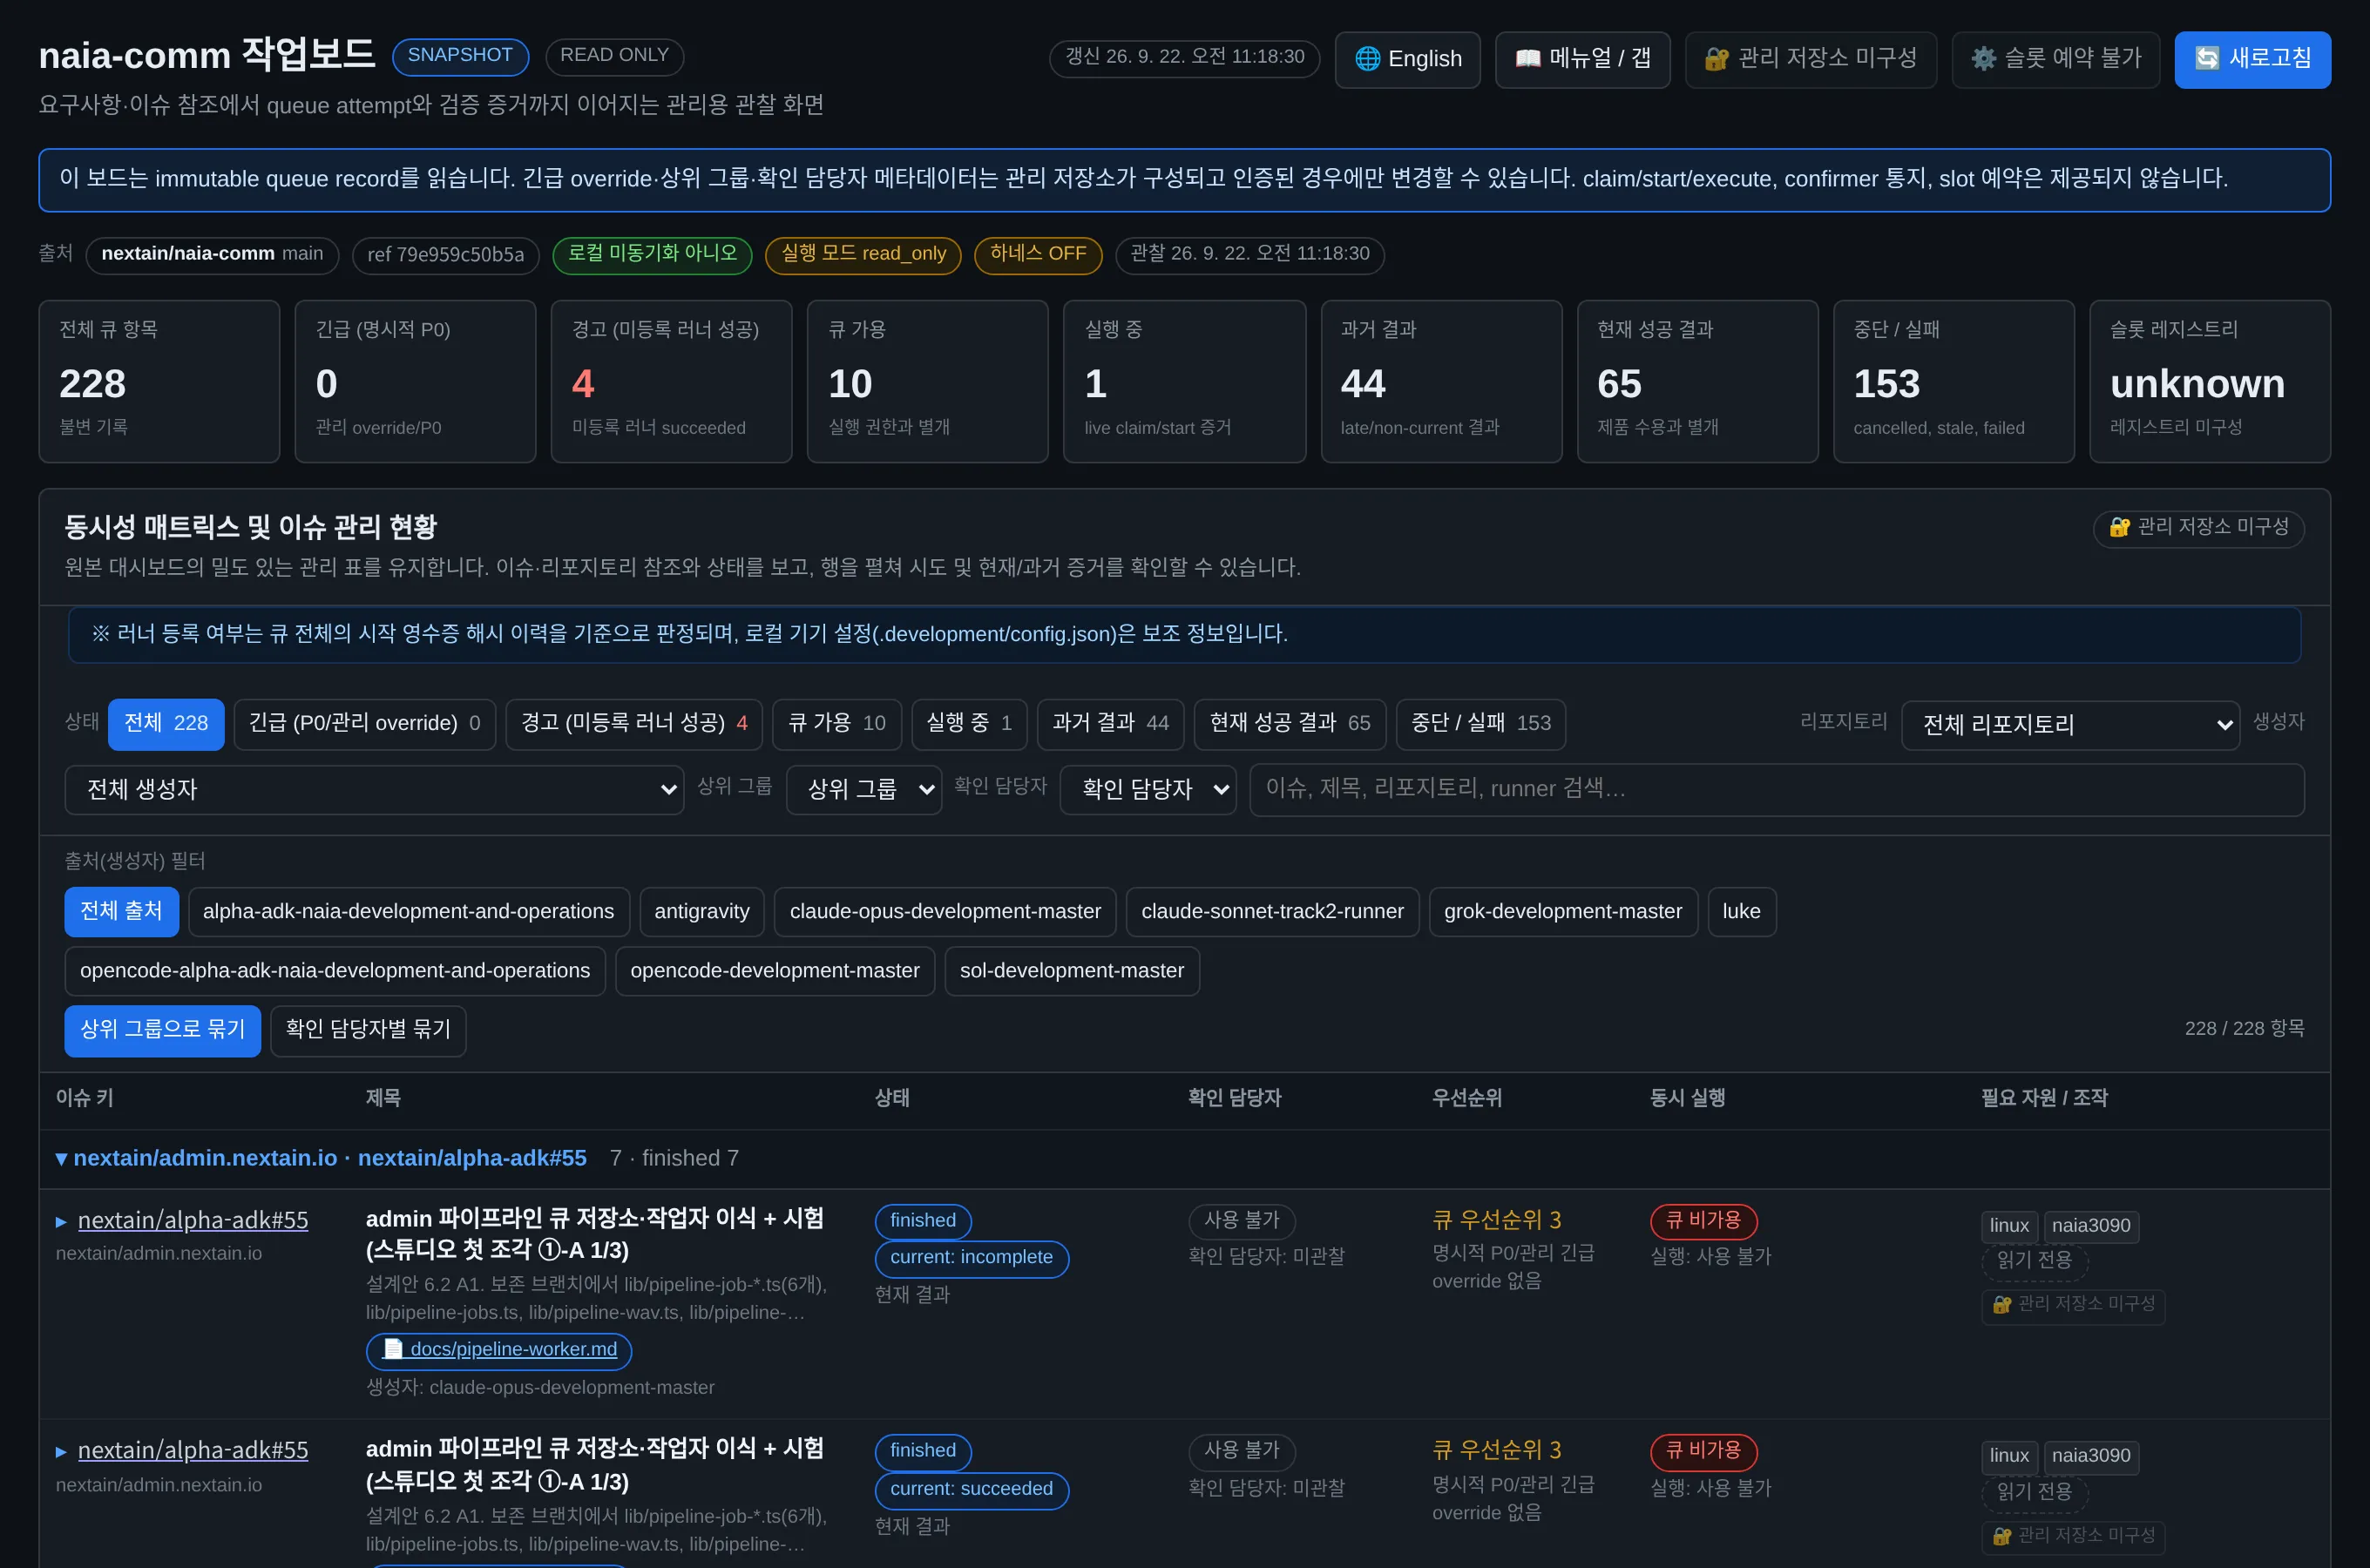 Esta es la pantalla del panel de control (las direcciones internas están ocultas). Los indicadores superiores agregan los registros de cola de la rama main de naia-comm: en el momento de la captura, de 228 elementos de tareas, 10 estaban disponibles, 1 en ejecución y 65 resultados actualmente exitosos, con advertencias añadidas a 4 registros exitosos procedentes de nombres de runner no registrados.
5. Sistema de reglas de trabajo y estructura de colaboración multiagente
El sistema de reglas de trabajo comprende las reglas establecidas mediante documentación y sus procedimientos de verificación. Los mecanismos de comprobación automática se encuentran desactivados actualmente en modo de recuperación («HARNESS OFF» en la pantalla del panel), y aún no existen barreras basadas en código que bloqueen las reglas, por lo que los contratos de trabajo del coordinador, los scripts de monitorización y las revisiones independientes aseguran el cumplimiento de las normas.
Utilizar únicamente modelos superiores dispara enormemente los costes, mientras que usar solo modelos ligeros conduce a fallos en el diseño y la validación, arruinando el proyecto. Por ello, asignamos los modelos en función del carácter de la tarea y hacemos que se validen mutuamente.
| Rol | Modelo asignado | Modo de ejecución y cometido |
|---|---|---|
| Análisis y plan de diseño | Claude Fable | Análisis de contexto global del sistema, formulación de planes de análisis técnico y arquitectura (PL), diseño de planes de validación de procesos |
| Coordinación de tareas (Master) | Claude Opus | Distribución global de tareas y control de flujo; supervisa agentes sin escribir directamente código de producto |
| Implementación de código y pruebas | Gemini 3.8 Flash | Ejecuta herramientas de línea de comandos (CLI, Command-Line Interface) sin diálogo (ejecución desatendida diseñada para pasar por el runner). Las pruebas corren a cargo de una sesión de Flash diferente a la de implementación |
| Revisión adversarial | Claude Opus | Desplegado en una sesión nueva en cada ronda; realiza investigaciones independientes basadas en fuentes originales y contrasta entregas, extrayendo defectos que alteran conclusiones |
| Implementación de código del runner | Claude Sonnet | Implementado por otro modelo para evitar que los trabajadores (agy) redacten código que amplíe sus propios privilegios, como invocar a los trabajadores agy con aprobación automática total |
※ La distribución de modelos se encuentra en fase experimental y puede cambiar.
Mediante la eficiencia de costes y la separación de privilegios, asignamos la mayor parte de las implementaciones e iteraciones de prueba a Gemini 3.8 Flash para preservar los límites de los modelos superiores, al tiempo que exploramos y ajustamos continuamente los modelos adecuados para cada rol. Los trabajadores no pueden ampliar sus propios permisos, lo que reduce el riesgo de que los agentes se concedan privilegios a sí mismos y provoquen problemas. Sin embargo, dado que los errores en esta función provocan con frecuencia que las tareas queden atascadas en estados aislados e inejecutables, seguimos realizando pruebas y mejoras de manera continuada.
Por ejemplo, las comprobaciones de ubicación como «coincidencia con el checkout del repositorio declarado» solo funcionan al pasar por el runner y no se aplican a ejecuciones iniciadas directamente a través de órdenes de trabajo.
6. Revisión adversarial basada en investigación independiente
Antes de abrir una entrega, el revisor investiga primero por su cuenta las instrucciones originales, el repositorio, los commits y los registros de la cola de tareas para redactar sus propias conclusiones y, a continuación, las coteja con la entrega. Basarse únicamente en la entrega expone a pasar por alto premisas erróneas o repositorios equivocados. En cada ocasión interviene un revisor nuevo, y se aprueba cuando no hay señalamientos que cambien las conclusiones durante dos rondas consecutivas. Si se repite un bucle de señalamientos triviales, el proceso se detiene y se traslada la decisión a un humano.
7. Logros observados y limitaciones
Logros observados
Se ha articulado una dinámica en la que un modelo de bajo coste (Gemini 3.8 Flash) implementa las tareas mediante sesiones de línea de comandos no conversacionales, el coordinador vigila los límites mediante contratos de trabajo y scripts de monitorización, y el modelo superior coteja los resultados tras una investigación independiente en una sesión nueva en cada ronda. Los scripts de monitorización muestran a posteriori los comandos ejecutados por el trabajador, y el revisor cuenta con la capacidad estructural de detectar afirmaciones falsas efectuadas por el trabajador.
Limitaciones observadas y vulnerabilidades
Los modelos económicos y de menor rendimiento tendieron a menudo a avanzar sin acatar las instrucciones. Registran identificadores de cola inexistentes y reportan tareas como completadas, insertan cláusulas de exención no solicitadas en los documentos de procedimiento o alteran sutilmente las condiciones originales al resumir. La sesión de pruebas solo comprueba si el script aprueba, sin ser capaz de discernir si dicha prueba se ejecutó realmente contra el backend real.
Aunque la revisión independiente filtra estos defectos, el coste de validación es elevado. Esto se debe a que gran parte del esfuerzo de los modelos de revisión superiores se destina a comprobaciones mecánicas de hechos. Esta es también la razón por la que seguimos probando continuamente configuraciones de modelos adecuadas para cada rol.
8. Eficiencia de validación mediante Jev y retos futuros
Para reducir la carga de revisión, intentamos dividir la validación en tres niveles. En el segundo nivel, nos encontramos actualmente en proceso de validación técnica para evaluar la introducción de Jev, que destaca por su bajo coste y alta velocidad.
- Primer nivel, comprobación mecánica (scripts): Elementos que solo requieren contraste simple: aprobado/fallido de recibos de pruebas (0 fallos, código de salida 0), respuesta de URLs, existencia de archivos.
- Segundo nivel, determinación de tipología (Jev): Cuando los recibos de pruebas de integración (IT) y E2E marcan «aprobado», discernir si la prueba atravesó verdaderamente el backend real o si solo superó objetos simulados. Las pruebas unitarias (UT) admiten originalmente simulaciones, por lo que no son objeto de esta evaluación.`
- Tercer nivel, juicio de orientación (modelos superiores y humanos): Evaluar si el alcance y la intención coinciden.
Jev es un modelo de decisión desarrollado por TypeSafe AI, un modelo de bajo coste que responde rápidamente limitándose a opciones y probabilidades predeterminadas. Dado que el desarrollo de software contiene muchos problemas de elección, mediante mediciones continuas se puede encontrar un umbral adecuado (Threshold) para lograr eficiencia en coste y velocidad. Este era un método de optimización ampliamente utilizado en el desarrollo tradicional de software con IA antes de los LLM, y los resultados de validación son los siguientes.
Resultados de la validación
Adoptando las decisiones de Jev solo cuando la confianza es igual o superior a 0,85 y ofrece la misma respuesta incluso al cambiar la formulación de la pregunta —delegando el resto a modelos de lenguaje grandes (LLM)—, en 871 archivos de prueba (257 en la evaluación final), medimos y estimamos que el tiempo puede reducirse en torno al 66% y los costes en torno al 60~70% (tiempo medido en comparación con Gemini 3.8 Flash; costes estimados según el precio unitario de modelos como Opus y Luna).
| Método de decisión | Archivos gestionados por Jev | Respuestas erróneas | Tiempo requerido (vs. uso exclusivo de LLM) |
|---|---|---|---|
| Solo LLM | 0% | Referencia | 100% |
| Regla actual (Confianza >= 0,85 + misma respuesta con distinta redacción) | Aprox. 72% | 0 casos en archivos con consenso de ambas IA | 34% (48% ejecutando 4 en paralelo) |
| Al rebajar el umbral a 0,59 | Aprox. 89% | Aumenta 1,8%p | 17% |
El coste de 971 llamadas a Jev fue de 0,22 dólares, y una decisión de Jev tomó aproximadamente 0,7 segundos en comparación con los aproximadamente 12 segundos requeridos por un LLM.
Continuamos buscando los valores óptimos mediante la ampliación de experimentos. Aunque se ha confirmado su potencial, aún no se ha integrado en el proceso de desarrollo real. Dado que como respuestas correctas solo se utilizaron aquellas en las que ambas IA coincidían, es posible que los resultados se encuentren sesgados hacia archivos más sencillos.
Retos futuros
A través de este procedimiento, la primera funcionalidad de Studio (introducir un guion para generar, escuchar y descargar voz) ha sido completada desde el backend hasta las pruebas de recorrido de usuario de extremo a extremo. Los retos restantes consisten en automatizar aún más la validación y lograr que las herramientas hagan cumplir las reglas que hoy mantienen las personas y las órdenes de trabajo. Asimismo, planeamos realizar un experimento independiente para comprobar si Jev puede emplearse no solo para la marca de validación, sino también para el control de flujo al elegir la siguiente tarea cuando finaliza una. Este criterio de flujo requiere actualmente invocar un modelo superior en cada tarea, lo que supone un coste y una latencia considerables.
Espero que el contenido compartido resulte de ayuda. Les agradeceríamos mucho su interés en los productos de Naia. Deberíamos lanzar productos rápidamente y demostrar logros para pasar a la siguiente etapa, pero siento que seguimos dedicando gran parte del tiempo al control meticuloso y a las metodologías de desarrollo de una IA tan exigente.
