Naia ADK में दस्तावेज़-संचालित मल्टी-AI विकास प्रक्रिया: Jev के साथ दक्षता का परीक्षण
 नमस्ते। मैं Naia का निर्माता ल्यूक (Luke) हूँ।
Naia आम उपयोगकर्ताओं के लिए एक कैरेक्टर एजेंट उत्पाद की तरह लग सकता है, लेकिन मेरे दैनिक कार्यों का एक बड़ा हिस्सा सॉफ़्टवेयर विकास का है। इसलिए हम इसके लिए विकास अवसंरचना का निर्माण करते हैं और Naia के विकास बुनियादी ढांचे का उपयोग करके कॉर्पोरेट ग्राहकों के लिए सॉफ़्टवेयर विकास संचालित करते हैं। इससे पहले मैंने "हार्नेस इंजीनियरिंग: Re:Zero से शुरू होने वाली AI सॉफ़्टवेयर इंजीनियरिंग" (कोरियाई संस्करण, अंग्रेज़ी संस्करण) शीर्षक से एक पुस्तक प्रकाशित की थी। इसके बाद से भी, हम AI एजेंट-आधारित विकास प्रक्रिया को और बेहतर ढंग से स्थापित करने के लिए निरंतर प्रयासरत हैं।
आज, मैं Naia के विकास के लिए तैयार की गई सॉफ़्टवेयर विकास प्रक्रिया और इसके आउटपुट को साझा कर रहा हूँ, और यह बता रहा हूँ कि हम इस विकास प्रक्रिया में हाल ही में लोकप्रिय हुए निर्णय मॉडल Jev को कैसे शामिल करने का प्रयास कर रहे हैं।
इस विकास प्रक्रिया में मेरे मुख्य रूप से 3 लक्ष्य थे: दृश्यता (Visibility), समानांतरकरण (Parallelization), और लागत अनुकूलन (Cost Optimization)।
- दृश्यता : यह जानना कि विकास ठीक से हो रहा है या नहीं, और यदि मॉडल ड्रिफ्ट होता है, तो समस्या किस चरण में उत्पन्न हुई है।
- समानांतरकरण : विकास की गति बढ़ाने के लिए कई एजेंटों को समानांतर में कार्य सौंपना।
- लागत अनुकूलन : लागत-अनुकूलित मॉडलों का उपयोग करना। Jev यहाँ एक बेहतरीन विकल्प साबित होता है।
कार्य नियम प्रणाली (Harness) का मूल ढांचा नीचे ओपन सोर्स के रूप में सार्वजनिक रूप से उपलब्ध है:
- व्यक्तिगत कार्यक्षेत्र का मूल ढांचा और कार्य नियम प्रणाली (Harness): nextain/naia-adk
- टीम एवं परियोजना सहयोग हेतु मूल ढांचा: nextain/naia-pj-adk
- समुदाय भागीदारी गाइड: nextain/naia-comm-public
- Jev, TypeSafe AI द्वारा जारी किया गया एक निर्णय मॉडल है।
इस लेख में वर्णित कार्य कतार (Task Queue), बोर्ड, रनर और योजना दस्तावेज़ अभी भी आंतरिक विकास के अधीन हैं और निजी हैं। वर्तमान में यह प्रक्रिया भी एक सत्यापन चरण में है, जिसका परीक्षण Naia के वेब प्लेटफ़ॉर्म पर शुरू होने वाली नई सुविधा: लिप-सिंक और गायन में सक्षम वीडियो अवतार, Naia Visual Agent Studio के विकास में किया जा रहा है। इसे अभी सार्वजनिक न करने का कारण यह है कि यह अभी टीम प्रोजेक्ट में संयुक्त उपयोग के लिए पूरी तरह परिष्कृत नहीं हुआ है; व्यवस्थित होते ही इसे अतिरिक्त रूप से जारी किया जाएगा।
इस लेख और हमारे विकास दस्तावेज़ों में प्रयुक्त संक्षिप्ताक्षर
सबसे पहले, हमारे विकास दस्तावेज़ों, मुद्दों (Issues) और कार्य कतारों में निम्नलिखित संक्षिप्ताक्षरों का उपयोग किया जाता है और इस परियोजना का एक मानक शब्दावली शब्दकोश है। इसका कारण यह था कि AI को निर्देश देते समय लंबे वाक्य टाइप करना असुविधाजनक था और शब्दावली के भ्रम की आशंका थी।
| संक्षिप्ताक्षर | पूरा नाम | पद / शब्द | एक पंक्ति में अर्थ |
|---|---|---|---|
| PC | Product / Project Concept | उच्च-स्तरीय योजना | हम इसे क्यों बना रहे हैं: उत्पाद का सार, अस्तित्व का कारण, उपयोगकर्ता मूल्य, समग्र सूचना वास्तुकला |
| SP | Screen Plan | स्क्रीन योजना | उपयोगकर्ता द्वारा देखी जाने वाली स्क्रीन का संरचनात्मक खाका (लेआउट, व्यवस्था, नेविगेशन) |
| UC | User Scenario | उपयोगकर्ता यात्रा (यूज़र सिनेरियो) | किसी संदर्भ में उपयोगकर्ता के प्रवेश, लक्ष्य प्राप्ति और बाहर निकलने की पूरी यात्रा |
| RQ | Requirements | आवश्यकताएं | UC और SP को पूरा करने के लिए सिस्टम द्वारा संतुष्ट की जाने वाली शर्तें और मापने योग्य स्वीकृति मानदंड |
| PL | Plan / Architecture | तकनीकी विश्लेषण और डिज़ाइन योजना | वास्तविक माप के माध्यम से तकनीकी वास्तविकताओं की पुष्टि करना और वास्तुकला व चरणबद्ध कार्यान्वयन योजना तैयार करना |
| FE | FEature | कार्यात्मक विनिर्देश | UC और RQ को साकार करने के लिए बनाई जाने वाली ठोस कार्यात्मक इकाइयाँ। यह फ्रंटएंड (Frontend) नहीं है |
| UT | Unit Test | इकाई परीक्षण (यूनिट टेस्ट) | यह सत्यापित करना कि कार्यात्मक इकाई विनिर्देशों के अनुसार काम करती है या नहीं |
| IT | Integration Test | एकीकरण परीक्षण (इंटीग्रेशन टेस्ट) | बिना UI के वास्तविक बैकएंड घटकों को अंत तक भेदने वाला परीक्षण। यह सूचना प्रौद्योगिकी (IT) नहीं है |
| E2E | End-to-End Test | उपयोगकर्ता यात्रा का पूर्ण परीक्षण | वास्तविक स्क्रीन से लेकर वास्तविक बैकएंड तक एकल उपयोगकर्ता यात्रा को भेदने वाला परीक्षण |
| QC | Quality Control / Validation | स्वतंत्र सत्यापन | डेवलपर की स्क्रिप्ट और आंतरिक कार्यान्वयन को देखे बिना केवल PC और SP के आधार पर उत्पाद के वादों की आक्रामक पुष्टि करना |
1. अपनाने की पृष्ठभूमि और समस्या की पहचान
यदि AI एजेंटों को विकास का काम व्यापक रूप से सौंप दिया जाए, तो वे बिना बैकएंड के सीधे उपयोगकर्ता इंटरफ़ेस (UI, User Interface) बनाना शुरू कर देते हैं, या मॉक ऑब्जेक्ट्स के साथ चलाए गए परीक्षणों को सफल घोषित कर देते हैं। इसलिए, हम योजना ऊपर से नीचे (Top-down) और विकास नीचे से ऊपर (Bottom-up) करते हैं। योजना समग्र उपयोगकर्ता अनुभव से नीचे की ओर बढ़ती है, जबकि विकास न्यूनतम कार्यशील इकाइयों से ऊपर की ओर बढ़ता है, और UI केवल तभी जोड़ा जाता है जब बैकएंड वास्तव में सफलतापूर्वक जुड़ जाए। स्क्रीन से शुरुआत करने पर एकीकरण के दौरान बड़े पैमाने पर बदलाव होने की संभावना बहुत अधिक होती है।
2. दस्तावेज़-संचालित कार्यप्रवाह और विकास प्रक्रिया
पहले दस्तावेज़ लिखने का उद्देश्य निर्माण के दायरे और स्वीकृति मानदंडों को पहले से तय करना है। केवल साधारण प्रॉम्प्ट देने के बजाय आवश्यकताओं का दस्तावेजीकरण करके, समस्या उत्पन्न होने पर मूल कारण का पता लगाया जा सकता है।
हम विकास प्रक्रिया के सभी दस्तावेज़ों को एक सूची में रखते हैं, और मानवीय पुष्टि के बाद ही इश्यू (Issue) और कार्य कतार आइटम बनाते हैं। नया इश्यू बनाने से पहले, AI जाँचता है कि यह इश्यू किन दस्तावेज़ों से जुड़ा है, और पहले से खुले इश्यूज़ को भी देखता है। केवल तभी कार्य को पूर्ण माना जा सकता है जब इश्यू, कतार और परीक्षण रसीदें सभी उचित रूप से मौजूद हों।
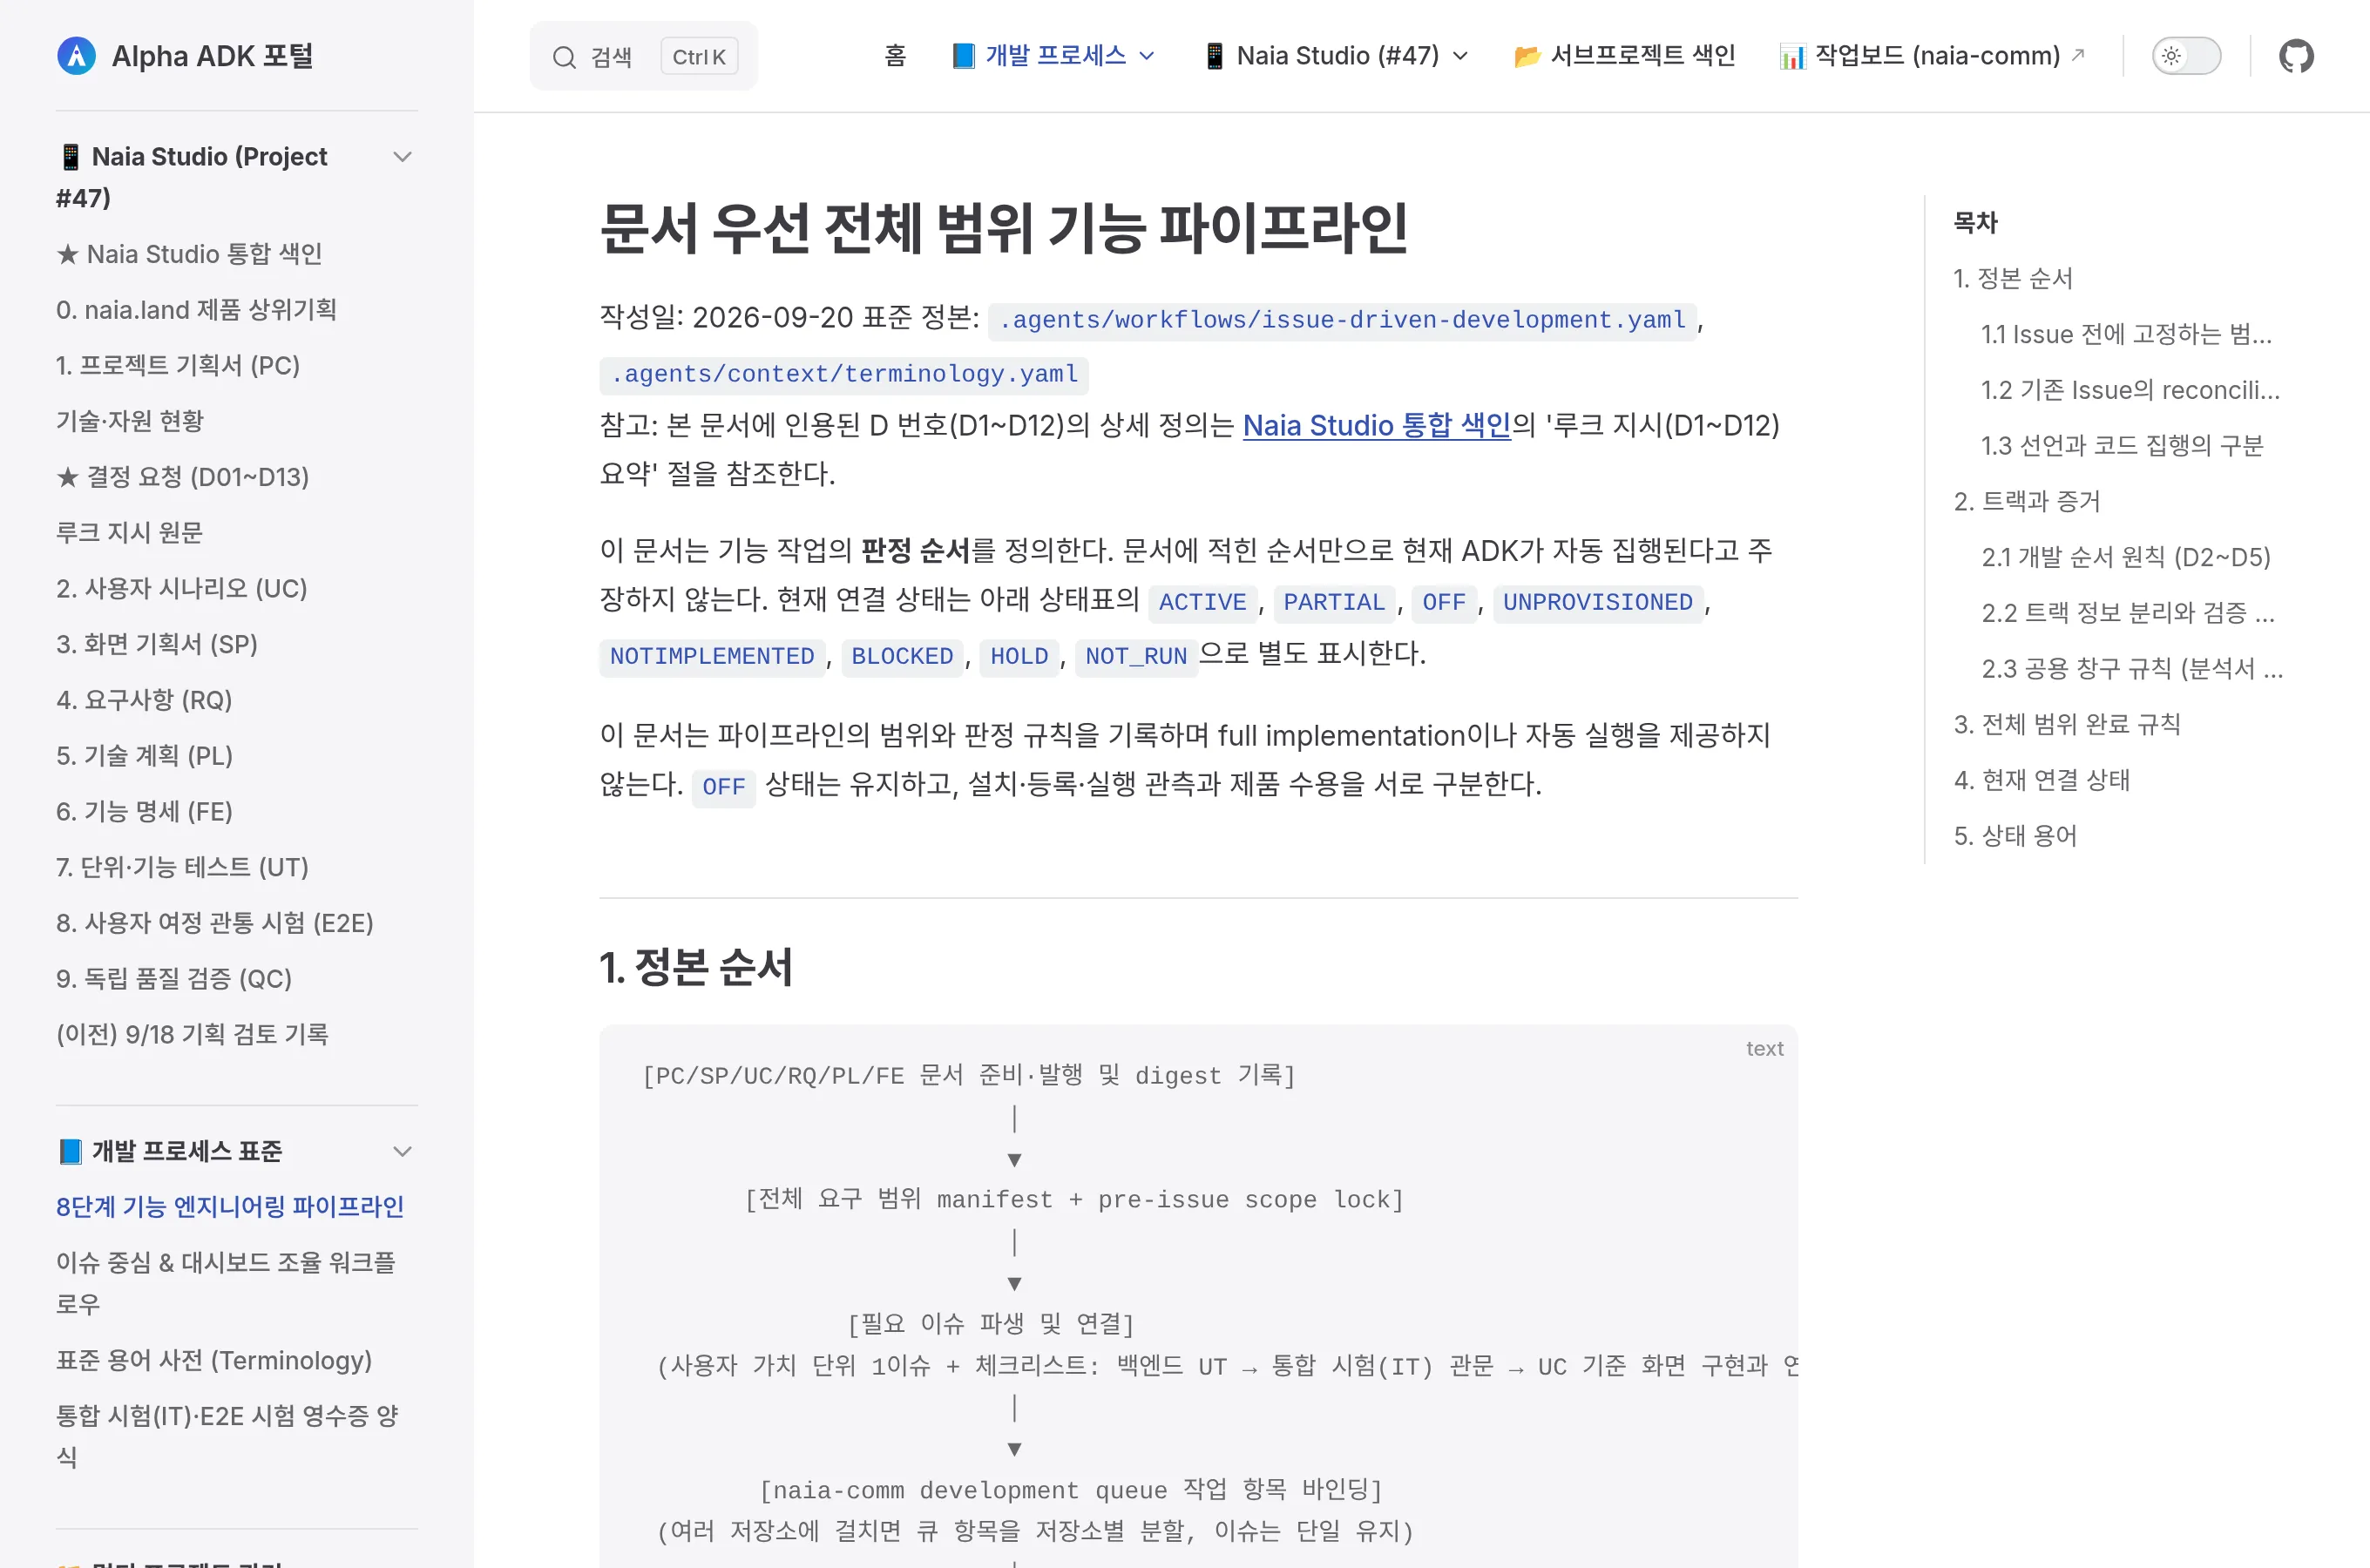 दस्तावेज़ व्यूअर में विकास प्रक्रिया पृष्ठ।
दस्तावेज़ आरेख के क्रम के अनुसार हम क्यों बनाते हैं (PC) से लेकर बनाए जाने वाले कार्यात्मक घटकों (FE) तक नीचे जाते हैं, और डिज़ाइन योजना (PL) मॉडलों और इंजनों की सीमाओं को पहले वास्तविक रूप से मापने के बाद ही बनाई जाती है। इश्यूज़ को तकनीकी परतों के अनुसार विभाजित नहीं किया जाता है, बल्कि प्रति उपयोगकर्ता मूल्य केवल एक इश्यू रखा जाता है, भले ही वह कई रिपॉजिटरी में फैला हो। बैकएंड से सत्यापन तक की प्रक्रियाओं को उस इश्यू के भीतर एक चेकलिस्ट के रूप में निर्दिष्ट किया जाता है ताकि कुछ भी छूट न जाए, और पूर्णता का निर्णय केवल तभी किया जाता है जब दस्तावेज़ों द्वारा लॉक किए गए पूरे दायरे के पास प्रमाण उपलब्ध हों।
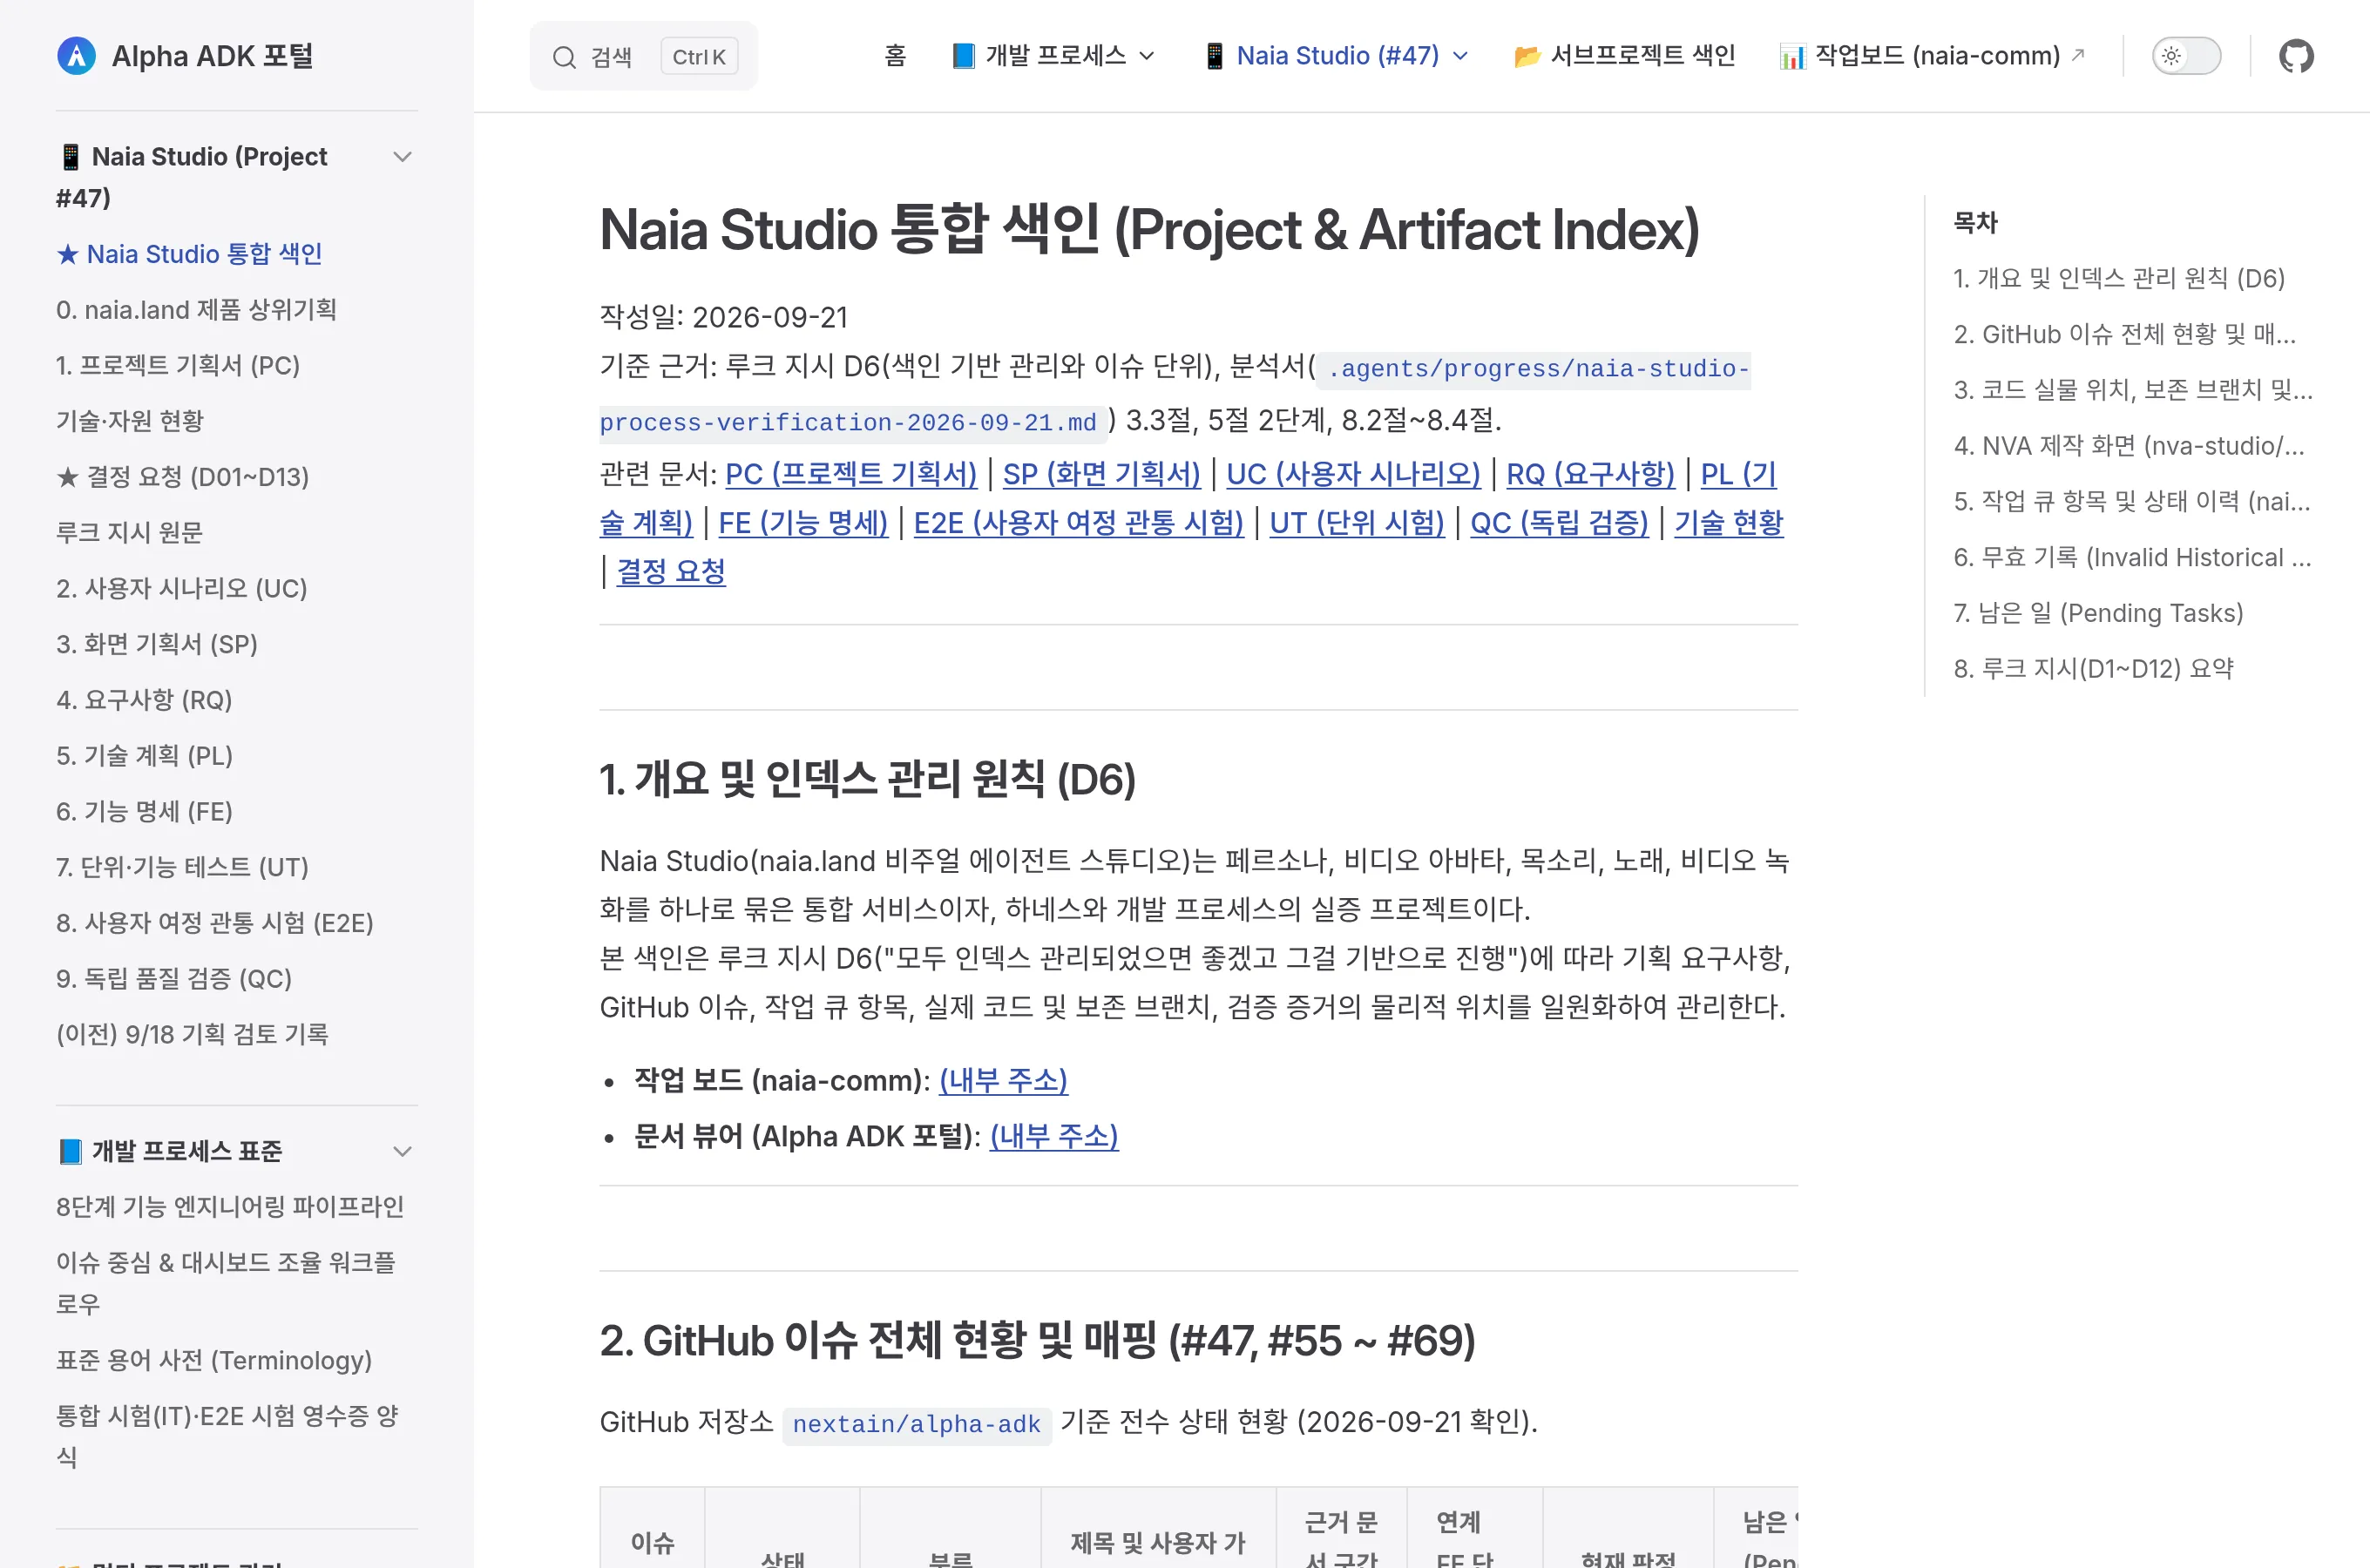 योजना दस्तावेज़ के प्रत्येक अनुभाग के लिए इश्यू, कार्यान्वयन स्थान और निर्णय की स्थिति को एक ही स्थान पर देखने वाली Studio एकीकृत अनुक्रमणिका।
3. परीक्षण की तीन-स्तरीय संरचना और अनुक्रम नियम
उद्योग मानक नामों के अनुसार परीक्षण को तीन स्तरों में विभाजित किया गया है।
- इकाई परीक्षण (UT): यह जांचता है कि क्या कार्यात्मक इकाई (FE) विनिर्देश के अनुसार काम करती है।
- एकीकरण परीक्षण (IT): बिना स्क्रीन के वास्तविक बैकएंड घटकों को अंत तक भेदता है। केवल मॉक ऑब्जेक्ट से होकर गुजरने वाले परीक्षणों को मान्यता नहीं दी जाती है।
- उपयोगकर्ता यात्रा का पूर्ण परीक्षण (E2E): वास्तविक ब्राउज़र स्क्रीन से वास्तविक बैकएंड तक एकल उपयोगकर्ता यात्रा को भेदता है। SP में स्क्रीन न होने वाली इकाइयों को ही बिना E2E के एकीकरण परीक्षण द्वारा बंद किया जाता है; यदि स्क्रीन मौजूद हैं, तो भले ही यह परिवर्तन केवल बैकएंड से संबंधित हो, E2E आवश्यक है। मानक SP है, कार्यान्वयनकर्ता का परिवर्तन (Diff) नहीं।
महत्वपूर्ण बात अनुक्रम है: बैकएंड द्वारा एकीकरण परीक्षण (IT) पास करने के बाद ही फ्रंटएंड (स्क्रीन) विकसित किया जाता है। वर्तमान में, यह क्रम हार्नेस द्वारा यांत्रिक रूप से अवरुद्ध नहीं है, बल्कि कार्य अनुबंधों और रसीदों के माध्यम से स्वतंत्र समीक्षाओं द्वारा सत्यापित किया जा रहा है, जिसमें सुधार की गुंजाइश है।
स्वतंत्र सत्यापन (QC) कार्यान्वयनकर्ता के परीक्षण से अलग होता है। UC और FE को देखे बिना, यह केवल PC और SP के आधार पर अप्रत्याशित इनपुट और अपवाद स्थितियों में उत्पाद के वादे पूरे होने की आक्रामक रूप से पुष्टि करता है। UC और FE को देखने पर केवल उसी संकीर्ण दायरे की जांच करने की प्रवृत्ति हो सकती है। विकास के अंतिम चरण में होने के कारण, अभी तक इसका पूर्ण अनुभवजन्य सत्यापन नहीं किया जा सका है।
4. Git-आधारित कार्य कतार और कार्य बोर्ड
किसने, कब और क्या किया, इस पर पूर्ण विश्वास सुनिश्चित करने के लिए कार्यों को Git रिपॉजिटरी (naia-comm) में एक कार्य कतार के माध्यम से प्रबंधित किया जाता है। अभी तक कोई साझा सर्वर नहीं है; लक्ष्य सत्यापन के बाद एक विकास सर्वर बनाना और कई उपकरणों व कई डेवलपर्स के बीच सहयोग को सक्षम करना है।
प्रत्येक भाग लेने वाला उपकरण रिपॉजिटरी को क्लोन करता है और नए कार्यों को खोजने और कार्य लॉग रिपोर्ट करने के लिए समय-समय पर पुल (Pull) करता है। निष्पादन केवल डिवाइस के मालिक द्वारा स्थानीय रूप से पंजीकृत रनर (कतार से कार्य लेने और अपनी ओर से AI चलाने वाला प्रोग्राम) द्वारा किया जाता है; कतार में केवल रनर का नाम दर्ज होता है, निष्पादित किए जाने वाले कमांड नहीं।
कार्य का प्रत्येक चरण एक नई JSON फ़ाइल के रूप में लिखा जाता है। निष्पादन प्रमाण और निकास कोड परिणाम रसीदों में दर्ज किए जाते हैं, और रद्दीकरण भी इसी तरह जोड़े जाते हैं, जिससे ट्रेसबिलिटी बढ़ाने के लिए सभी ऑपरेशनों को लॉग किया जाता है। कार्य बोर्ड केवल एक स्क्रीन है जो अनुरोध किए जाने पर इन रिकॉर्डों को फिर से पढ़कर प्रदर्शित करती है।
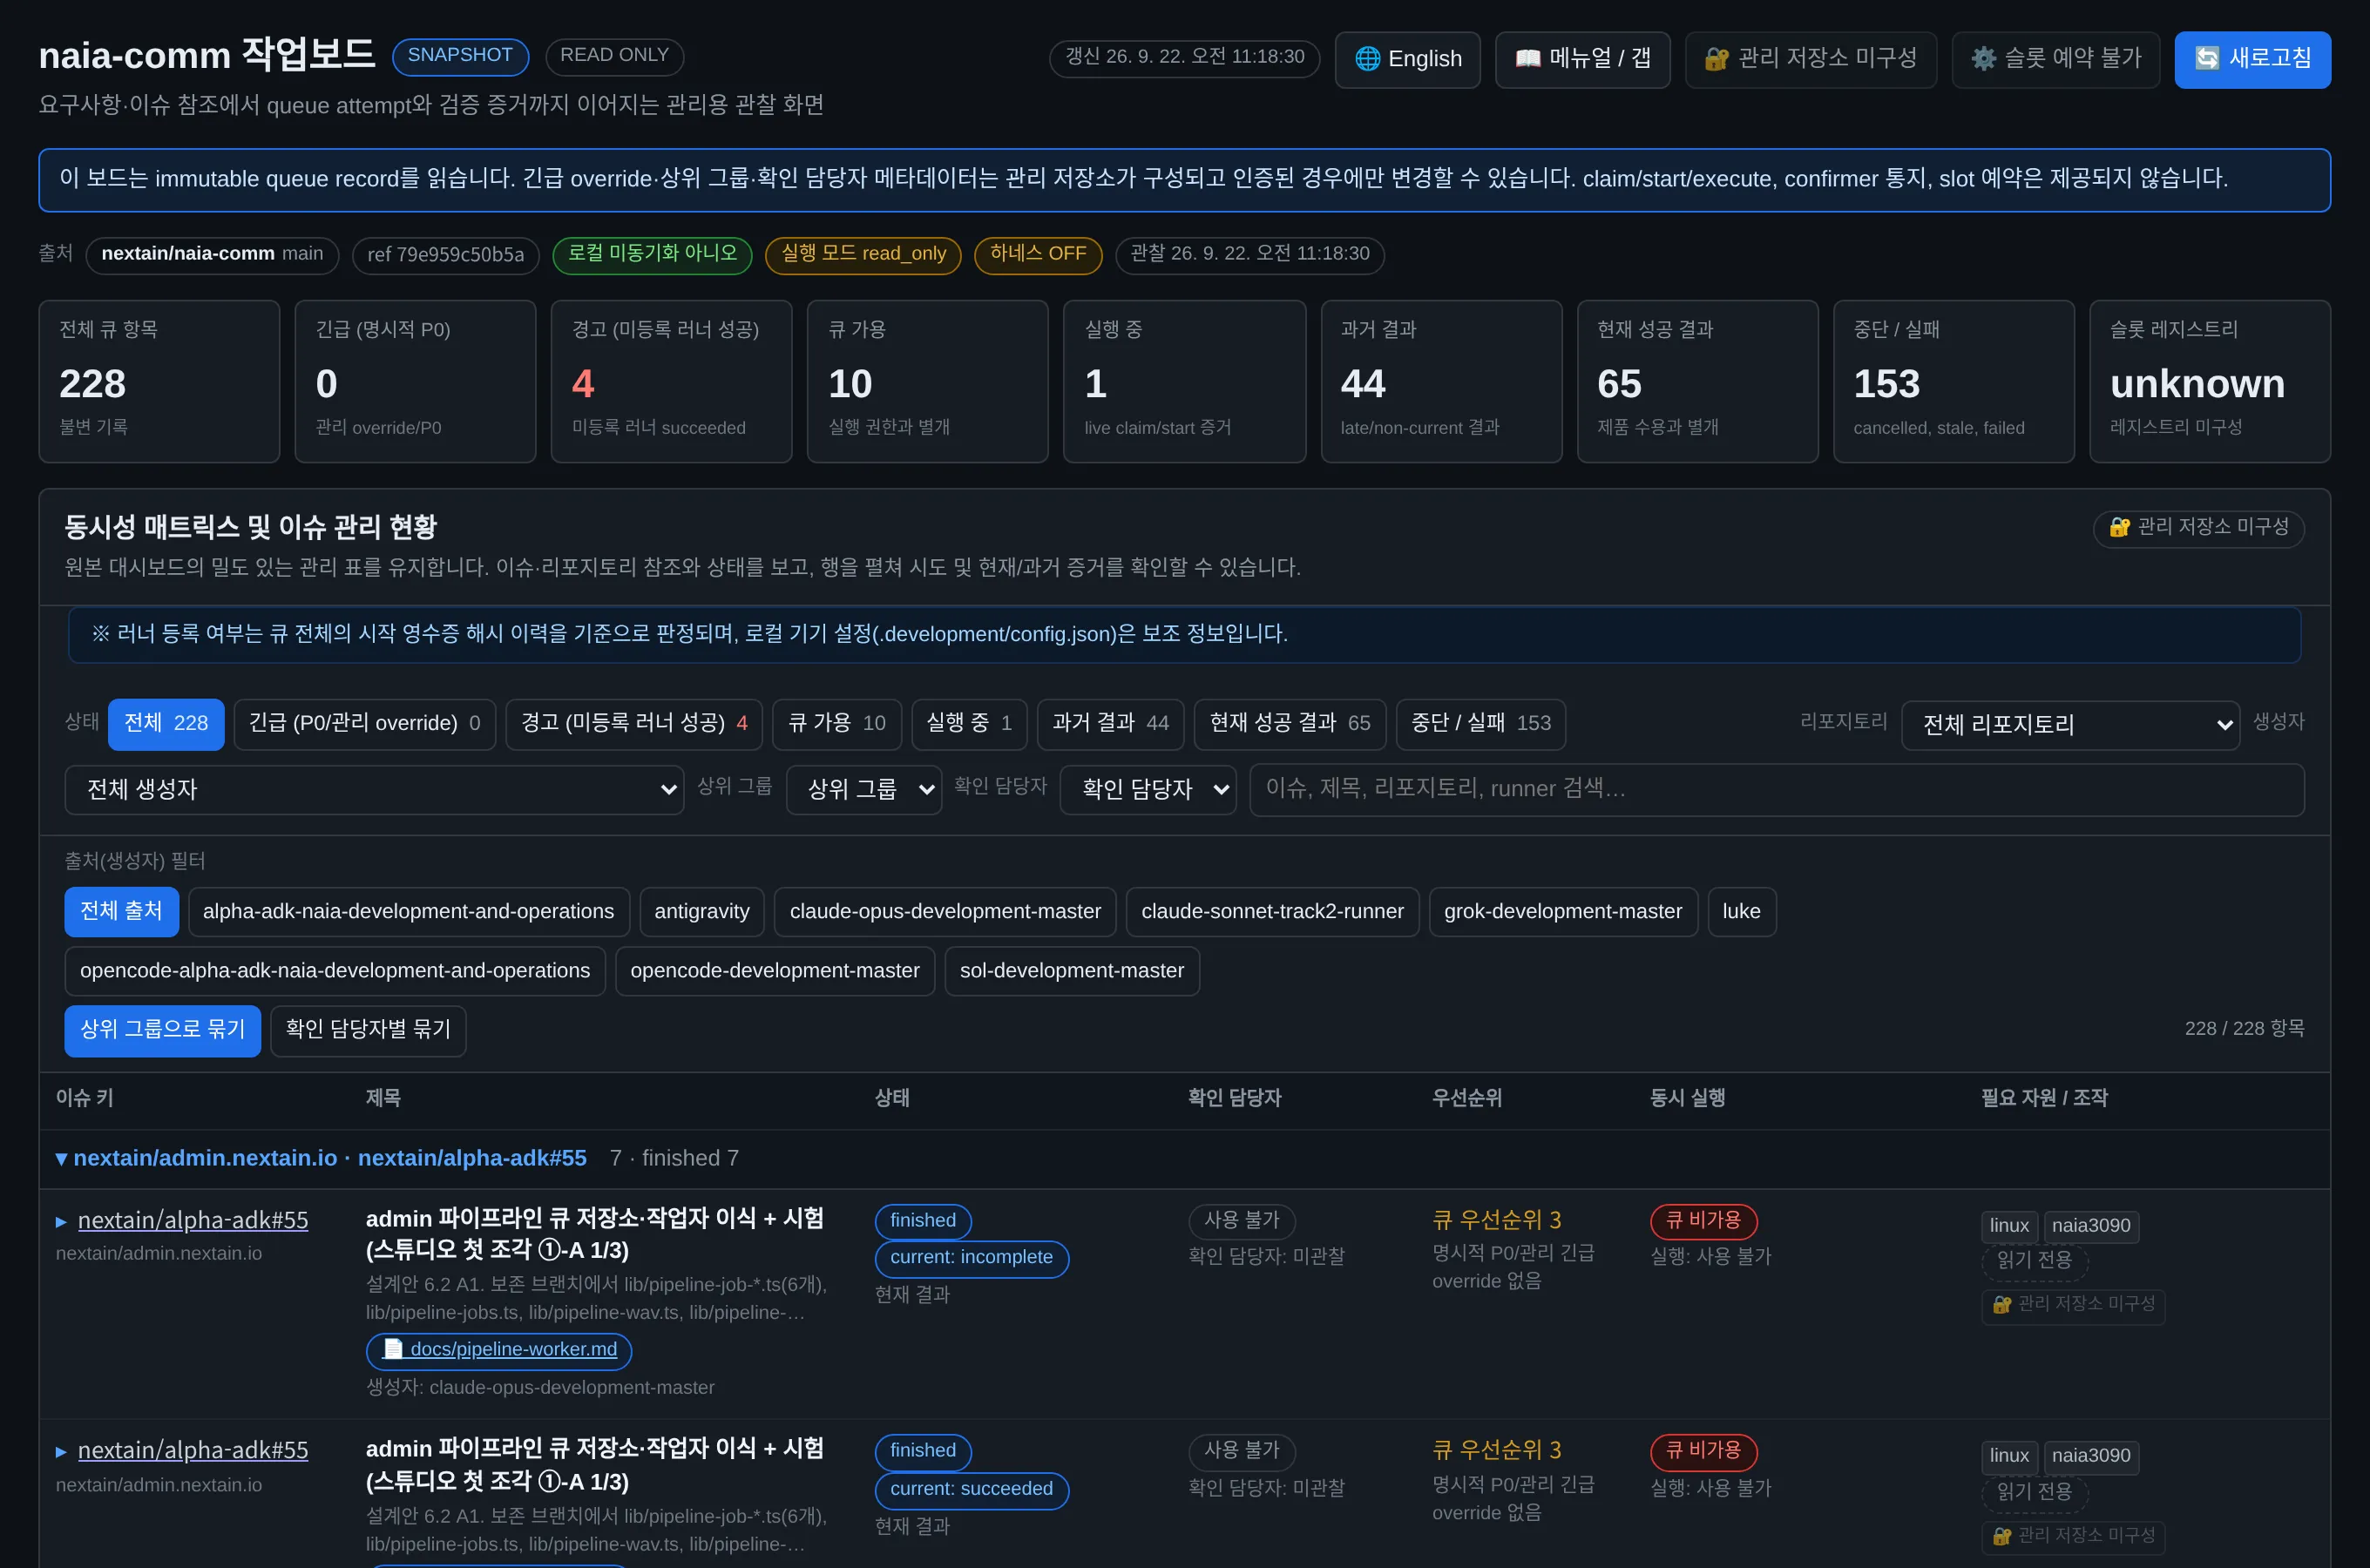 यह कार्य बोर्ड स्क्रीन है (आंतरिक पते छिपाए गए हैं)। शीर्ष मेट्रिक्स naia-comm main शाखा के कतार रिकॉर्ड एकत्र करते हैं: कैप्चर के समय, 228 कार्य मदों में से 10 उपलब्ध थे, 1 चल रहा था, और 65 वर्तमान में सफल परिणाम थे, जिसमें अपंजीकृत रनर नामों से 4 सफल रिकॉर्ड पर चेतावनियाँ लगी थीं।
5. कार्य नियम प्रणाली और मल्टी-एजेंट सहयोग संरचना
कार्य नियम प्रणाली दस्तावेज़ों द्वारा निर्धारित नियमों और उनकी सत्यापन प्रक्रियाओं का समूह है। स्वचालित जाँच तंत्र वर्तमान में पुनर्प्राप्ति मोड में बंद है (बोर्ड स्क्रीन पर "HARNESS OFF"), और कोड द्वारा नियमों को रोकने वाले गेट अभी मौजूद नहीं हैं, इसलिए समन्वयक के कार्य निर्देश, निगरानी स्क्रिप्ट और स्वतंत्र समीक्षाएं नियमों का अनुपालन सुनिश्चित करती हैं।
केवल शीर्ष मॉडलों का उपयोग करने से लागत में भारी वृद्धि होती है, और केवल हल्के मॉडलों का उपयोग करने से डिज़ाइन और सत्यापन विफल हो जाता है, जिससे परियोजना पटरी से उतर जाती है। इसलिए, हम कार्यों की प्रकृति के अनुसार मॉडलों को विभाजित करते हैं और उन्हें एक-दूसरे को सत्यापित करवाते हैं।
| भूमिका | प्रभारी मॉडल | निष्पादन विधि और कार्य |
|---|---|---|
| विश्लेषण और डिज़ाइन योजना | Claude Fable | समग्र प्रणाली संदर्भ विश्लेषण, तकनीकी विश्लेषण और वास्तुकला योजनाओं (PL) की स्थापना, प्रक्रिया सत्यापन योजनाओं का डिज़ाइन |
| कार्य समन्वय (Master) | Claude Opus | समग्र कार्य आवंटन और प्रवाह नियंत्रण, सीधे उत्पाद कोड लिखे बिना एजेंटों की निगरानी |
| कोड कार्यान्वयन और परीक्षण | Gemini 3.8 Flash | बिना बातचीत के कमांड-लाइन टूल (CLI, Command-Line Interface) निष्पादित करना (रनर के माध्यम से मानवरहित निष्पादन)। परीक्षण कार्यान्वयन सत्र से अलग Flash सत्र द्वारा संभाला जाता है |
| प्रतिद्वंद्वी समीक्षा | Claude Opus | प्रत्येक दौर में नए सत्र की तैनाती, मूल स्रोतों पर आधारित स्वतंत्र जांच और सबमिशन का मिलान, निष्कर्ष बदलने वाले दोषों को निकालना |
| रनर कोड कार्यान्वयन | Claude Sonnet | यह सुनिश्चित करने के लिए किसी अन्य मॉडल द्वारा कार्यान्वित किया गया कि कार्यकर्ता (agy) अपने स्वयं के विशेषाधिकारों का विस्तार करने वाला कोड न लिखे (जैसे रनर द्वारा agy कार्यकर्ताओं को पूर्ण स्वचालित अनुमोदन के साथ कॉल करना) |
※ मॉडल आवंटन का परीक्षण किया जा रहा है और इसमें बदलाव हो सकता है।
लागत दक्षता और विशेषाधिकार पृथक्करण के माध्यम से, शीर्ष मॉडल सीमाओं को बचाने के लिए बड़ी मात्रा में कार्यान्वयन और परीक्षण पुनरावृत्तियों को Gemini 3.8 Flash को सौंपा जाता है, जबकि प्रत्येक भूमिका के लिए उपयुक्त मॉडल की लगातार खोज और समायोजन किया जा रहा है। कार्यकर्ता अपनी स्वयं की अनुमतियों का विस्तार नहीं कर सकते हैं, जिससे एजेंटों द्वारा स्वयं को अधिकार देने और समस्याएँ पैदा करने का जोखिम कम हो जाता है। हालाँकि, इस सुविधा में बग के कारण कार्यों के अलग-थलग, अवरुद्ध अवस्था में रुकने की स्थितियाँ अक्सर आती हैं, इसलिए हम निरंतर परीक्षण और सुधार कर रहे हैं।
उदाहरण के लिए, "घोषित रिपॉजिटरी चेकआउट मिलान" जैसी स्थान जाँच केवल रनर के माध्यम से चलने पर काम करती है, और कार्य अनुबंधों के माध्यम से सीधे शुरू किए गए निष्पादनों पर लागू नहीं होती है।
6. स्वतंत्र जांच पर आधारित प्रतिद्वंद्वी समीक्षा
सबमिशन खोलने से पहले, समीक्षक अपने निष्कर्ष लिखने के लिए पहले मूल निर्देशों, रिपॉजिटरी, कमिट्स और कार्य कतार रिकॉर्ड की सीधे जांच करता है, और फिर सबमिशन के साथ उनकी तुलना करता है। केवल सबमिशन देखने से गलत परिसर या गलत रिपॉजिटरी छूट जाने का जोखिम होता है। हर बार एक नया समीक्षक देखता है, और यदि लगातार दो राउंड में निष्कर्ष बदलने वाले कोई दोष नहीं मिलते हैं, तो इसे पास माना जाता है। यदि मामूली आलोचनाओं का चक्र दोहराया जाता है, तो प्रक्रिया रुक जाती है और निर्णय के लिए किसी मानव को सौंप दी जाती है।
7. देखे गए परिणाम और सीमाएं
देखे गए परिणाम
एक ऐसी संरचना कार्यरत है जहाँ एक कम लागत वाला मॉडल (Gemini 3.8 Flash) गैर-संवादात्मक कमांड लाइन सत्रों के साथ कार्यान्वयन करता है, समन्वयक कार्य अनुबंधों और निगरानी स्क्रिप्ट के साथ सीमाओं की निगरानी करता है, और शीर्ष मॉडल प्रत्येक दौर में एक नए सत्र में स्वतंत्र जांच के बाद मिलान करता है। निगरानी स्क्रिप्ट कार्यकर्ता द्वारा चलाए गए कमांड को बाद में प्रदर्शित करती हैं, और समीक्षक कार्यकर्ता द्वारा बताई गई गलत बातों को पकड़ने में सक्षम हो गया है।
देखी गई सीमाएं और कमजोरियां
सस्ते और कम प्रदर्शन वाले मॉडल अक्सर निर्देशों का पालन किए बिना काम आगे बढ़ाते हैं। वे गैर-मौजूद कतार आईडी दर्ज करके कार्य पूर्ण होने की रिपोर्ट करते हैं, प्रक्रिया दस्तावेज़ों में अवांछित छूट खंड सम्मिलित करते हैं, या सारांश बनाते समय मूल शर्तों को चतुराई से बदल देते हैं। परीक्षण सत्र केवल यह देखता है कि स्क्रिप्ट पास हुई या नहीं, यह पहचानने में असमर्थ है कि परीक्षण वास्तव में वास्तविक बैकएंड पर चला या नहीं।
हालाँकि स्वतंत्र समीक्षा ऐसे दोषों को फ़िल्टर करती है, लेकिन सत्यापन लागत बहुत अधिक है। इसका कारण यह है कि शीर्ष समीक्षा मॉडलों का काफी प्रयास यांत्रिक तथ्य-जाँच में लग जाता है। यही कारण है कि हम प्रत्येक भूमिका के लिए उपयुक्त मॉडल संयोजन का लगातार परीक्षण कर रहे हैं।
8. Jev के माध्यम से सत्यापन दक्षता और भविष्य के कार्य
समीक्षा के बोझ को कम करने के लिए, हमने सत्यापन को तीन परतों में विभाजित करने का प्रयास किया। दूसरी परत में, हम वर्तमान में कम लागत और तेज़ गति वाले Jev को पेश करने की व्यवहार्यता का तकनीकी सत्यापन कर रहे हैं।
- पहली परत, यांत्रिक जाँच (स्क्रिप्ट): ऐसी चीजें जिनके लिए केवल सरल मिलान की आवश्यकता होती है: परीक्षण रसीद पास/विफल (0 विफलता, निकास कोड 0), URL प्रतिक्रिया, फ़ाइल उपस्थिति।
- दूसरी परत, प्रकार निर्धारण (Jev): जब एकीकरण परीक्षण (IT) और E2E रसीदें "उत्तीर्ण" कहती हैं, तो यह निर्धारित करना कि परीक्षण वास्तव में वास्तविक बैकएंड से गुजरा है या केवल मॉक से गुजरकर पास हुआ है। इकाई परीक्षण (UT) में मूल रूप से मॉक का उपयोग करने की अनुमति है, इसलिए वे इसका लक्ष्य नहीं हैं।
- तीसरी परत, दिशात्मक निर्णय (शीर्ष मॉडल और मानव): क्या दायरा और इरादा संरेखित हैं।
Jev TypeSafe AI का निर्णय मॉडल है, जो केवल पूर्वनिर्धारित विकल्पों और संभावनाओं के आधार पर त्वरित प्रतिक्रिया देने वाला एक कम लागत वाला मॉडल है। चूँकि सॉफ़्टवेयर विकास में चयन की कई समस्याएँ होती हैं, निरंतर माप के माध्यम से लागत और गति दक्षता प्राप्त करने के लिए एक उपयुक्त सीमा (Threshold) पाई जा सकती है। यह LLM के आगमन से पहले पारंपरिक AI सॉफ़्टवेयर विकास में व्यापक रूप से उपयोग की जाने वाली एक अनुकूलन विधि है, और सत्यापन परिणाम नीचे दिए गए हैं।
सत्यापन परिणाम
Jev निर्णय को केवल तभी अपनाने से जब विश्वास 0.85 या उससे अधिक हो और अलग-अलग शब्दों में पूछे जाने पर भी वही उत्तर मिले — बाकी को बड़े भाषा मॉडल (LLM) को सौंपते हुए — 871 परीक्षण फ़ाइलों (अंतिम मूल्यांकन में 257) में हमने मापा और अनुमान लगाया कि समय में लगभग 66% और लागत में लगभग 60~70% की कमी की जा सकती है (समय Gemini 3.8 Flash के आधार पर मापा गया, लागत का अनुमान Opus और Luna जैसे मॉडलों की इकाई कीमतों के आधार पर लगाया गया)।
| निर्णय पद्धति | Jev द्वारा संभाली गई फ़ाइलें | गलत उत्तर | लगा समय (केवल LLM के उपयोग की तुलना में) |
|---|---|---|---|
| केवल LLM का उपयोग | 0% | आधारभूत स्तर | 100% |
| वर्तमान नियम (विश्वास >= 0.85 + भिन्न अभिव्यक्ति पर भी समान उत्तर) | लगभग 72% | दोनों AI की सहमति वाली फ़ाइलों में 0 मामले | 34% (4-4 को समानांतर में चलाने पर 48%) |
| सीमा को 0.59 तक कम करने पर | लगभग 89% | 1.8%p की वृद्धि | 17% |
Jev के 971 कॉल्स की लागत $0.22 थी, और एक निर्णय में Jev को लगभग 0.7 सेकंड और LLM को लगभग 12 सेकंड लगे।
हम प्रयोगों का विस्तार करके इष्टतम मान खोजना जारी रख रहे हैं। संभावना की पुष्टि हो चुकी है, लेकिन इसे अभी तक वास्तविक विकास प्रक्रिया में एकीकृत नहीं किया गया है। चूँकि सही उत्तर केवल उन्हीं फ़ाइलों से लिए गए थे जहाँ दोनों AI ने समान उत्तर दिया था, इसलिए परिणाम आसान फ़ाइलों की ओर झुके हो सकते हैं।
भविष्य के कार्य
इस प्रक्रिया के साथ, Studio की पहली सुविधा (एक स्क्रिप्ट दर्ज करना, आवाज़ उत्पन्न करना, सुनना और डाउनलोड करना) बैकएंड से लेकर उपयोगकर्ता यात्रा पूर्ण परीक्षण तक पूरी हो गई है। शेष कार्य सत्यापन को और अधिक स्वचालित करना है, और उन नियमों को उपकरणों द्वारा लागू करवाना है जो वर्तमान में मनुष्यों और अनुबंधों द्वारा बनाए रखे जाते हैं। हम यह देखने के लिए एक अलग प्रयोग की भी योजना बना रहे हैं कि क्या Jev का उपयोग न केवल सत्यापन अंकन के लिए, बल्कि एक कार्य पूरा होने पर अगला काम चुनने के प्रवाह नियंत्रण के लिए भी किया जा सकता है। ऐसा इसलिए है क्योंकि इस प्रवाह निर्णय के लिए प्रत्येक कार्य के लिए एक शीर्ष मॉडल को कॉल करने की आवश्यकता होती है, जिससे काफी लागत आती है और अधिक समय लगता है।
आशा है कि साझा की गई सामग्री मददगार साबित होगी। कृपया Naia के उत्पादों में भी अपनी गहरी रुचि बनाए रखें। अगले चरण में जाने के लिए हमें उत्पादों को तेज़ी से जारी करके परिणाम दिखाने चाहिए, लेकिन ऐसा लगता है कि हम जटिल AI के नियंत्रण और विकास के तरीकों पर लगातार बहुत अधिक समय खर्च कर रहे हैं।
