Processo de desenvolvimento multi-IA guiado por documentos no Naia ADK: testando a eficiência com Jev
 Olá. Sou o Luke, criador do Naia.
O Naia pode parecer para os usuários comuns um produto de agentes de personagens, mas uma parte significativa do meu trabalho diário consiste em desenvolvimento de software. Por isso, construímos a infraestrutura de desenvolvimento para isso e conduzimos o desenvolvimento de software para clientes corporativos utilizando a infraestrutura de desenvolvimento do Naia. Anteriormente, publiquei um livro intitulado "Harness Engineering: Engenharia de Software com IA a partir de Re:Zero" (edição em coreano, edição em inglês). Desde então, continuamos dedicando muitos esforços para estruturar ainda melhor um processo de desenvolvimento baseado em agentes de IA.
Hoje, compartilho o processo de desenvolvimento de software e as entregas criadas para o desenvolvimento do Naia, além de como estamos tentando introduzir o Jev, um modelo de decisão em alta recentemente, nesse processo de desenvolvimento.
Havia 3 objetivos principais que busquei perseguir neste processo de desenvolvimento: visibilidade, paralelização e otimização de custos.
- Visibilidade : Saber se o desenvolvimento está ocorrendo adequadamente e, caso haja desvio do modelo (drift), identificar exatamente em qual etapa o problema ocorreu.
- Paralelização : Distribuir tarefas em paralelo entre múltiplos agentes para aumentar a velocidade de desenvolvimento.
- Otimização de custos : Utilizar modelos otimizados em custos. O Jev também é uma excelente alternativa nesse sentido.
A estrutura básica do nosso sistema de regras de trabalho (Harness) está aberta como código aberto abaixo:
- Estrutura básica do espaço de trabalho pessoal e sistema de regras de trabalho (Harness): nextain/naia-adk
- Estrutura básica para colaboração em equipes e projetos: nextain/naia-pj-adk
- Guia de participação na comunidade: nextain/naia-comm-public
- Jev é um modelo de decisão lançado pela TypeSafe AI.
A fila de tarefas, o painel, o runner e os documentos de planejamento descritos neste artigo ainda estão em desenvolvimento interno e permanecem privados. Atualmente, esse processo também se encontra em fase de validação, sendo testado em um novo recurso que estreará na web do Naia: o desenvolvimento do Naia Visual Agent Studio, um avatar em vídeo capaz de sincronização labial e canto. O motivo de ainda não ser público é que ele ainda não está refinado o suficiente para uso compartilhado em projetos de equipe; faremos a abertura adicional assim que tudo estiver organizado.
Abreviaturas usadas neste artigo e em nossos documentos de desenvolvimento
Primeiramente, nossos documentos de desenvolvimento, issues e filas de tarefas usam as seguintes abreviaturas e dispõem de um dicionário padrão de vocabulário do projeto. Isso foi adotado porque eu não queria digitar instruções longas para a IA e havia o risco de confusão terminológica.
| Abreviatura | Nome completo | Termo | Significado em uma linha |
|---|---|---|---|
| PC | Product / Project Concept | Planejamento de alto nível | Por que construímos: essência do produto, razão de existir, valor do usuário e arquitetura geral de informação |
| SP | Screen Plan | Planejamento de telas | Projeto estrutural das telas que o usuário verá (layout, disposição, navegação) |
| UC | User Scenario | Jornada do usuário (User Scenario) | A jornada completa de um usuário que entra sob determinado contexto, atinge seu objetivo e sai |
| RQ | Requirements | Requisitos | Condições e critérios de aceitação mensuráveis que o sistema deve cumprir para satisfazer UC e SP |
| PL | Plan / Architecture | Análise técnica e plano de design | Confirmar a realidade técnica por medições reais e estabelecer a arquitetura e os planos de implementação em etapas |
| FE | FEature | Especificação de recursos | Unidades funcionais concretas criadas para realizar UC e RQ. Não é Frontend |
| UT | Unit Test | Teste unitário | Validar se a unidade funcional opera conforme as especificações |
| IT | Integration Test | Teste de integração | Teste que penetra os componentes reais do backend de ponta a ponta sem interface. Não é tecnologia da informação (IT) |
| E2E | End-to-End Test | Teste de jornada do usuário de ponta a ponta | Teste que penetra uma única jornada do usuário da tela real até o backend real |
| QC | Quality Control / Validation | Validação independente | Verificação agressiva das promessas do produto baseando-se apenas em PC e SP, sem olhar o roteiro do desenvolvedor nem a implementação interna |
1. Contexto de introdução e conscientização dos problemas
Se delegarmos amplamente o desenvolvimento aos agentes de IA, eles tendem a criar a interface do usuário (UI, User Interface) sem backend ou a relatar como aprovados testes executados com objetos simulados (mocks). Por isso, conduzimos o planejamento de cima para baixo (Top-down) e o desenvolvimento de baixo para cima (Bottom-up). O planejamento descende da experiência geral do usuário, enquanto o desenvolvimento é construído a partir das menores unidades funcionais, conectando a interface somente após o backend ter sido realmente penetrado. Começar pela tela gera uma alta probabilidade de retrabalhos substanciais durante a integração.
2. Fluxo de trabalho orientado por documentos e processo de desenvolvimento
Escrever a documentação primeiro serve para definir previamente o escopo de construção e os critérios de aceitação. Ao documentar as solicitações em vez de usar simples prompts, torna-se possível rastrear a causa raiz quando surgem problemas.
Listamos todos os documentos do processo de desenvolvimento e, após verificação humana, criamos as issues e os itens da fila de tarefas. Antes de criar uma nova issue, a IA examina a quais documentos ela se relaciona e consulta as issues abertas anteriormente. Somente quando issues, itens de fila e comprovantes de testes estiverem todos devidamente presentes é que a conclusão da tarefa pode ser decretada.
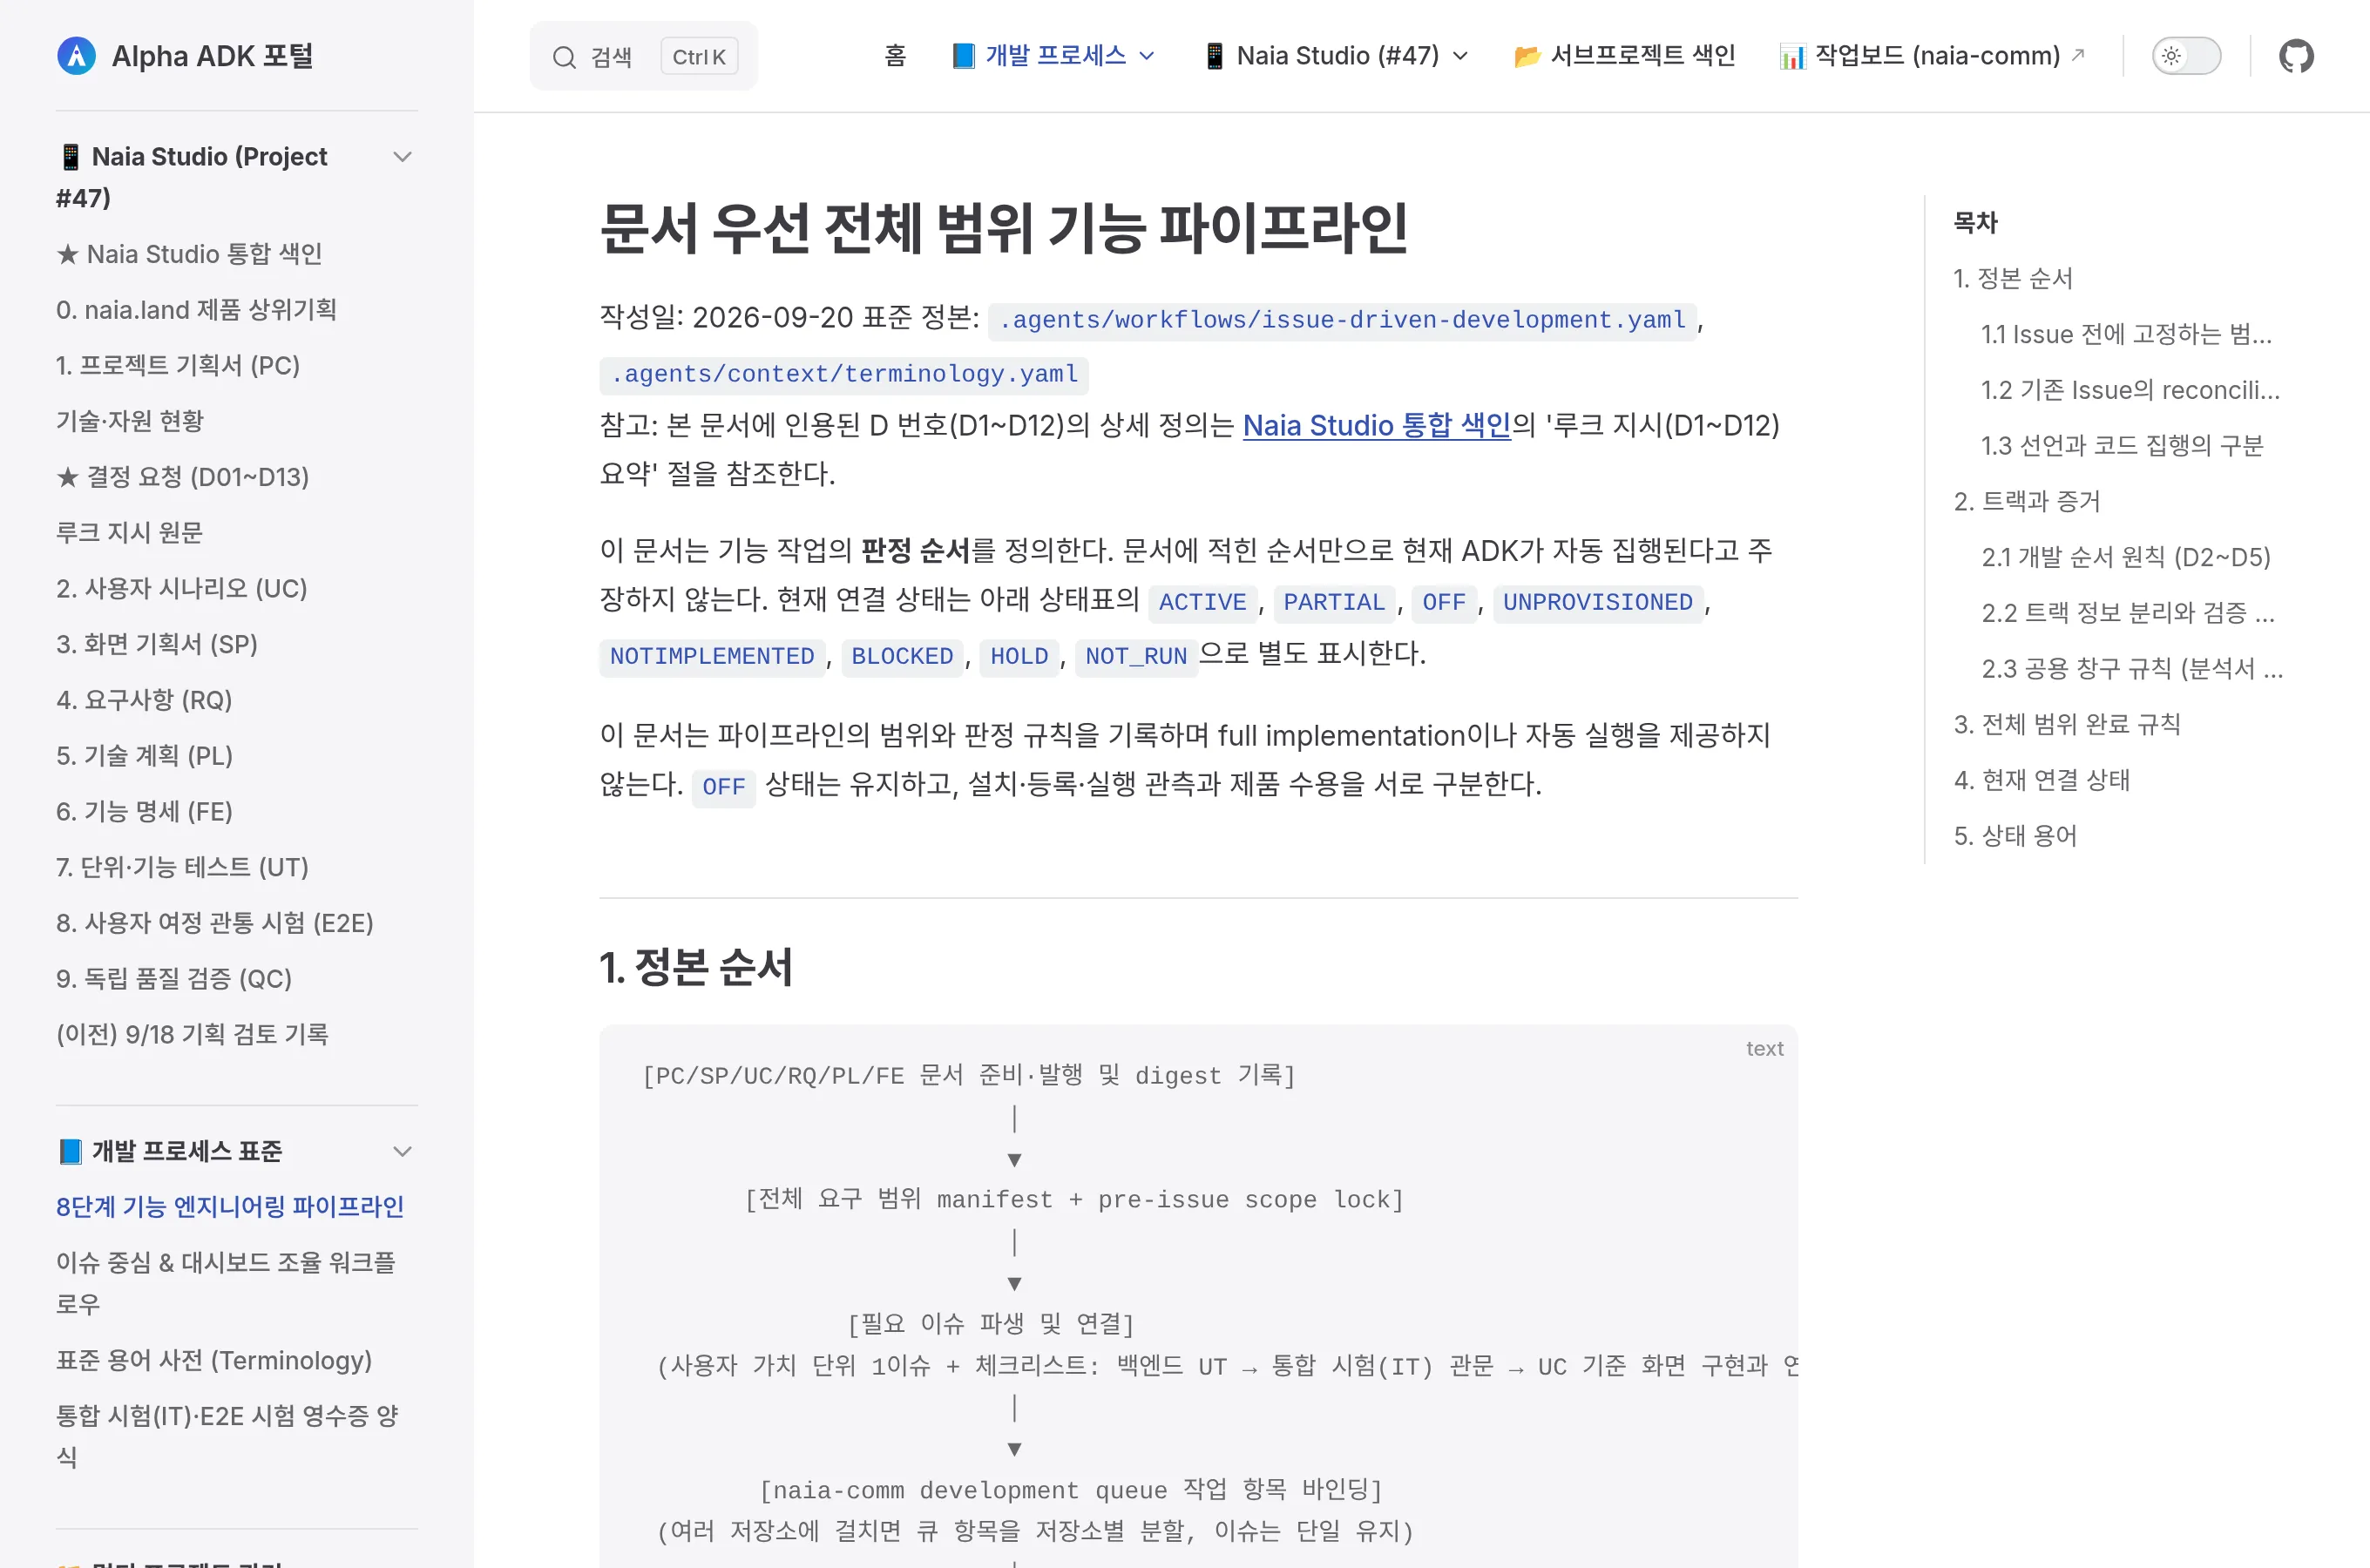 Página de procedimento de desenvolvimento no visualizador de documentos.
Os documentos descem na ordem do diagrama, desde o porquê construímos (PC) até as unidades funcionais a construir (FE), e o plano de design (PL) é estabelecido somente após a medição prévia e real dos limites dos modelos e motores. As issues não são divididas por camadas tecnológicas, mantendo-se uma única por valor do usuário, mesmo quando abrangem múltiplos repositórios. As etapas desde o backend até a inspeção são designadas como checklists dentro da issue para não deixar nada de fora, e a conclusão só é homologada quando todo o escopo travado pela documentação dispuser de evidências.
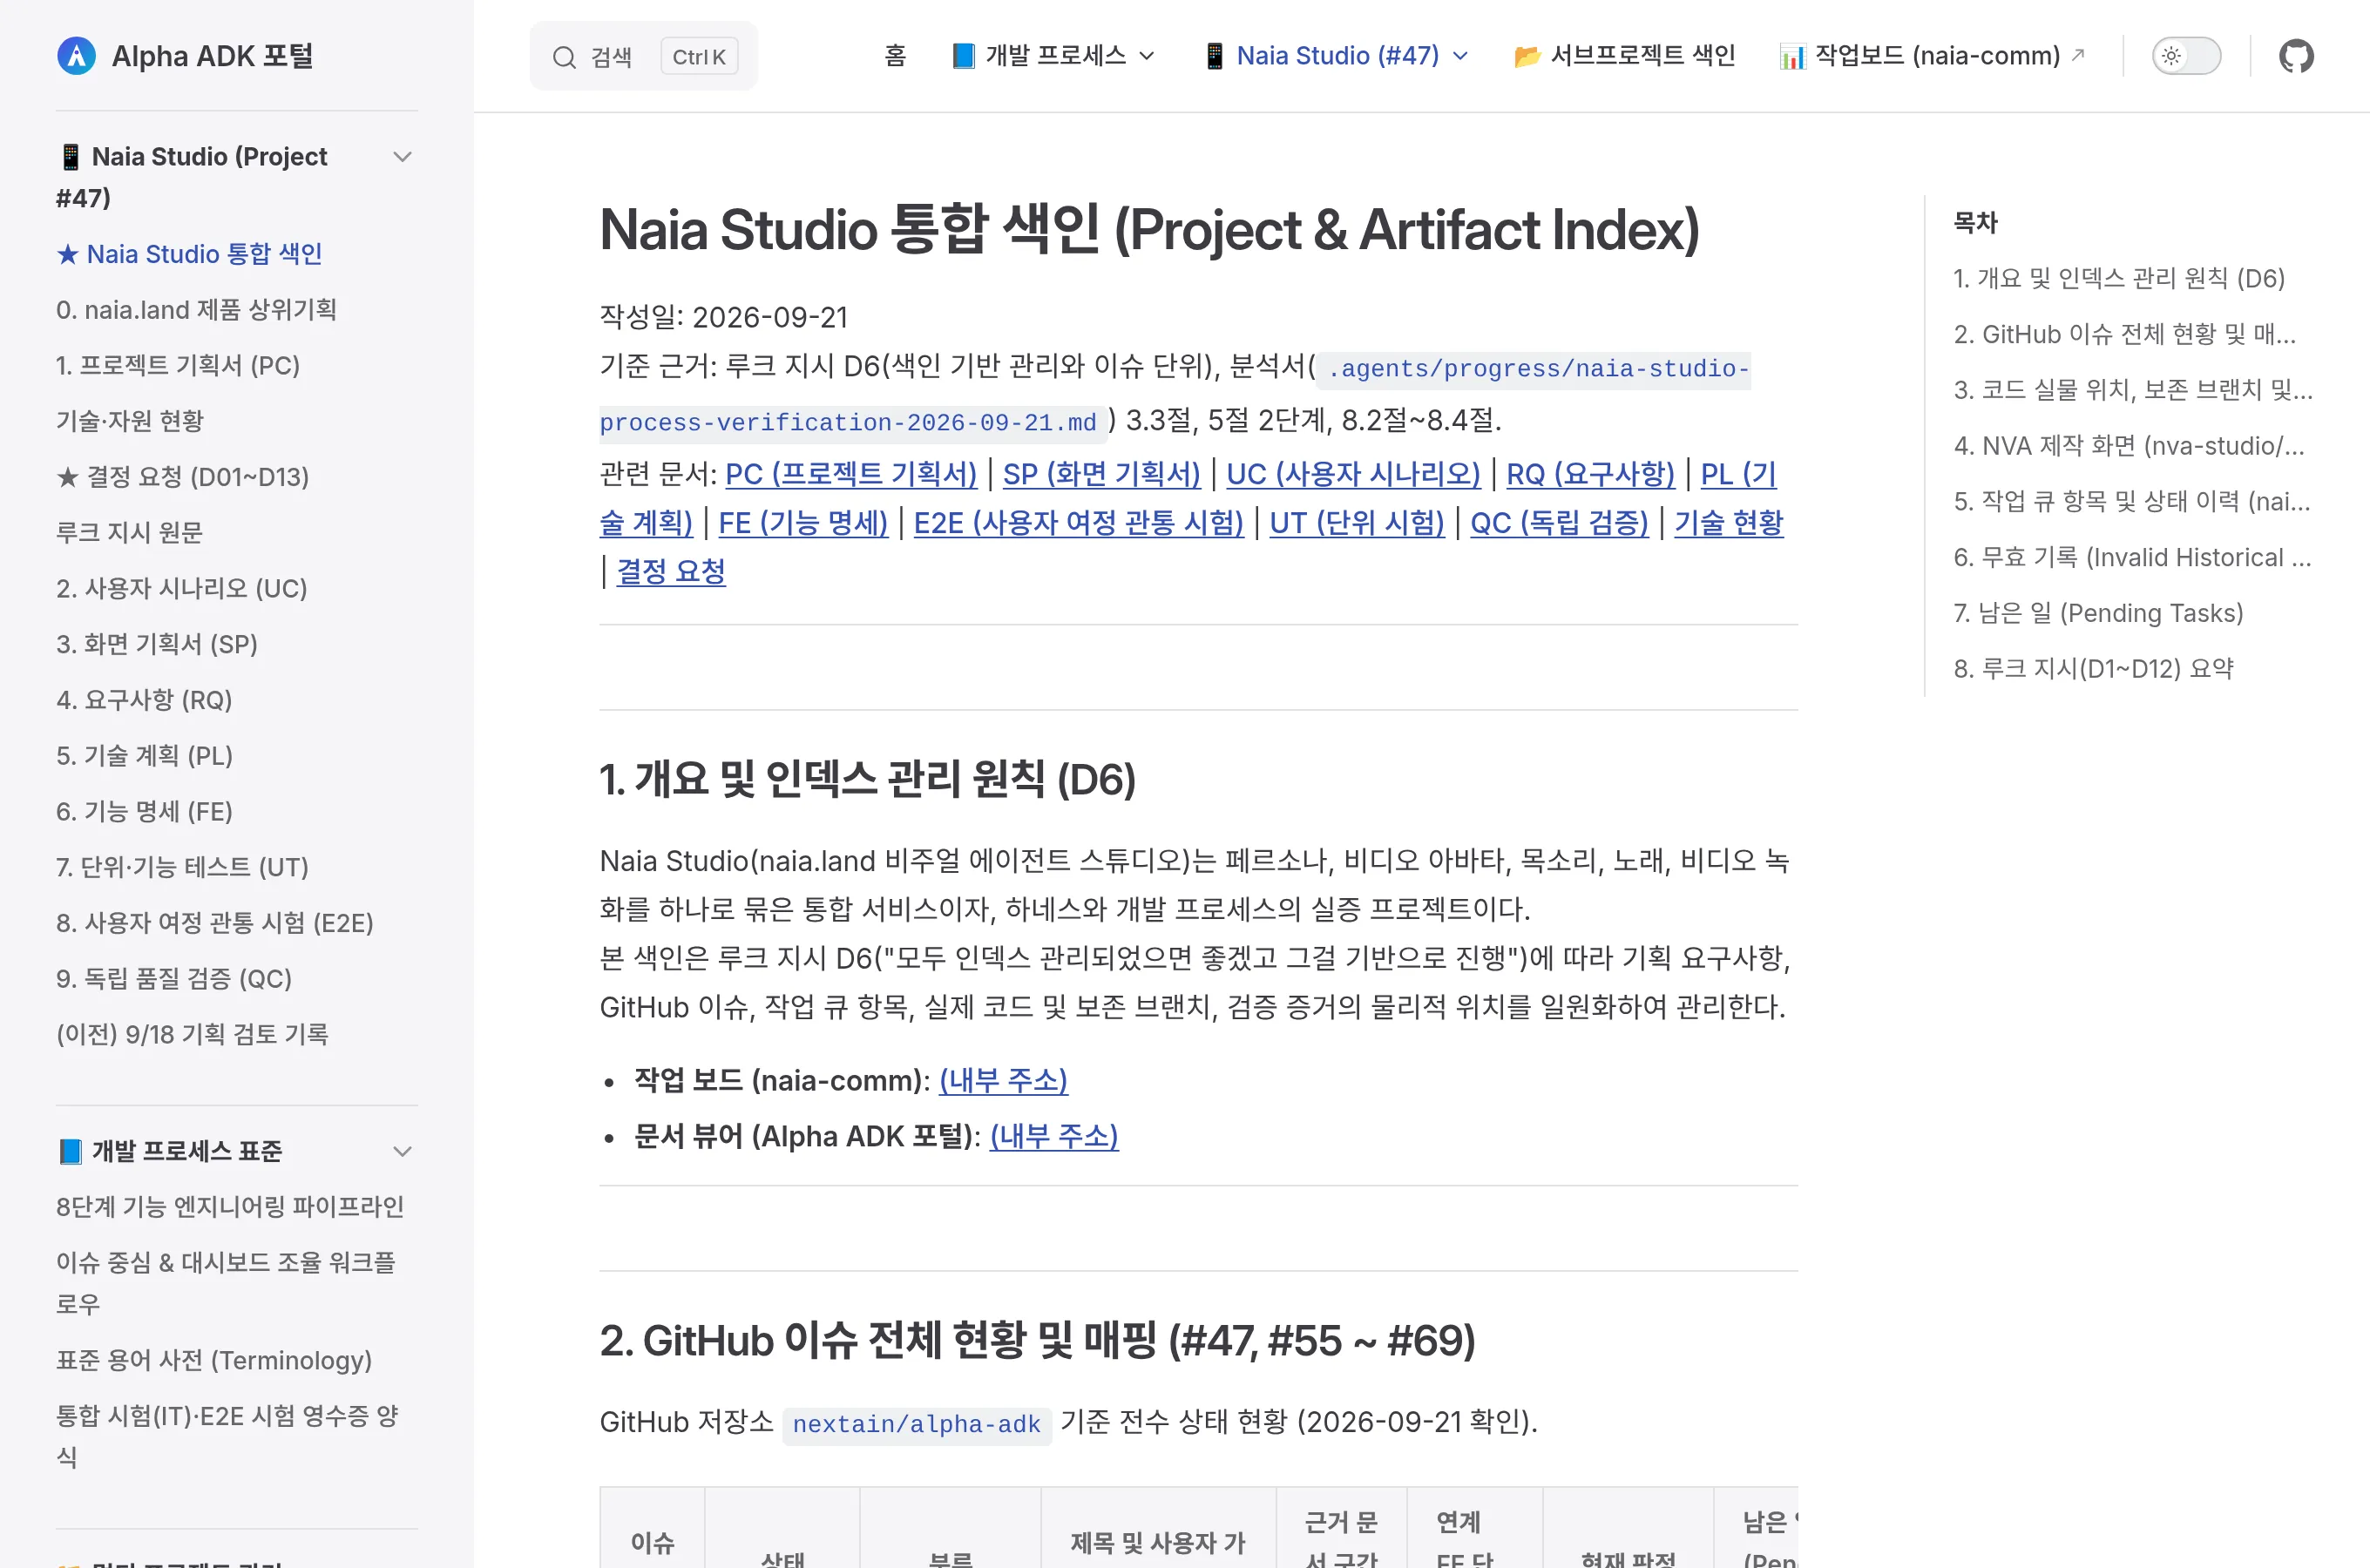 Índice integrado do Studio que permite visualizar em um só lugar as issues, os locais de implementação e os status de validação de cada seção dos documentos de planejamento.
3. Estrutura de testes em 3 níveis e regras de sequência
Os testes são divididos em três níveis de acordo com os padrões da indústria.
- Teste unitário (UT): Verifica se a unidade funcional (FE) opera de acordo com a especificação.
- Teste de integração (IT): Penetra os componentes reais do backend de ponta a ponta sem interface. Testes que passam apenas por objetos simulados (mocks) não são aceitos.
- Teste de jornada do usuário de ponta a ponta (E2E): Penetra uma única jornada do usuário desde as telas reais do navegador até o backend real. Apenas unidades sem telas no SP são encerradas com teste de integração sem E2E; havendo telas, o E2E é obrigatório mesmo que a alteração atual seja apenas de backend. O critério é o SP, não a alteração do implementador.
O ponto crucial é a sequência: o frontend (tela) só é desenvolvido depois que o backend for aprovado no teste de integração (IT). Atualmente, essa sequência não é bloqueada de forma mecânica pelo Harness, sendo verificada por ordens de serviço e revisões independentes por meio de recibos, deixando espaço para melhorias.
A validação independente (QC) atua à parte dos testes do implementador. Sem consultar UC e FE, ela verifica de maneira incisiva, com base unicamente em PC e SP, se as promessas do produto são mantidas sob entradas forçadas e situações de exceção. Olhar UC e FE induziria o revisor a verificar apenas aquele escopo restrito. Por estar localizada no estágio final do desenvolvimento, ela ainda não passou por validação empírica completa.
4. Fila de tarefas baseada em Git e painel de trabalho
Para garantir a confiabilidade sobre quem fez o quê e quando, as tarefas são gerenciadas por meio de uma fila de tarefas em um repositório Git (naia-comm). Ainda não há um servidor compartilhado; o objetivo é criar um servidor de desenvolvimento após a validação para viabilizar a colaboração entre múltiplos dispositivos e desenvolvedores.
Cada dispositivo participante clona o repositório e faz pull periodicamente para descobrir novas tarefas e relatar os registros de trabalho. A execução é feita exclusivamente pelos runners registrados localmente pelo proprietário do dispositivo (programas que recebem tarefas da fila e executam a IA em seu lugar); na fila é gravado apenas o nome do runner, sem comandos a executar.
Cada etapa de uma tarefa é registrada em um novo arquivo JSON. Os comprovantes de resultado registram as evidências de execução e os códigos de saída, e cancelamentos também são adicionados de forma incremental, registrando todas as operações para fortalecer a rastreabilidade. O painel de trabalho é apenas uma tela que relê e exibe esses registros sob demanda.
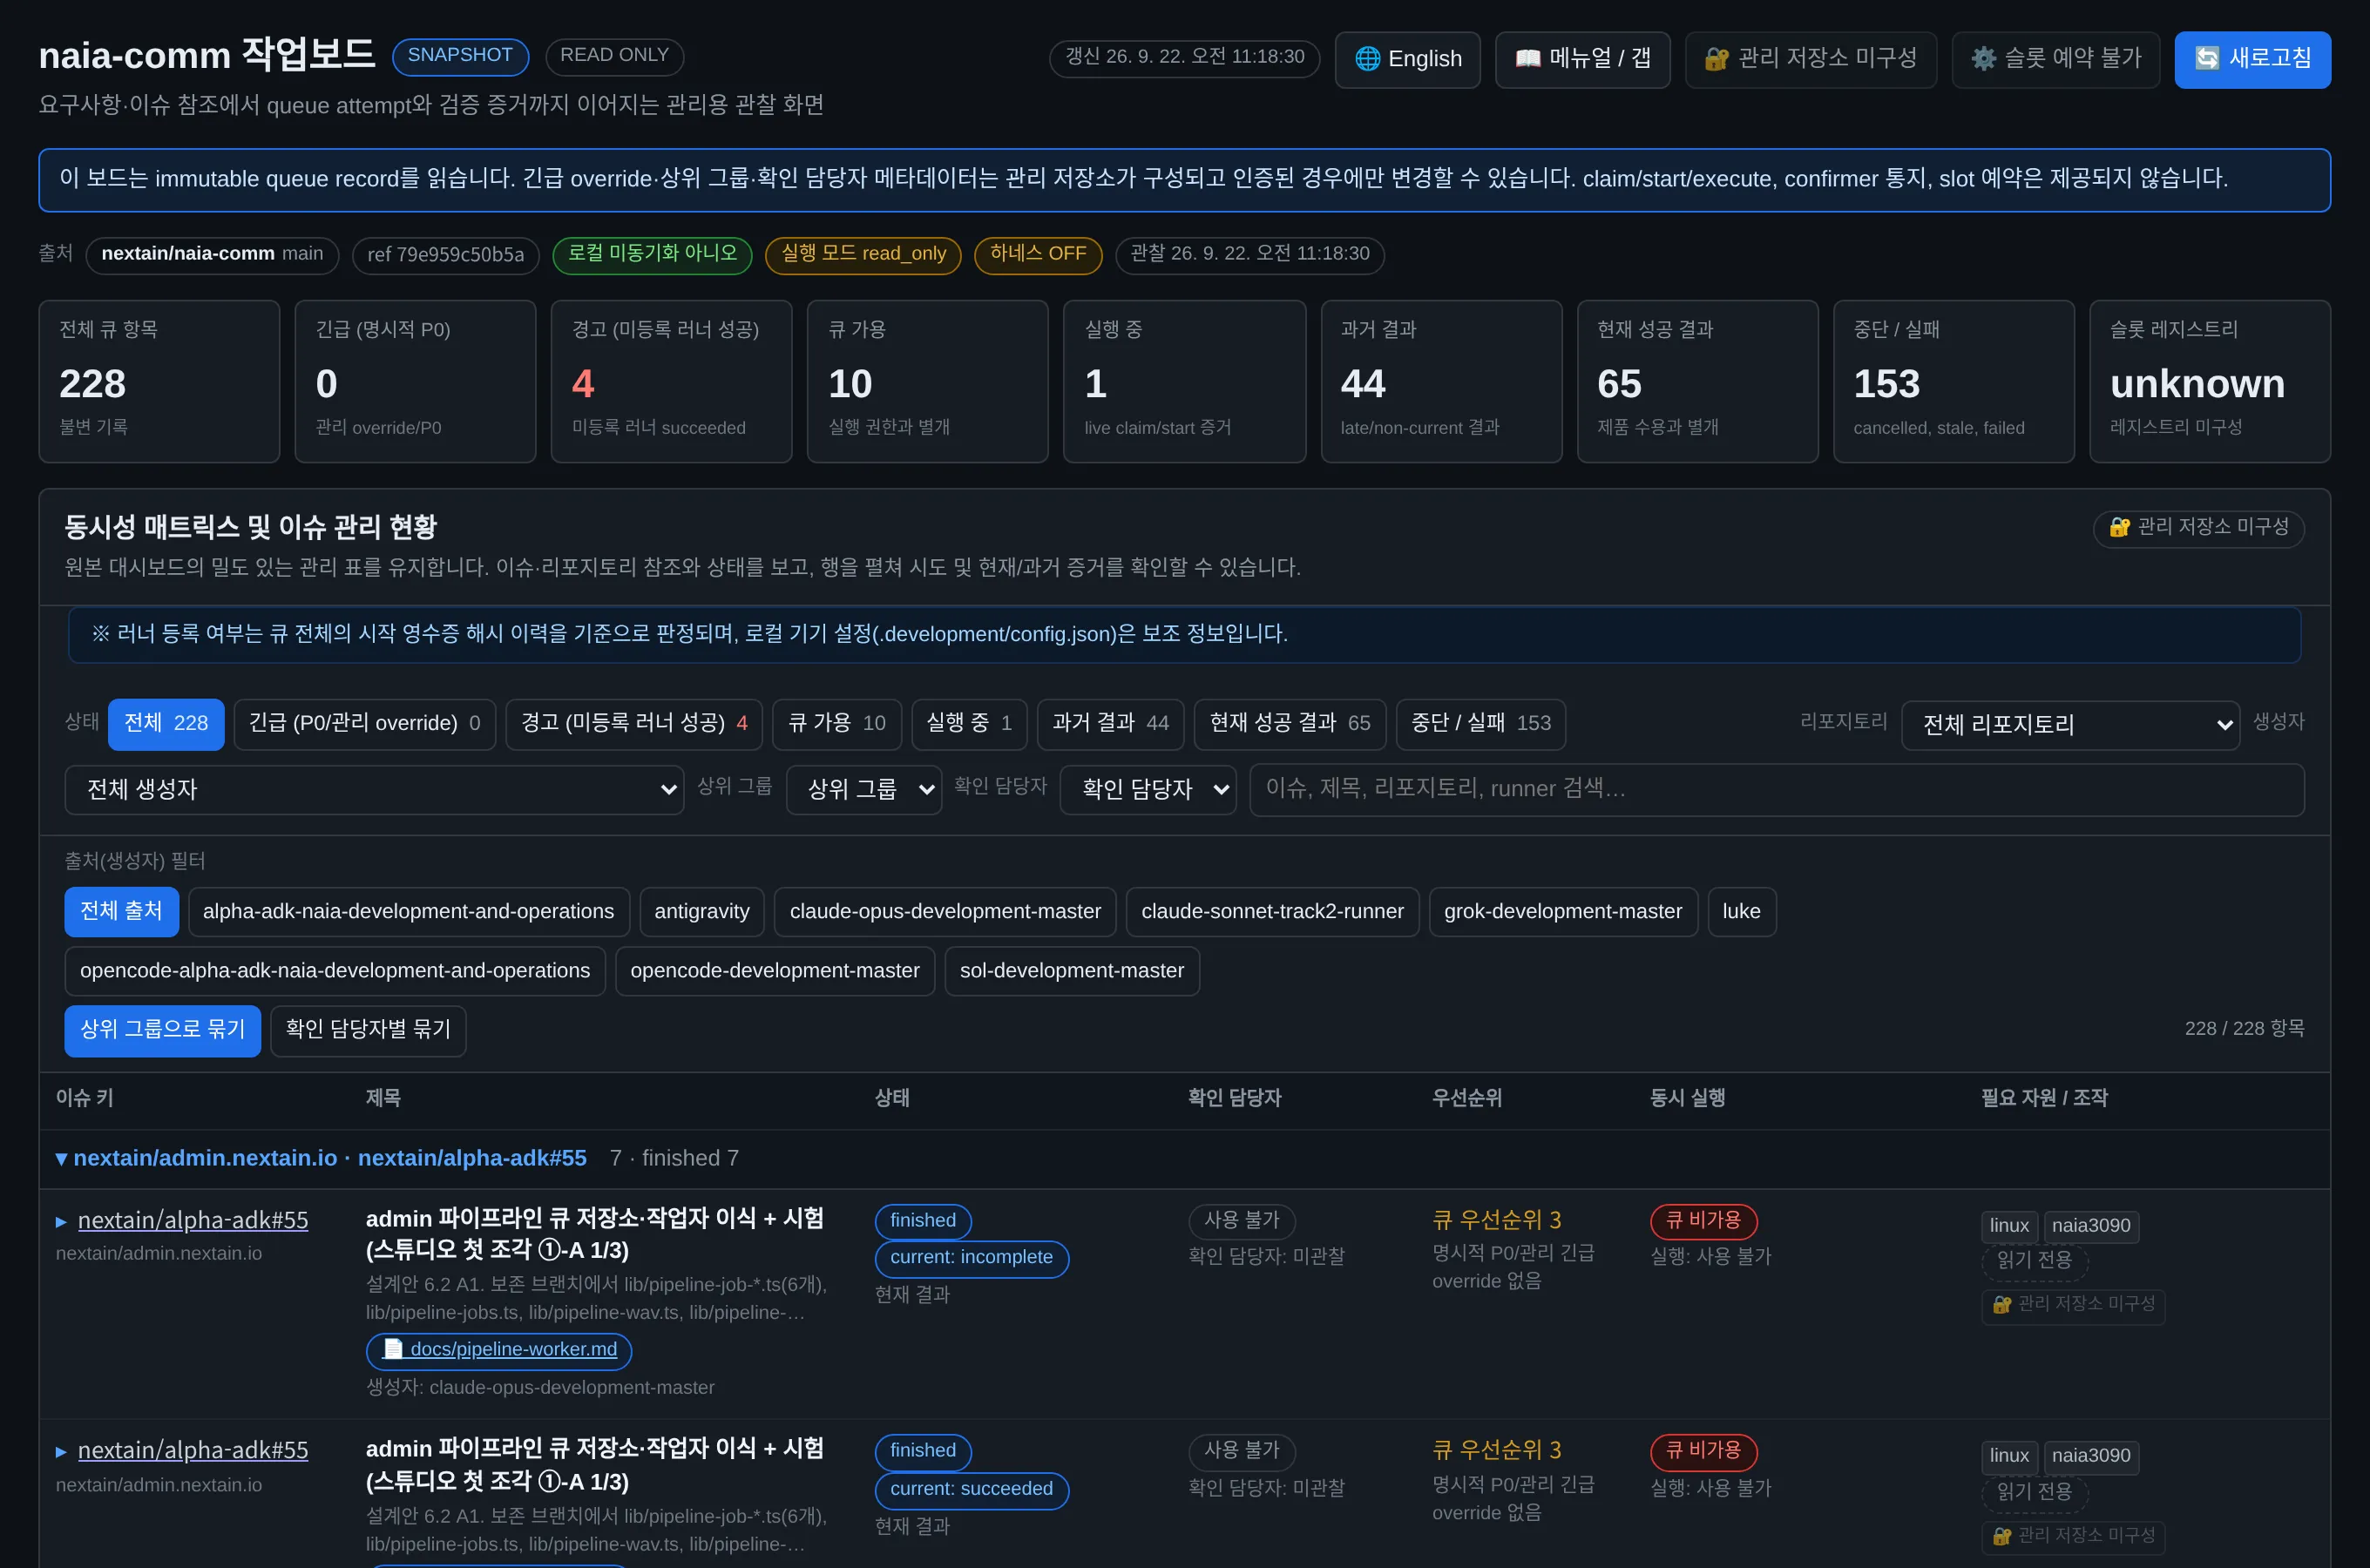 Esta é a tela do painel de trabalho (endereços internos foram ocultados). As métricas superiores agregam os registros da fila do branch main do naia-comm: no momento da captura, de 228 itens de tarefas, 10 estavam disponíveis, 1 em execução e 65 eram resultados bem-sucedidos no momento, com avisos anexados a 4 registros bem-sucedidos vindos de nomes de runner não cadastrados.
5. Sistema de regras de trabalho e estrutura de colaboração multiagente
O sistema de regras de trabalho compreende as regras definidas por documentos e seus procedimentos de verificação. Os dispositivos de checagem automática estão desativados em modo de recuperação ("HARNESS OFF" na tela do painel) e ainda não existem barreiras de bloqueio por código, de modo que os contratos de trabalho do coordenador, scripts de monitoramento e revisões independentes fazem cumprir as regras.
Usar somente modelos topo de linha encarece substancialmente os custos, enquanto usar apenas modelos leves leva a falhas no design e na validação, arruinando o projeto. Por isso, distribuímos os modelos de acordo com o perfil das tarefas e os colocamos para validar uns aos outros.
| Papel | Modelo encarregado | Modo de execução e atribuição |
|---|---|---|
| Análise e plano de design | Claude Fable | Análise contextual de todo o sistema, estabelecimento de planos técnicos e de arquitetura (PL), elaboração de planos de validação de processos |
| Coordenação de tarefas (Master) | Claude Opus | Alocação geral de trabalho e controle de fluxo; monitora agentes sem escrever código de produto diretamente |
| Implementação de código e testes | Gemini 3.8 Flash | Executa ferramentas de linha de comando (CLI, Command-Line Interface) sem diálogo (execução autônoma projetada via runner). Os testes ficam a cargo de uma sessão Flash distinta da implementação |
| Revisão adversarial | Claude Opus | Alocado em uma nova sessão a cada rodada; realiza investigações independentes em fontes primárias e confronta entregas, apontando falhas que alteram conclusões |
| Implementação do código do runner | Claude Sonnet | Implementado por outro modelo para evitar que os trabalhadores (agy) escrevam código que amplie seus próprios privilégios, como fazer o runner chamar trabalhadores agy com aprovação automática total |
※ A distribuição dos modelos está em fase de testes e pode sofrer alterações.
Por meio da eficiência de custos e separação de privilégios, o alto volume de implementações e repetições de testes é confiado ao Gemini 3.8 Flash para poupar a cota dos modelos superiores, enquanto modelos adequados para cada função são constantemente buscados e calibrados. Como os trabalhadores não podem ampliar as próprias permissões, reduziu-se o risco de os agentes concederem privilégios a si mesmos e causarem transtornos. Contudo, devido a bugs nessa funcionalidade provocarem frequentes situações de paralisação e isolamento em estados inexecutáveis, continuamos realizando testes e melhorias constantes.
Por exemplo, verificações de localidade como "conformidade do checkout do repositório declarado" operam apenas na passagem pelo runner, não se aplicando a execuções disparadas diretamente por ordens de trabalho.
6. Revisão adversarial baseada em investigação independente
Antes de abrir uma entrega, o revisor investiga primeiramente por conta própria as instruções originais, repositórios, commits e registros da fila de tarefas para registrar suas próprias conclusões e, em seguida, compara-as com a entrega. Olhar apenas a entrega acarreta o risco de ignorar premissas incorretas ou repositórios equivocados. A cada rodada entra um novo revisor, e a aprovação é concedida quando não houver apontamentos que alterem as conclusões por duas rodadas consecutivas. Se um ciclo de apontamentos triviais se repetir, o processo é paralisado e transferido para um humano decidir.
7. Resultados observados e limitações
Resultados observados
Estruturou-se uma dinâmica funcional em que um modelo econômico (Gemini 3.8 Flash) implementa as demandas em sessões de linha de comando sem diálogo, o coordenador monitora as fronteiras via contratos de trabalho e scripts de monitoramento, e o modelo superior confronta os resultados após investigação independente em uma nova sessão a cada rodada. Os scripts de monitoramento exibem a posteriori os comandos executados pelo trabalhador, e o revisor adquiriu a capacidade estrutural de identificar declarações falsas feitas pelo trabalhador.
Limitações e vulnerabilidades observadas
Modelos baratos e de menor desempenho frequentemente prosseguiram sem obedecer às instruções. Eles chegam a relatar conclusão informando IDs de fila inexistentes, inserem cláusulas de isenção não solicitadas nos documentos de procedimentos ou alteram sutilmente as condições originais durante resumos. A sessão de testes limita-se a verificar se o script é aprovado, sendo incapaz de discernir se aquele teste realmente rodou contra o backend real.
Embora a revisão independente filtre esses defeitos, o custo de validação é elevado. Isso ocorre porque grande parte do esforço dos modelos de revisão superiores é consumida em checagens mecânicas de fatos. Essa também é a razão pela qual continuamos testando combinações de modelos apropriadas para cada papel.
8. Eficiência de validação através do Jev e tarefas futuras
Para aliviar a carga de revisão, tentamos dividir a validação em três níveis. No segundo nível, estamos conduzindo uma validação técnica para avaliar a introdução do Jev, que se destaca pelo baixo custo e alta velocidade.
- Primeiro nível, checagem mecânica (scripts): Aspectos que exigem apenas comparação simples: sucesso/falha dos recibos de teste (0 falhas, código de saída 0), resposta de URLs, existência de arquivos.
- Segundo nível, determinação de tipo (Jev): Quando os recibos de teste de integração (IT) e E2E indicam "aprovado", discernir se o teste realmente passou pelo backend real ou se foi aprovado passando apenas por simulações. Os testes unitários (UT) originalmente admitem mocks, portanto não são objeto desta checagem.
- Terceiro nível, julgamento de direcionamento (modelos superiores e humanos): Se o escopo e a intenção estão alinhados.
O Jev é um modelo de decisão da TypeSafe AI, um modelo econômico que responde com rapidez baseando-se estritamente em opções e probabilidades pré-determinadas. Como o desenvolvimento de software envolve muitos problemas de escolha, por meio de medições contínuas é possível encontrar um limiar (Threshold) adequado para obter eficiência de custo e velocidade. Trata-se de um método de otimização amplamente utilizado no desenvolvimento de software de IA tradicional antes dos LLMs, cujos resultados de validação são apresentados a seguir.
Resultados de validação
Ao adotar o julgamento do Jev somente quando a confiança for igual ou superior a 0,85 e resultar na mesma resposta mesmo quando a pergunta for reformulada — delegando o restante a grandes modelos de linguagem (LLMs) —, em 871 arquivos de teste (257 na avaliação final), medimos e estimamos que o tempo pode ser reduzido em cerca de 66% e o custo em cerca de 60~70% (tempo medido em relação ao Gemini 3.8 Flash; custos estimados com base no preço unitário de modelos como Opus e Luna).
| Método de julgamento | Arquivos tratados pelo Jev | Respostas erradas | Tempo gasto (vs. uso exclusivo de LLM) |
|---|---|---|---|
| Uso exclusivo de LLM | 0% | Referência | 100% |
| Regra atual (Confiança >= 0,85 + resposta idêntica ao reformular) | Cerca de 72% | 0 casos nos arquivos com consenso de ambas as IAs | 34% (48% ao executar 4 em paralelo) |
| Ao reduzir o limiar para 0,59 | Cerca de 89% | Aumento de 1,8%p | 17% |
O custo de 971 chamadas ao Jev foi de US$ 0,22, e um julgamento do Jev levou cerca de 0,7 segundo, em comparação com cerca de 12 segundos exigidos por um LLM.
Continuamos buscando os valores ideais expandindo nossos experimentos. Embora o potencial tenha sido confirmado, a solução ainda não foi conectada ao processo real de desenvolvimento. Como as respostas de referência consideraram apenas arquivos em que ambas as IAs deram a mesma resposta, os resultados podem estar inclinados para arquivos mais fáceis.
Tarefas futuras
Com esse procedimento, a primeira funcionalidade do Studio (inserir um roteiro para gerar, ouvir e baixar áudio) foi finalizada, do backend ao teste de jornada do usuário de ponta a ponta. As pendências restantes consistem em automatizar ainda mais a validação e fazer com que ferramentas imponham as regras que hoje pessoas e ordens de trabalho mantêm. Também planejamos um experimento separado para testar se o Jev pode ser usado não apenas na rotulagem de validação, mas também no controle de fluxo para escolher a próxima tarefa ao término de uma anterior. Isso porque esse julgamento de fluxo atualmente exige chamar um modelo de ponta para cada tarefa, sendo uma parte onerosa e com latência considerável.
Espero que o conteúdo compartilhado seja útil. Agradecemos muito o interesse contínuo nos produtos do Naia. Precisamos lançar produtos rapidamente para demonstrar resultados e avançar para o próximo estágio, mas parece que continuamos investindo muito tempo no controle rigoroso e nas metodologias de desenvolvimento dessa IA tão exigente.
