Документоориентированный процесс разработки с несколькими ИИ в Naia ADK: тестирование эффективности с Jev
 Здравствуйте. Я Люк, создатель Naia.
Naia может показаться обычным пользователям продуктом персонажных агентов, однако значительная часть моей повседневной работы связана с разработкой программного обеспечения. Поэтому мы создаем соответствующую инфраструктуру разработки и ведем разработку ПО для корпоративных клиентов с использованием инфраструктуры Naia. Ранее я публиковал книгу под названием «Инженерия Harness: разработка программного обеспечения с ИИ с нуля (Re:Zero)» (корейское издание, английское издание). С тех пор мы продолжаем прикладывать большие усилия для того, чтобы еще лучше выстроить процесс разработки на базе ИИ-агентов.
Сегодня я представляю процесс разработки ПО и рабочие материалы, созданные для разработки Naia, и рассказываю о том, как мы пытаемся внедрить в этот процесс популярную модель принятия решений Jev.
В этом процессе разработки я стремился достичь трех главных целей: прозрачности, параллелизации и оптимизации затрат.
- Прозрачность : Знать, правильно ли идет разработка, и в случае дрейфа модели точно понимать, на каком этапе возникла проблема.
- Параллелизация : Параллельно распределять задачи между несколькими агентами для ускорения темпов разработки.
- Оптимизация затрат : Использовать оптимизированные по стоимости модели. Jev служит здесь отличной альтернативой.
Базовая структура нашей системы правил работы (Harness) опубликована как открытый исходный код по ссылкам ниже:
- Базовая структура персонального рабочего пространства и система правил работы (Harness): nextain/naia-adk
- Базовая структура для командного и проектного взаимодействия: nextain/naia-pj-adk
- Руководство по участию в сообществе: nextain/naia-comm-public
- Jev — это модель принятия решений, представленная TypeSafe AI.
Описанные в этой статье очередь задач, доска, раннер и документы планирования все еще находятся на этапе внутренней разработки и пока закрыты. В настоящее время этот процесс также проходит стадию проверки на новой функции для веб-платформы Naia: разработке Naia Visual Agent Studio — видеоаватара с поддержкой синхронизации губ и пения. Причина, по которой эти материалы пока не открыты, заключается в том, что они еще недостаточно доработаны для совместного использования в командных проектах; по мере систематизации мы откроем их.
Сокращения, используемые в этой статье и наших документах по разработке
Прежде всего, в наших документах по разработке, задачах и очередях задач используются следующие сокращения, и в проекте есть стандартный словарь терминов. Это связано с тем, что мне не хотелось вводить длинные промпты для ИИ, а также во избежание терминологической путаницы.
| Сокращение | Полное название | Термин | Определение в одну строку |
|---|---|---|---|
| PC | Product / Project Concept | Верхнеуровневое планирование | Зачем мы это создаем: сущность продукта, смысл существования, ценность для пользователя, общая информационная архитектура |
| SP | Screen Plan | Проектирование экранов | Структурная схема экранов, которые увидит пользователь (макет, расположение, навигация) |
| UC | User Scenario | Путь пользователя (пользовательский сценарий) | Полный путь пользователя от входа в определенном контексте до достижения цели и выхода |
| RQ | Requirements | Требования | Условия и измеримые критерии приемки, которым должна соответствовать система для удовлетворения UC и SP |
| PL | Plan / Architecture | Технический анализ и план архитектуры | Проверка технических реалий практическими измерениями и составление архитектурного и поэтапного плана реализации |
| FE | FEature | Спецификация функций | Конкретные функциональные единицы для реализации UC и RQ. Это не фронтенд (Frontend) |
| UT | Unit Test | Модульное тестирование | Проверка соответствия функциональной единицы спецификации |
| IT | Integration Test | Интеграционное тестирование | Тест, сквозным образом проходящий реальные компоненты бэкенда без интерфейса. Это не информационные технологии (IT) |
| E2E | End-to-End Test | Сквозное тестирование пути пользователя | Тест, проходящий единый путь пользователя от реального интерфейса до реального бэкенда |
| QC | Quality Control / Validation | Независимая приемка | Агрессивная проверка обещаний продукта исключительно по PC и SP без просмотра сценариев разработчика и внутренней реализации |
1. Предпосылки внедрения и осознание проблем
Если широко доверить разработку ИИ-агентам, они начинают создавать пользовательский интерфейс (UI, User Interface) без бэкенда или отчитываются об успешном прохождении тестов, выполненных с мок-объектами. Поэтому мы ведем планирование сверху вниз (Top-down), а разработку снизу вверх (Bottom-up). Планирование спускается от общего пользовательского опыта, а разработка строится от минимальных работающих единиц, причем интерфейс подключается только после того, как бэкенд реально заработал. Создание экранов с самого начала с высокой вероятностью приводит к масштабным переделкам при интеграции.
2. Документоориентированный рабочий процесс и процесс разработки
Написание документов в первую очередь служит для предварительной фиксации объема работ и критериев приемки. Документируя требования вместо простых промптов, мы можем проследить первопричину при возникновении проблем.
Мы выстраиваем все документы процесса разработки в единый список и только после проверки человеком создаем задачи (Issues) и элементы очереди задач. Прежде чем создать новую задачу, ИИ проверяет, с какими документами она связана, а также просматривает ранее открытые задачи. Только при наличии задач, элементов очереди и квитанций о прохождении тестов можно вынести решение о завершении задания.
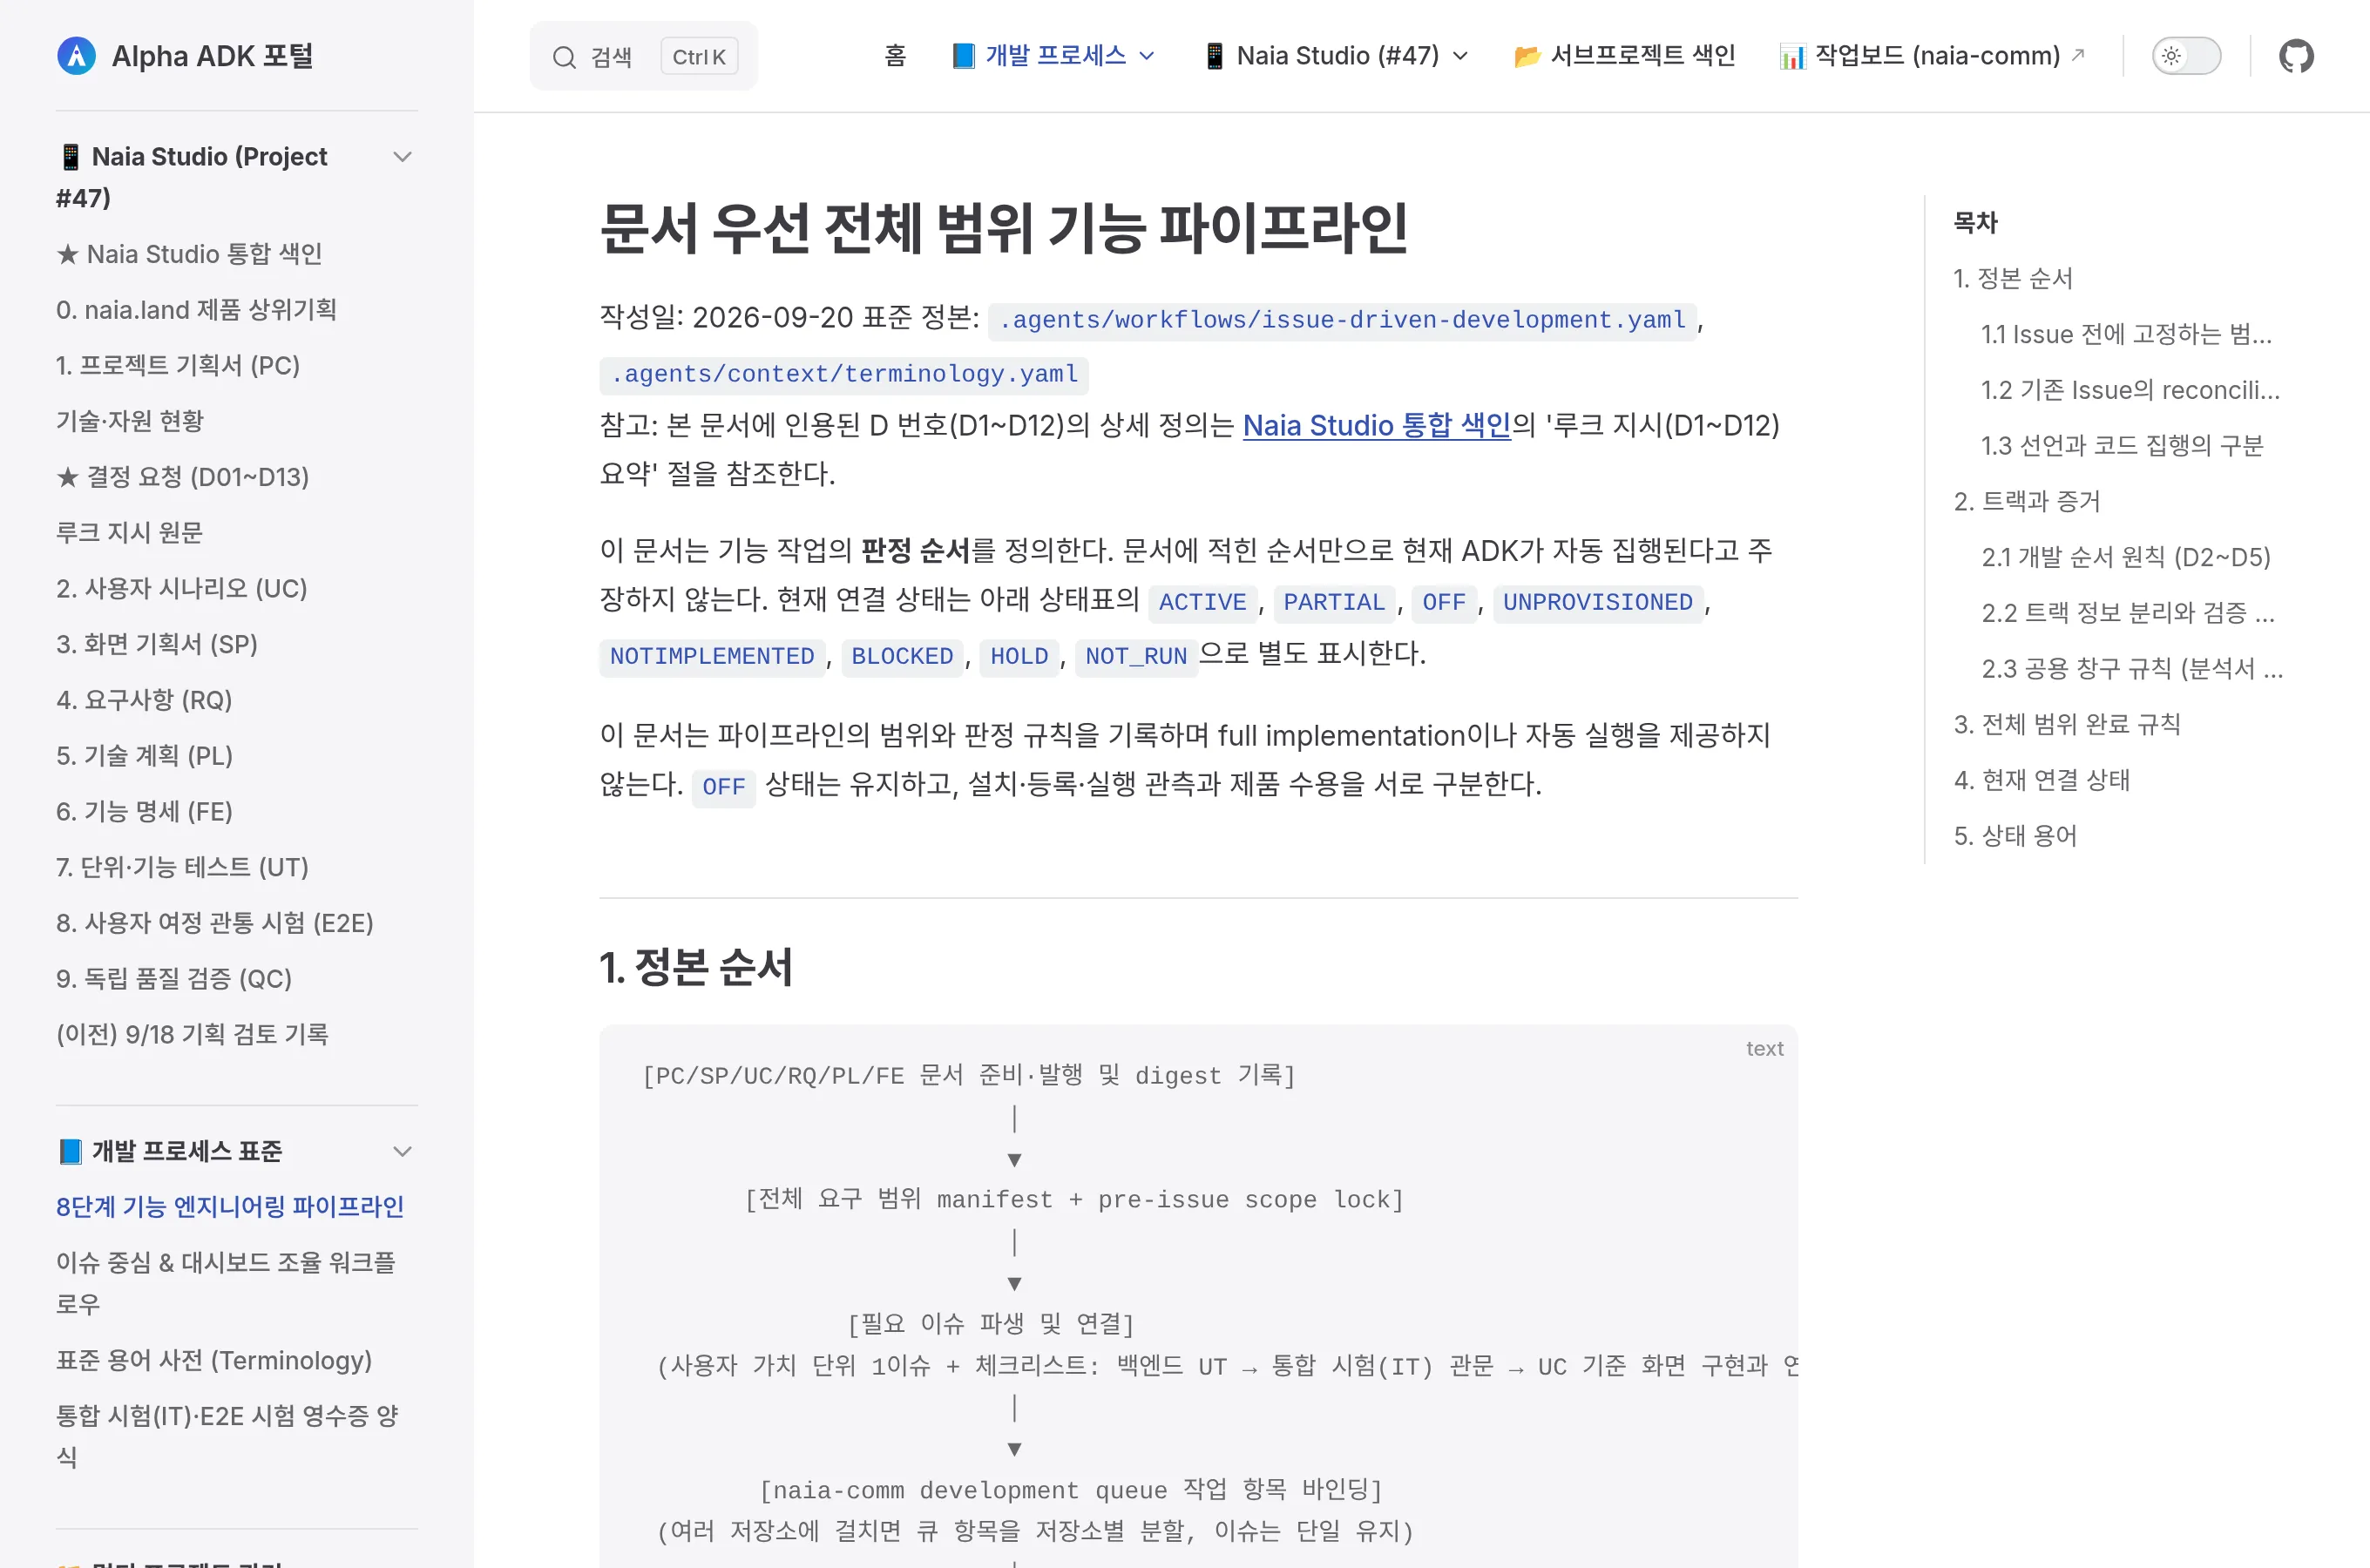 Страница процедур разработки в просмотрщике документов.
Документы выстраиваются в порядке схемы: от того, зачем мы строим (PC), до единиц функций, которые предстоит создать (FE), а проект архитектуры (PL) составляется только после практического замера ограничений моделей и движков. Задачи не разделяются по технологическим слоям, а создаются строго по одной на единицу пользовательской ценности, даже если затрагивают несколько репозиториев. Все этапы от бэкенда до приемки задаются внутри этой задачи в виде чек-листа во избежание пропусков, а завершение констатируется только тогда, когда весь зафиксированный документацией объем подкреплен доказательствами.
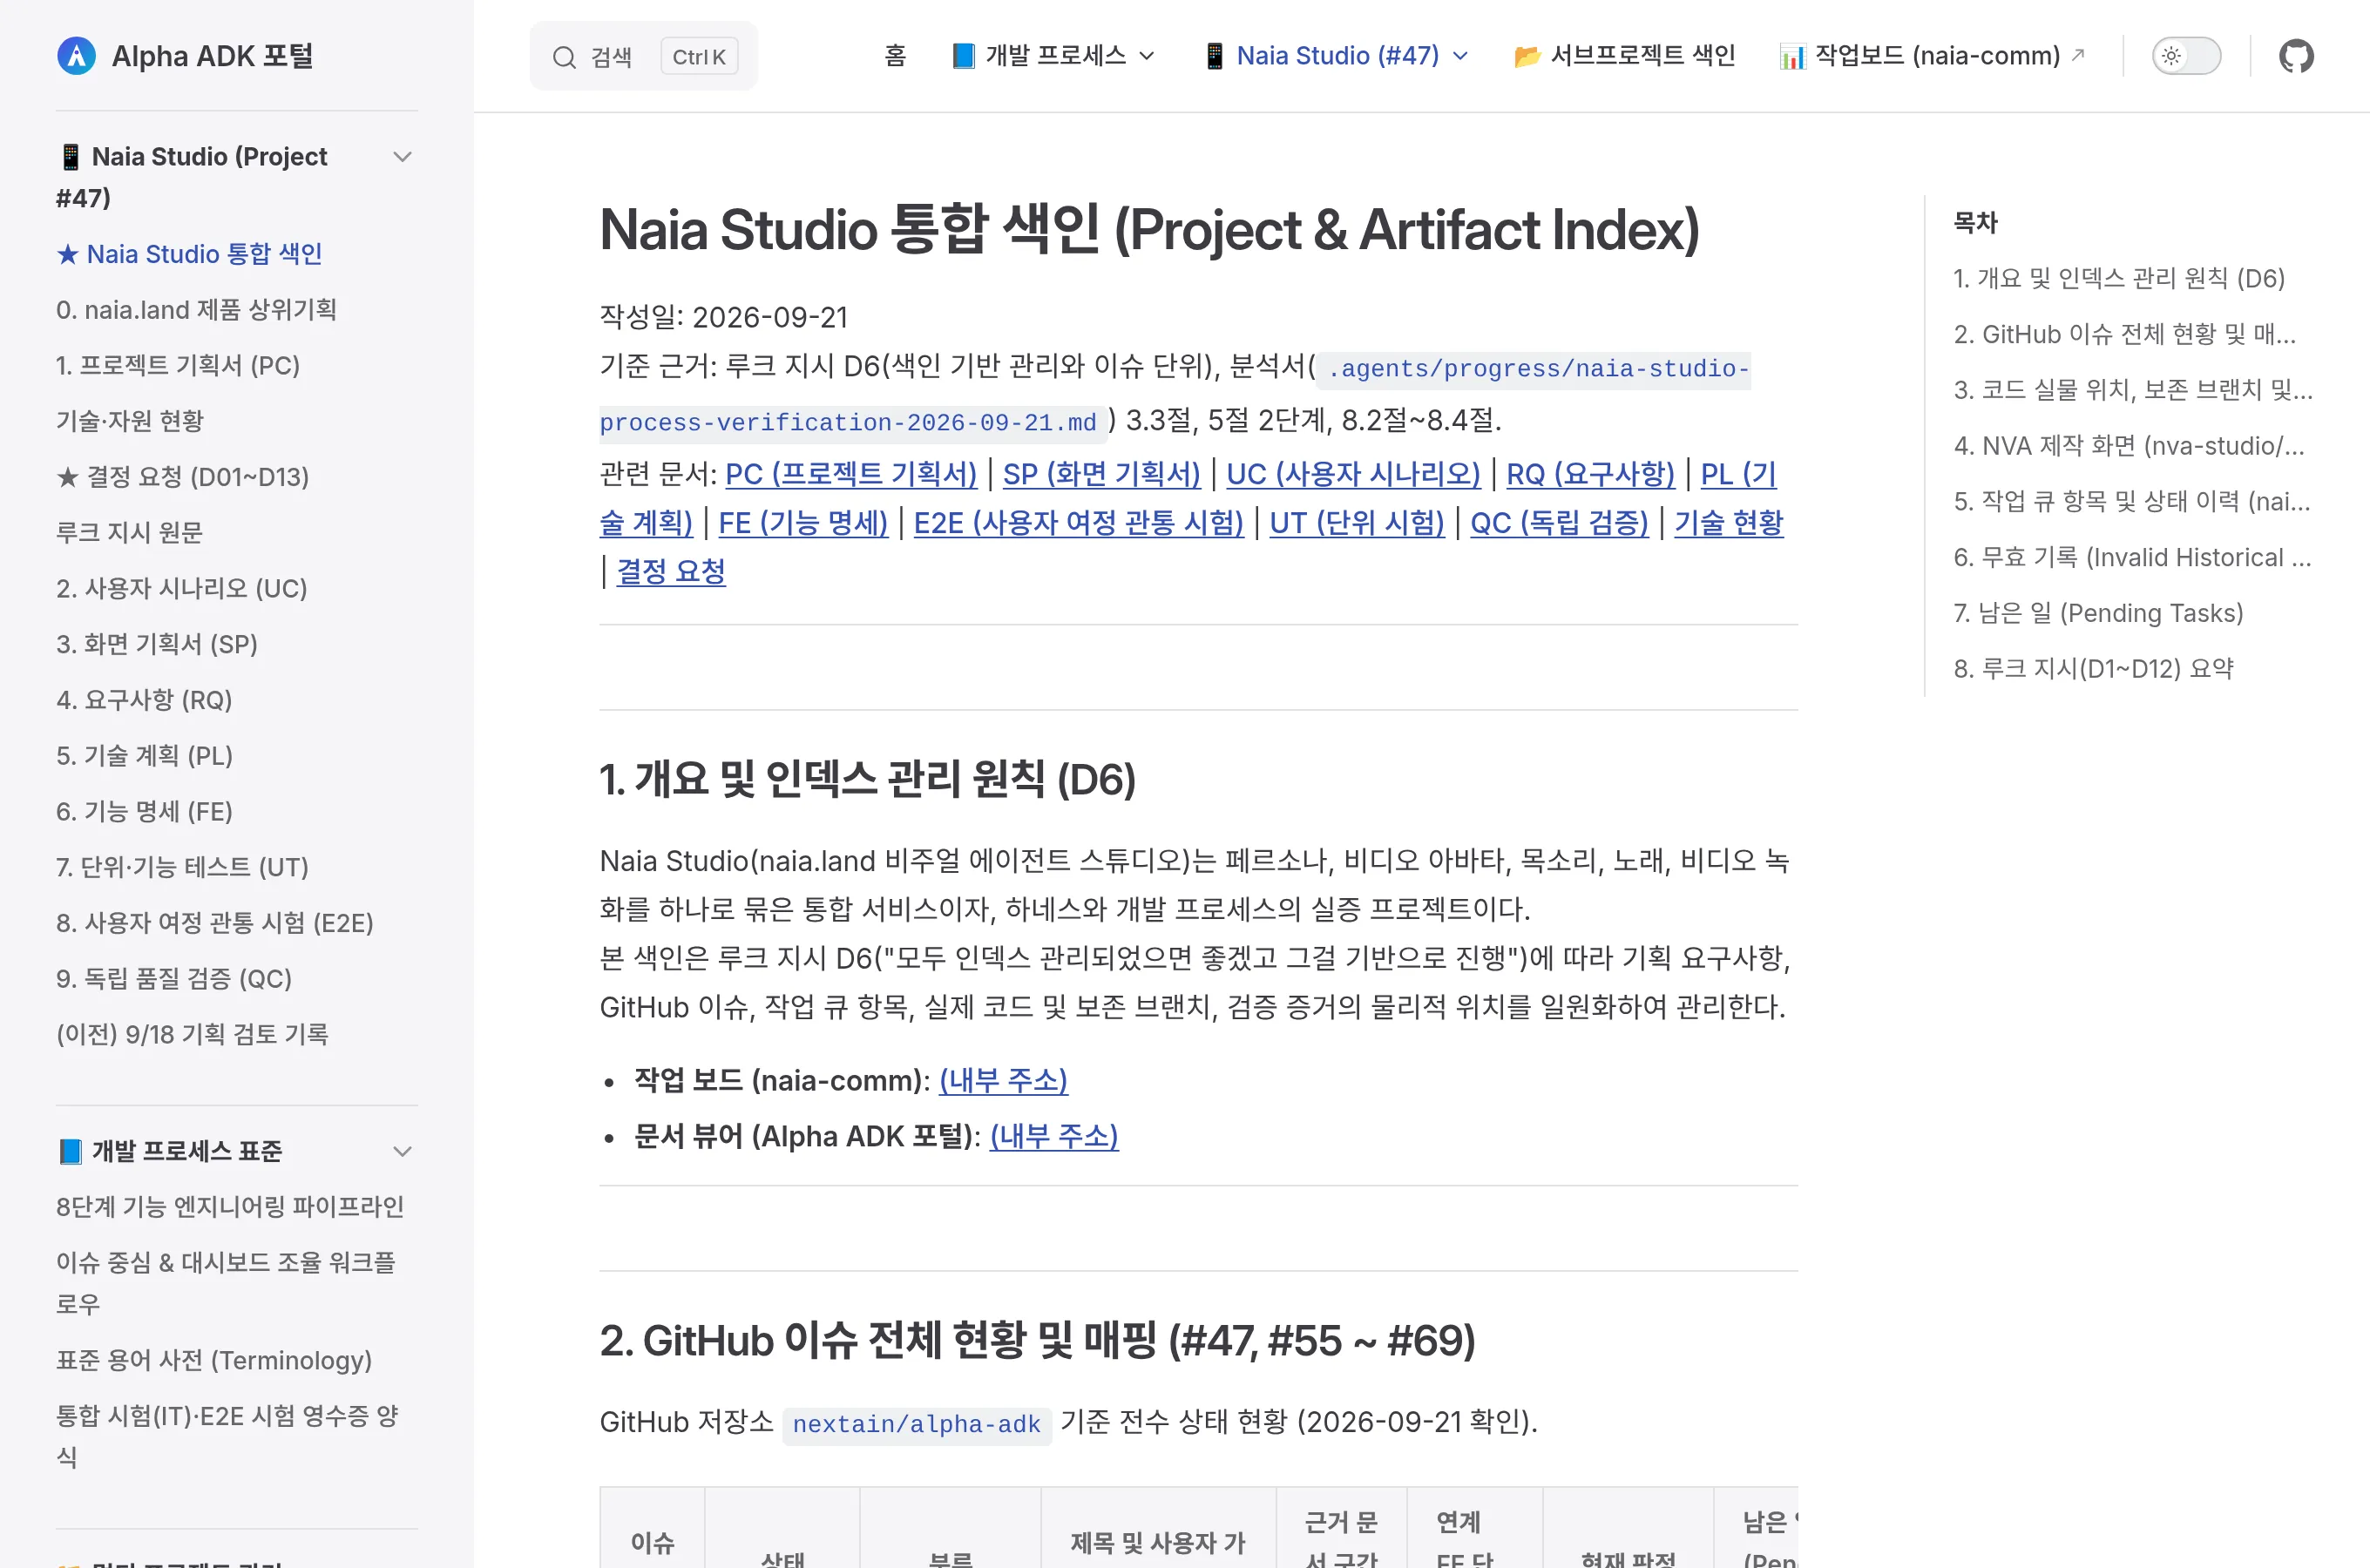 Интегрированный индекс Studio, позволяющий в одном месте видеть задачи, места реализации и статус валидации для каждого раздела документа планирования.
3. Трехуровневая структура тестирования и правила очередности
Тестирование разделяется на три уровня в соответствии с отраслевыми стандартами.
- Модульное тестирование (UT): Проверяет, работает ли функциональная единица (FE) в соответствии со спецификацией.
- Интеграционное тестирование (IT): Проходит через реальные компоненты бэкенда без интерфейса. Тесты, прошедшие только через мок-объекты, не признаются.
- Сквозное тестирование пути пользователя (E2E): Проходит единый путь пользователя от реальных экранов браузера до реального бэкенда. Без E2E интеграционным тестом закрываются только единицы без интерфейса в SP; если экран предусмотрен, E2E обязателен, даже если текущее изменение затрагивает только бэкенд. Ориентиром служит SP, а не диффы разработчика.
Ключевым моментом является очередность: фронтенд (интерфейс) разрабатывается только после того, как бэкенд пройдет интеграционный тест (IT). В настоящее время эта последовательность не блокируется Harness аппаратно, а контролируется заданиями и независимыми проверками по квитанциям, что оставляет возможности для улучшений.
Независимая приемка (QC) выполняется отдельно от тестов разработчика. Не заглядывая в UC и FE, она агрессивно проверяет выполнение обещаний продукта при некорректном вводе и исключительных ситуациях исключительно на основе PC и SP. Знакомство с UC и FE может привести к тому, что проверка ограничится лишь этими узкими рамками. Поскольку этот шаг находится на поздней стадии разработки, эмпирической валидации в полном объеме он пока не прошел.
4. Очередь задач на базе Git и рабочая доска
Чтобы иметь достоверную информацию о том, кто, когда и что сделал, задачи управляются через очередь задач в Git-репозитории (naia-comm). Общего сервера пока нет; цель состоит в том, чтобы развернуть сервер разработки после проверки и наладить сотрудничество между несколькими устройствами и разработчиками.
Каждое участвующее устройство клонирует репозиторий, периодически подтягивает обновления для поиска новых задач и передает отчеты о работе. Выполнение осуществляется исключительно раннерами, зарегистрированными владельцем устройства локально (программами, которые забирают задачи из очереди и запускают ИИ от их имени); в очереди указывается только имя раннера, а исполняемые команды туда не записываются.
Каждый этап задачи оформляется новым JSON-файлом. В квитанциях результатов фиксируются доказательства выполнения и коды выхода, а отмены добавляются аналогичным образом, что позволяет протоколировать все операции и повысить прослеживаемость. Рабочая доска — это всего лишь экран, который перечитывает эти записи по запросу и отображает их.
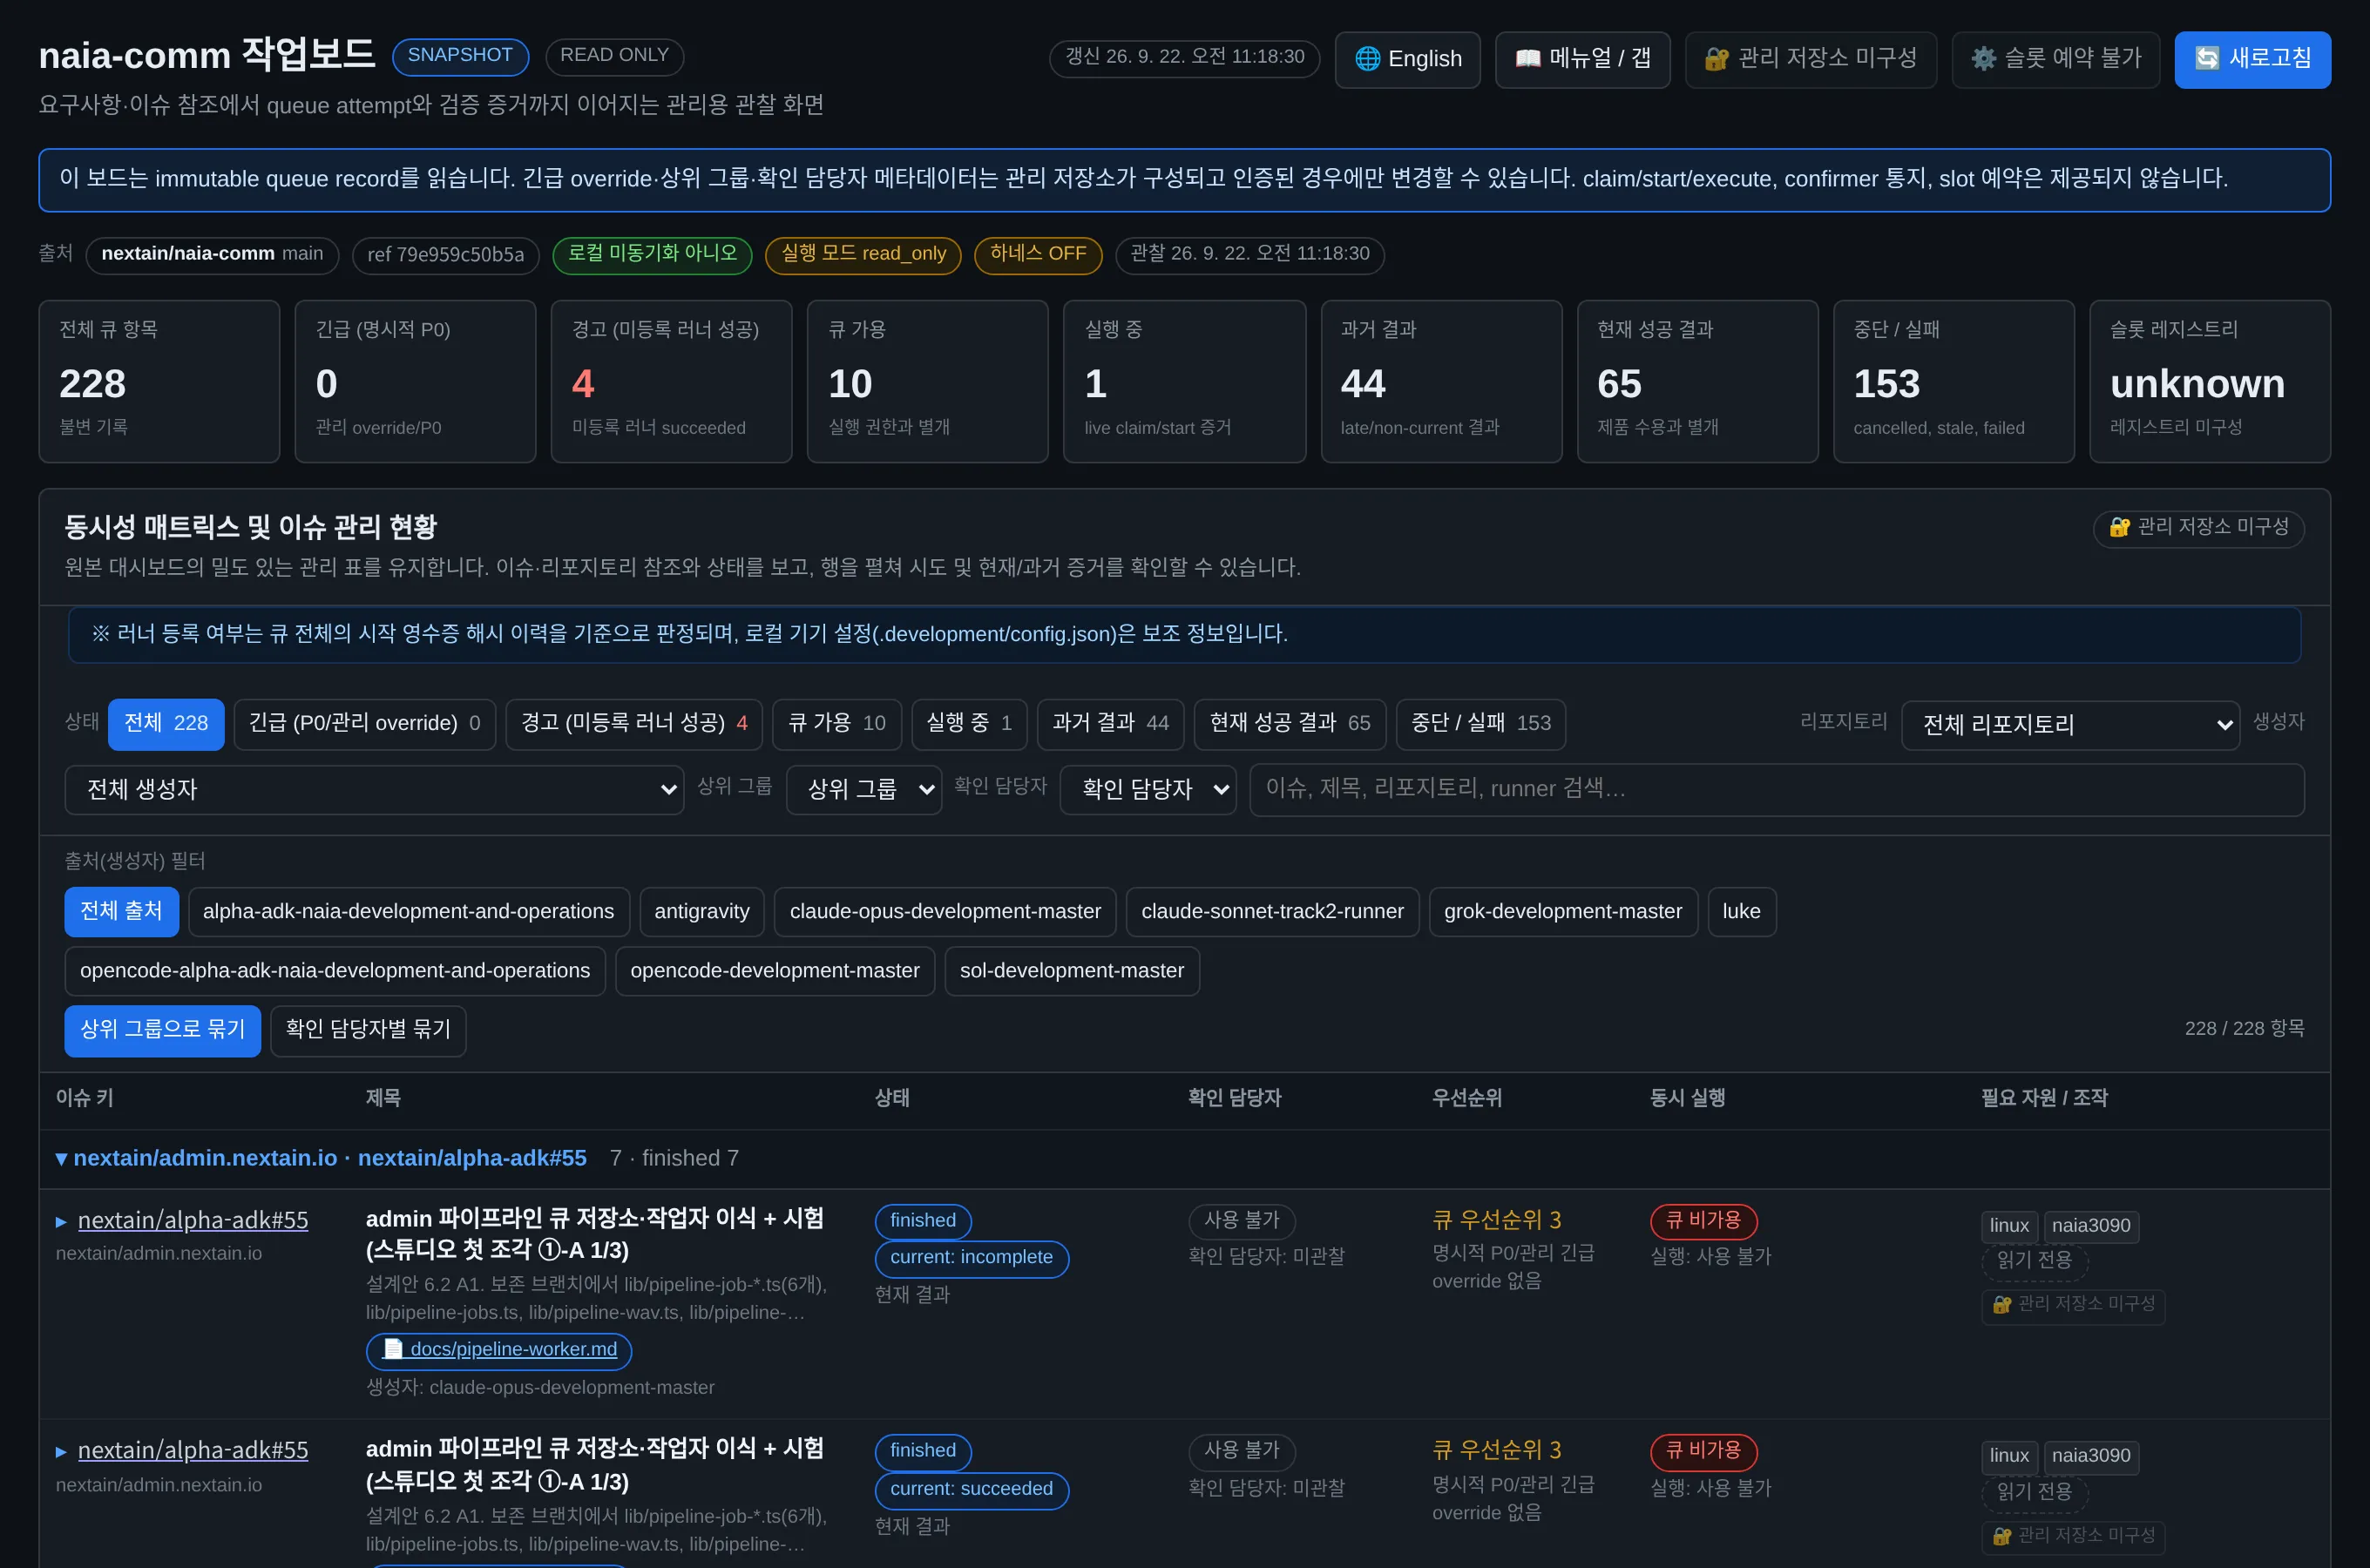 Это экран рабочей доски (внутренние адреса скрыты). Верхние показатели агрегируют записи очереди ветки main naia-comm: на момент снимка из 228 элементов задач доступно было 10, в процессе выполнения — 1, текущих успешных результатов — 65, а на 4 успешных записях с незарегистрированными именами раннеров стояли предупреждения.
5. Система правил работы и структура взаимодействия нескольких агентов
Система правил работы — это зафиксированные в документах правила и процедуры их проверки. Автоматические средства контроля сейчас отключены в режиме восстановления («HARNESS OFF» на экране доски), а кодовые барьеры еще не созданы, поэтому соблюдение правил обеспечивается рабочими заданиями координатора, скриптами мониторинга и независимыми проверками.
Использование исключительно топовых моделей ведет к резкому росту затрат, а применение только легких моделей приводит к сбоям в проектировании и проверке, разрушая проект. Поэтому мы распределяем модели в зависимости от характера задач и обеспечиваем их взаимную перекрестную проверку.
| Роль | Назначенная модель | Способ выполнения и обязанности |
|---|---|---|
| Анализ и план архитектуры | Claude Fable | Анализ общего контекста системы, составление плана технического анализа и архитектуры (PL), проектирование плана валидации процессов |
| Координация задач (Master) | Claude Opus | Общее распределение задач и контроль потока выполнения; мониторинг агентов без прямого написания кода продукта |
| Реализация кода и тестирование | Gemini 3.8 Flash | Выполнение инструментов командной строки (CLI, Command-Line Interface) без диалога (автономное выполнение через раннер). Тестирование поручается сессии Flash, отличной от сессии реализации |
| Состязательное ревью | Claude Opus | Подключение новой сессии в каждом раунде; проведение независимого расследования первоисточников и сверка сданных материалов, выявление дефектов, меняющих выводы |
| Реализация кода раннера | Claude Sonnet | Код, расширяющий собственные привилегии исполнителя (например, вызов агентов agy раннером с полным автоматическим одобрением), пишется другой моделью, а не самим исполнителем (agy) |
※ Распределение моделей находится на стадии экспериментов и может быть изменено.
Благодаря ценовой эффективности и разделению привилегий большие объемы реализации и итераций тестирования поручаются Gemini 3.8 Flash для экономии лимитов старших моделей, а подходящие модели для каждой роли непрерывно подбираются. Исполнители не могут самостоятельно расширять свои права, что снижает риск того, что агент самовольно предоставит себе полномочия и вызовет проблемы. Однако из-за ошибок в этой функциональности часто возникают ситуации, когда задачи застревают в изолированном неисполняемом состоянии, поэтому мы ведем постоянное тестирование и доработку.
Например, проверки местоположения, такие как «соответствие объявленного checkout репозитория», работают только при прохождении через раннер и не применяются к запускам, инициированным напрямую по рабочему заданию.
6. Состязательное ревью на основе независимого расследования
Прежде чем открыть представленные материалы, проверяющий сначала самостоятельно изучает первоначальные указания, репозиторий, коммиты и записи очереди задач, формирует собственные выводы и только затем сопоставляет их с отправленными материалами. Оценка исключительно представленных материалов чревата пропуском ошибочных предпосылок или неверно выбранных репозиториев. Каждый раз проверку проводит новый рецензент; если два раунда подряд отсутствуют замечания, меняющие выводы, задача считается пройденной. При возникновении повторяющегося цикла тривиальных придирок процесс останавливается и передается человеку для вынесения решения.
7. Наблюдаемые результаты и ограничения
Наблюдаемые результаты
Выстроена работающая структура, в которой низкозатратная модель (Gemini 3.8 Flash) выполняет реализацию в неинтерактивных сессиях командной строки, координатор контролирует границы с помощью заданий и скриптов мониторинга, а старшая модель сопоставляет результаты после независимого расследования в новой сессии каждого раунда. Скрипты мониторинга постфактум отображают команды, выполненные исполнителем, и проверяющий получает структурную возможность выявлять ложные утверждения исполнителя.
Наблюдаемые ограничения и уязвимости
Недорогие модели с более низкой производительностью часто продолжают работу без соблюдения инструкций. Они указывают несуществующие ID очереди и рапортуют о завершении, вставляют в процедурные документы незапрошенные исключения или незаметно меняют исходные условия при составлении резюме. Тестовая сессия лишь проверяет, прошел ли скрипт, не будучи способной различить, действительно ли тест выполнялся на реальном бэкенде.
Хотя независимое ревью отсеивает подобные дефекты, стоимость валидации высока. Это связано с тем, что ресурсы старших моделей тратятся на механическую проверку фактов. Это также является причиной того, почему мы продолжаем непрерывно тестировать конфигурации моделей для каждой роли.
8. Повышение эффективности проверки с помощью Jev и дальнейшие задачи
Чтобы снизить нагрузку на проверку, мы разделили валидацию на три уровня. На втором уровне мы сейчас проводим техническую проверку целесообразности внедрения Jev, преимуществами которой являются низкая стоимость и высокая скорость.
- Первый уровень, механическая проверка (скрипты): То, что требует простого сопоставления: статус прохождения квитанции теста (0 сбоев, код выхода 0), отклик URL, наличие файлов.
- Второй уровень, определение типа (Jev): Когда в квитанциях интеграционного теста (IT) и E2E указано «пройдено», определение того, прошел ли тест реальный бэкенд или завершился успехом исключительно на моках. Модульные тесты (UT) изначально допускают использование моков, поэтому под это не подпадают.
- Третий уровень, оценка направления (старшие модели и человек): Соответствие объему и замыслу.
Jev — это модель принятия решений от TypeSafe AI, недорогая модель, быстро отвечающая исключительно на основе заданных вариантов и вероятностей. В разработке ПО существует множество задач выбора, и путем непрерывных измерений можно найти подходящий порог (Threshold) для достижения эффективности по затратам и скорости. Этот метод оптимизации широко использовался в традиционной разработке ПО с применением ИИ до появления LLM; результаты проверки представлены ниже.
Результаты проверки
Используя решения Jev только при уверенности 0,85 и выше и при условии одинакового ответа при перефразировании вопроса, а остальное передавая большим языковым моделям (LLM), на 871 тестовом файле (257 в финальной оценке) мы замерили и оценили, что время можно сократить примерно на 66%, а затраты — примерно на 60–70% (время замерено относительно Gemini 3.8 Flash, затраты рассчитаны по ценам моделей уровня Opus и Luna).
| Метод принятия решений | Файлы, обработанные Jev | Ошибочные ответы | Затраченное время (относительно использования только LLM) |
|---|---|---|---|
| Использование только LLM | 0% | Базовый уровень | 100% |
| Текущее правило (уверенность >= 0,85 + одинаковый ответ при перефразировании) | Около 72% | 0 случаев в файлах согласия обоих ИИ | 34% (48% при параллельном запуске по 4) |
| При снижении порога до 0,59 | Около 89% | Увеличение на 1,8%p | 17% |
Стоимость 971 вызова Jev составила 0,22 доллара, а время одного решения у Jev заняло около 0,7 секунды по сравнению с примерно 12 секундами у LLM.
Мы продолжаем искать оптимальные параметры, расширяя эксперименты. Возможности подтверждены, однако в реальный процесс разработки система пока не встроена. Поскольку в качестве эталонных ответов использовались только файлы, где оба ИИ дали одинаковый ответ, выборка могла сместиться в сторону более простых файлов.
Дальнейшие задачи
С помощью этой процедуры первая функция Studio (ввод сценария для генерации, прослушивания и скачивания голоса) была завершена от бэкенда до сквозного тестирования пути пользователя. Среди оставшихся задач — дальнейшая автоматизация проверки и обеспечение соблюдения инструментами правил, которые сейчас контролируются людьми и инструкциями. Мы также планируем отдельный эксперимент, чтобы проверить, можно ли использовать Jev не только для отметки о проверке, но и для управления потоком при выборе следующей задачи после завершения текущей. Подобная оценка переходов в настоящее время требует вызова старшей модели для каждой задачи, что создает значительные финансовые и временные затраты.
Надеюсь, представленный материал окажется полезным. Просим вас проявить интерес к продуктам Naia. Нам нужно быстрее выпускать продукты и демонстрировать результаты для перехода на следующий этап, однако мы по-прежнему тратим огромное количество времени на методы строгого контроля и разработки требовательного ИИ.
