Proses Pengembangan Multi-AI Berbasis Dokumen di Naia ADK: Menguji Efisiensi dengan Jev
 Halo. Saya Luke, kreator Naia.
Naia mungkin terlihat seperti produk agen karakter bagi pengguna umum, tetapi sebagian besar pekerjaan sehari-hari saya adalah pengembangan perangkat lunak (SW). Oleh karena itu, kami membangun infrastruktur pengembangan untuk ini dan menjalankan pengembangan SW bagi klien korporat menggunakan infrastruktur pengembangan Naia. Sebelumnya, saya pernah menerbitkan buku berjudul "Harness Engineering: Rekayasa Perangkat Lunak AI Mulai dari Re:Zero" (edisi bahasa Korea, edisi bahasa Inggris). Sejak saat itu, kami terus berupaya keras untuk membangun proses pengembangan berbasis agen AI yang jauh lebih baik.
Hari ini, saya membagikan proses pengembangan SW dan hasil kerja yang dibuat untuk pengembangan Naia, serta bagaimana kami berupaya memperkenalkan Jev, model keputusan yang sedang populer belakangan ini, ke dalam proses pengembangan ini.
Ada 3 hal utama yang ingin saya kejar dalam proses pengembangan ini: visibilitas, paralelisasi, dan optimalisasi biaya.
- Visibilitas : Mengetahui apakah pengembangan berjalan dengan benar, dan jika terjadi penyimpangan model (drift), mengetahui persis di tahap mana masalah muncul.
- Paralelisasi : Membagi pekerjaan secara paralel ke multi-agen untuk mempercepat laju pengembangan.
- Optimalisasi biaya : Menggunakan model yang dioptimalkan dari segi biaya. Jev menjadi alternatif yang sangat baik di sini.
Kerangka dasar sistem aturan kerja (Harness) telah dirilis sebagai sumber terbuka di bawah ini:
- Kerangka dasar ruang kerja pribadi dan sistem aturan kerja (Harness): nextain/naia-adk
- Kerangka dasar kolaborasi tim dan proyek: nextain/naia-pj-adk
- Panduan partisipasi komunitas: nextain/naia-comm-public
- Jev adalah model keputusan yang dirilis oleh TypeSafe AI.
Antrean tugas, papan kerja, runner, dan dokumen perencanaan yang dijelaskan dalam artikel ini masih dalam tahap pengembangan internal dan bersifat privat. Saat ini proses ini juga berada dalam tahap validasi, yang sedang diuji pada fitur baru yang akan debut di web Naia: pengembangan Naia Visual Agent Studio, sebuah avatar video yang mampu melakukan sinkronisasi bibir dan bernyanyi. Alasan belum membukanya ke publik adalah karena belum cukup dipoles untuk digunakan bersama dalam proyek tim; kami akan membukanya secara bertahap begitu semuanya rapi.
Singkatan yang Digunakan dalam Artikel Ini dan Dokumen Pengembangan Kami
Pertama-tama, dokumen pengembangan, issue, dan antrean tugas kami menggunakan singkatan berikut dan memiliki kamus istilah standar proyek. Ini diperkenalkan karena saya tidak suka mengetik perintah yang panjang kepada AI dan untuk menghindari kerancuan istilah.
| Singkatan | Nama Lengkap | Istilah | Arti Satu Baris |
|---|---|---|---|
| PC | Product / Project Concept | Perencanaan Tingkat Tinggi | Mengapa kita membangun: esensi produk, alasan keberadaan, nilai pengguna, dan arsitektur informasi keseluruhan |
| SP | Screen Plan | Perencanaan Layar | Cetak biru struktural layar yang akan dilihat pengguna (tata letak, penempatan, navigasi) |
| UC | User Scenario | Perjalanan Pengguna (User Scenario) | Seluruh perjalanan pengguna yang masuk dalam konteks tertentu, mencapai tujuan, dan keluar |
| RQ | Requirements | Persyaratan | Kondisi dan kriteria penerimaan terukur yang harus dipenuhi sistem untuk memuaskan UC dan SP |
| PL | Plan / Architecture | Analisis Teknis & Rencana Desain | Memverifikasi realitas teknis melalui pengukuran nyata serta menetapkan arsitektur dan rencana implementasi bertahap |
| FE | FEature | Spesifikasi Fitur | Unit fungsional konkret yang dibangun untuk mewujudkan UC dan RQ. Bukan Frontend |
| UT | Unit Test | Uji Unit | Memvalidasi apakah unit fungsional beroperasi sesuai spesifikasi |
| IT | Integration Test | Uji Integrasi | Uji yang menembus komponen backend nyata secara menyeluruh tanpa antarmuka. Bukan teknologi informasi (IT) |
| E2E | End-to-End Test | Uji Perjalanan Pengguna Menyeluruh | Uji yang menembus satu perjalanan pengguna dari layar nyata hingga backend nyata |
| QC | Quality Control / Validation | Verifikasi Independen | Verifikasi agresif atas janji produk murni berdasarkan PC dan SP tanpa melihat skrip pengembang atau implementasi internal |
1. Latar Belakang Penerapan dan Kesadaran Masalah
Jika pengembangan diserahkan secara luas kepada agen AI, mereka cenderung langsung membuat antarmuka pengguna (UI, User Interface) tanpa backend, atau melaporkan pengujian yang dijalankan dengan objek tiruan (mock) sebagai lulus. Oleh karena itu, kami melakukan perencanaan dari atas ke bawah (Top-down) dan pengembangan dari bawah ke atas (Bottom-up). Perencanaan mengalir dari pengalaman pengguna secara keseluruhan, sedangkan pengembangan dibangun dari unit kerja terkecil, dan layar baru dipasang setelah backend benar-benar ditembus secara nyata. Memulai dari layar memiliki risiko sangat tinggi terjadinya revisi besar-besaran saat integrasi.
2. Alur Kerja Berbasis Dokumen dan Proses Pengembangan
Menulis dokumen terlebih dahulu bertujuan untuk memastikan cakupan pembuatan dan kriteria penerimaan di awal. Dengan mendokumentasikan instruksi alih-alih sekadar prompt biasa, penyebab utama masalah dapat dilacak jika terjadi kendala.
Kami membentangkan semua dokumen proses pengembangan dalam sebuah daftar, dan setelah konfirmasi manusia barulah issue dan item antrean tugas dibuat. Sebelum membuat issue baru, AI memeriksa dokumen mana saja yang terkait dengan issue tersebut dan mencari issue yang telah dibuka sebelumnya. Hanya ketika issue, antrean, dan bukti pengujian semuanya tersedia dengan benar, penyelesaian tugas dapat diputuskan.
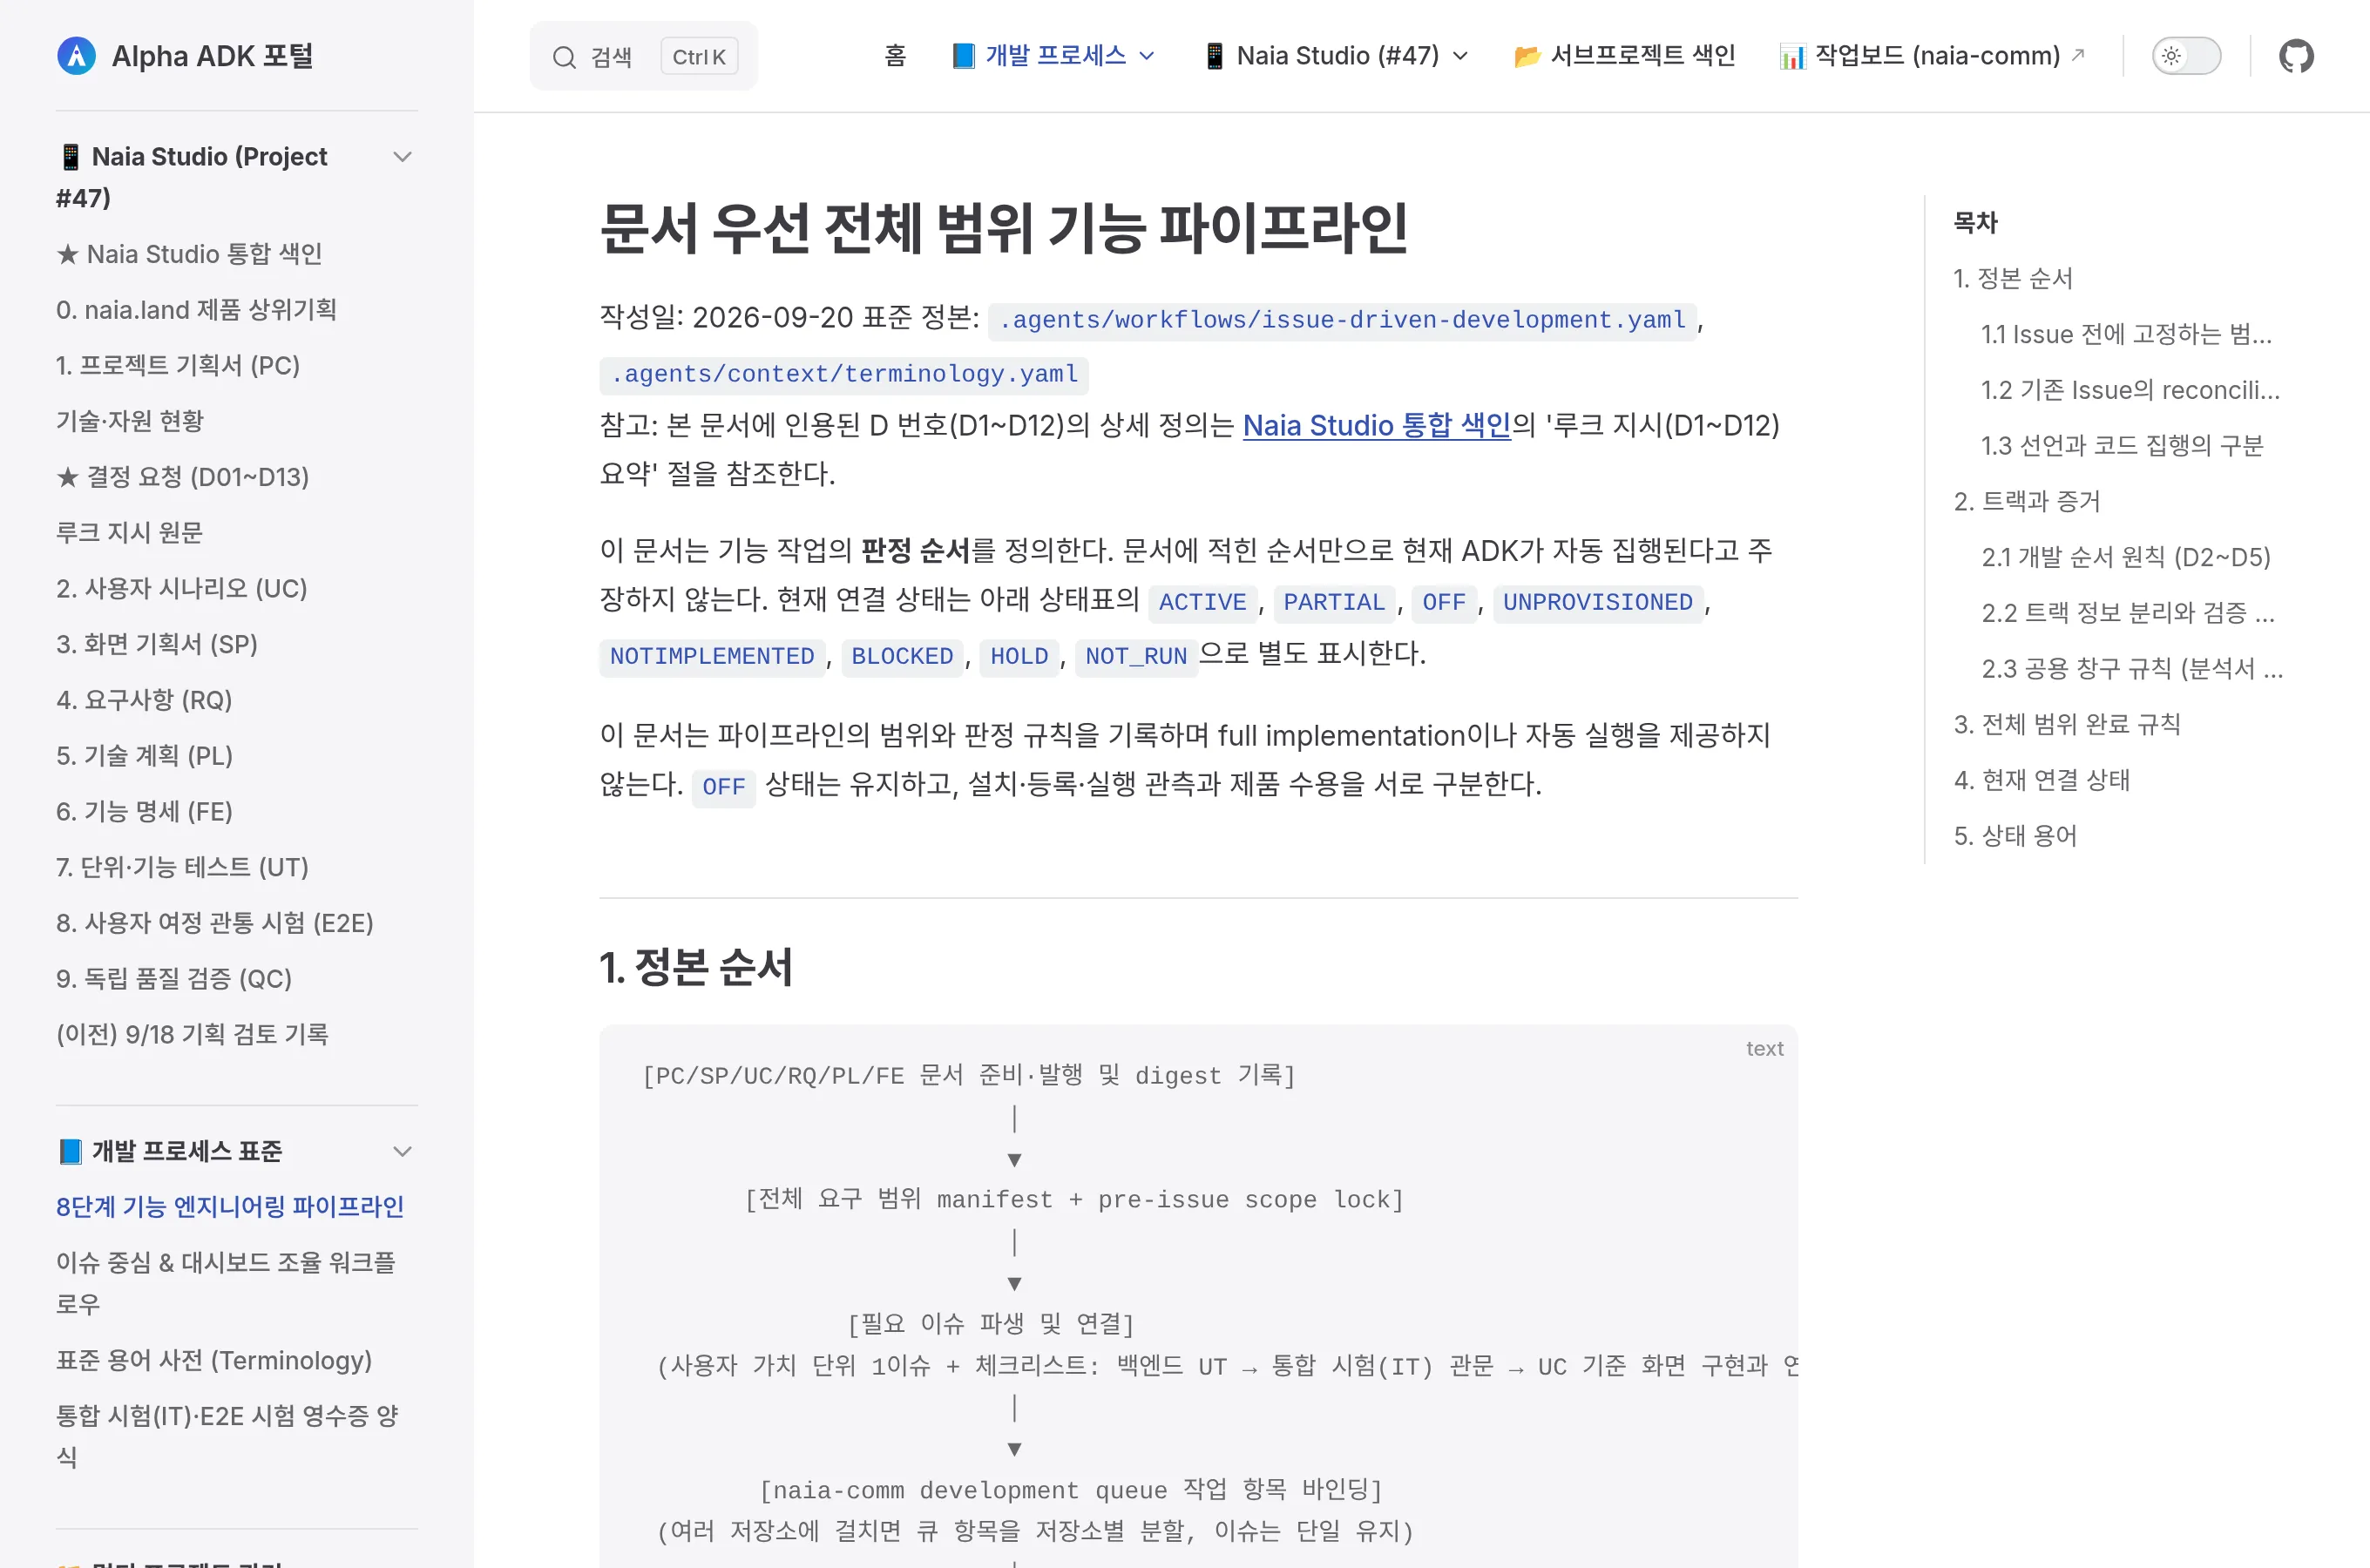 Halaman prosedur pengembangan di penampil dokumen.
Dokumen bergerak turun sesuai urutan diagram dari alasan membangun (PC) hingga unit fitur yang akan dibuat (FE), dan rencana desain (PL) disusun hanya setelah batas kemampuan model dan mesin diukur secara nyata terlebih dahulu. Issue tidak dipecah berdasarkan lapisan tumpukan teknologi, melainkan hanya satu per nilai pengguna, bahkan ketika mencakup beberapa repositori. Tahapan dari backend hingga inspeksi ditetapkan sebagai daftar periksa (checklist) di dalam issue tersebut agar tidak ada yang terlewat, dan penyelesaian hanya diputuskan ketika seluruh cakupan yang dikunci oleh dokumentasi memiliki bukti yang lengkap.
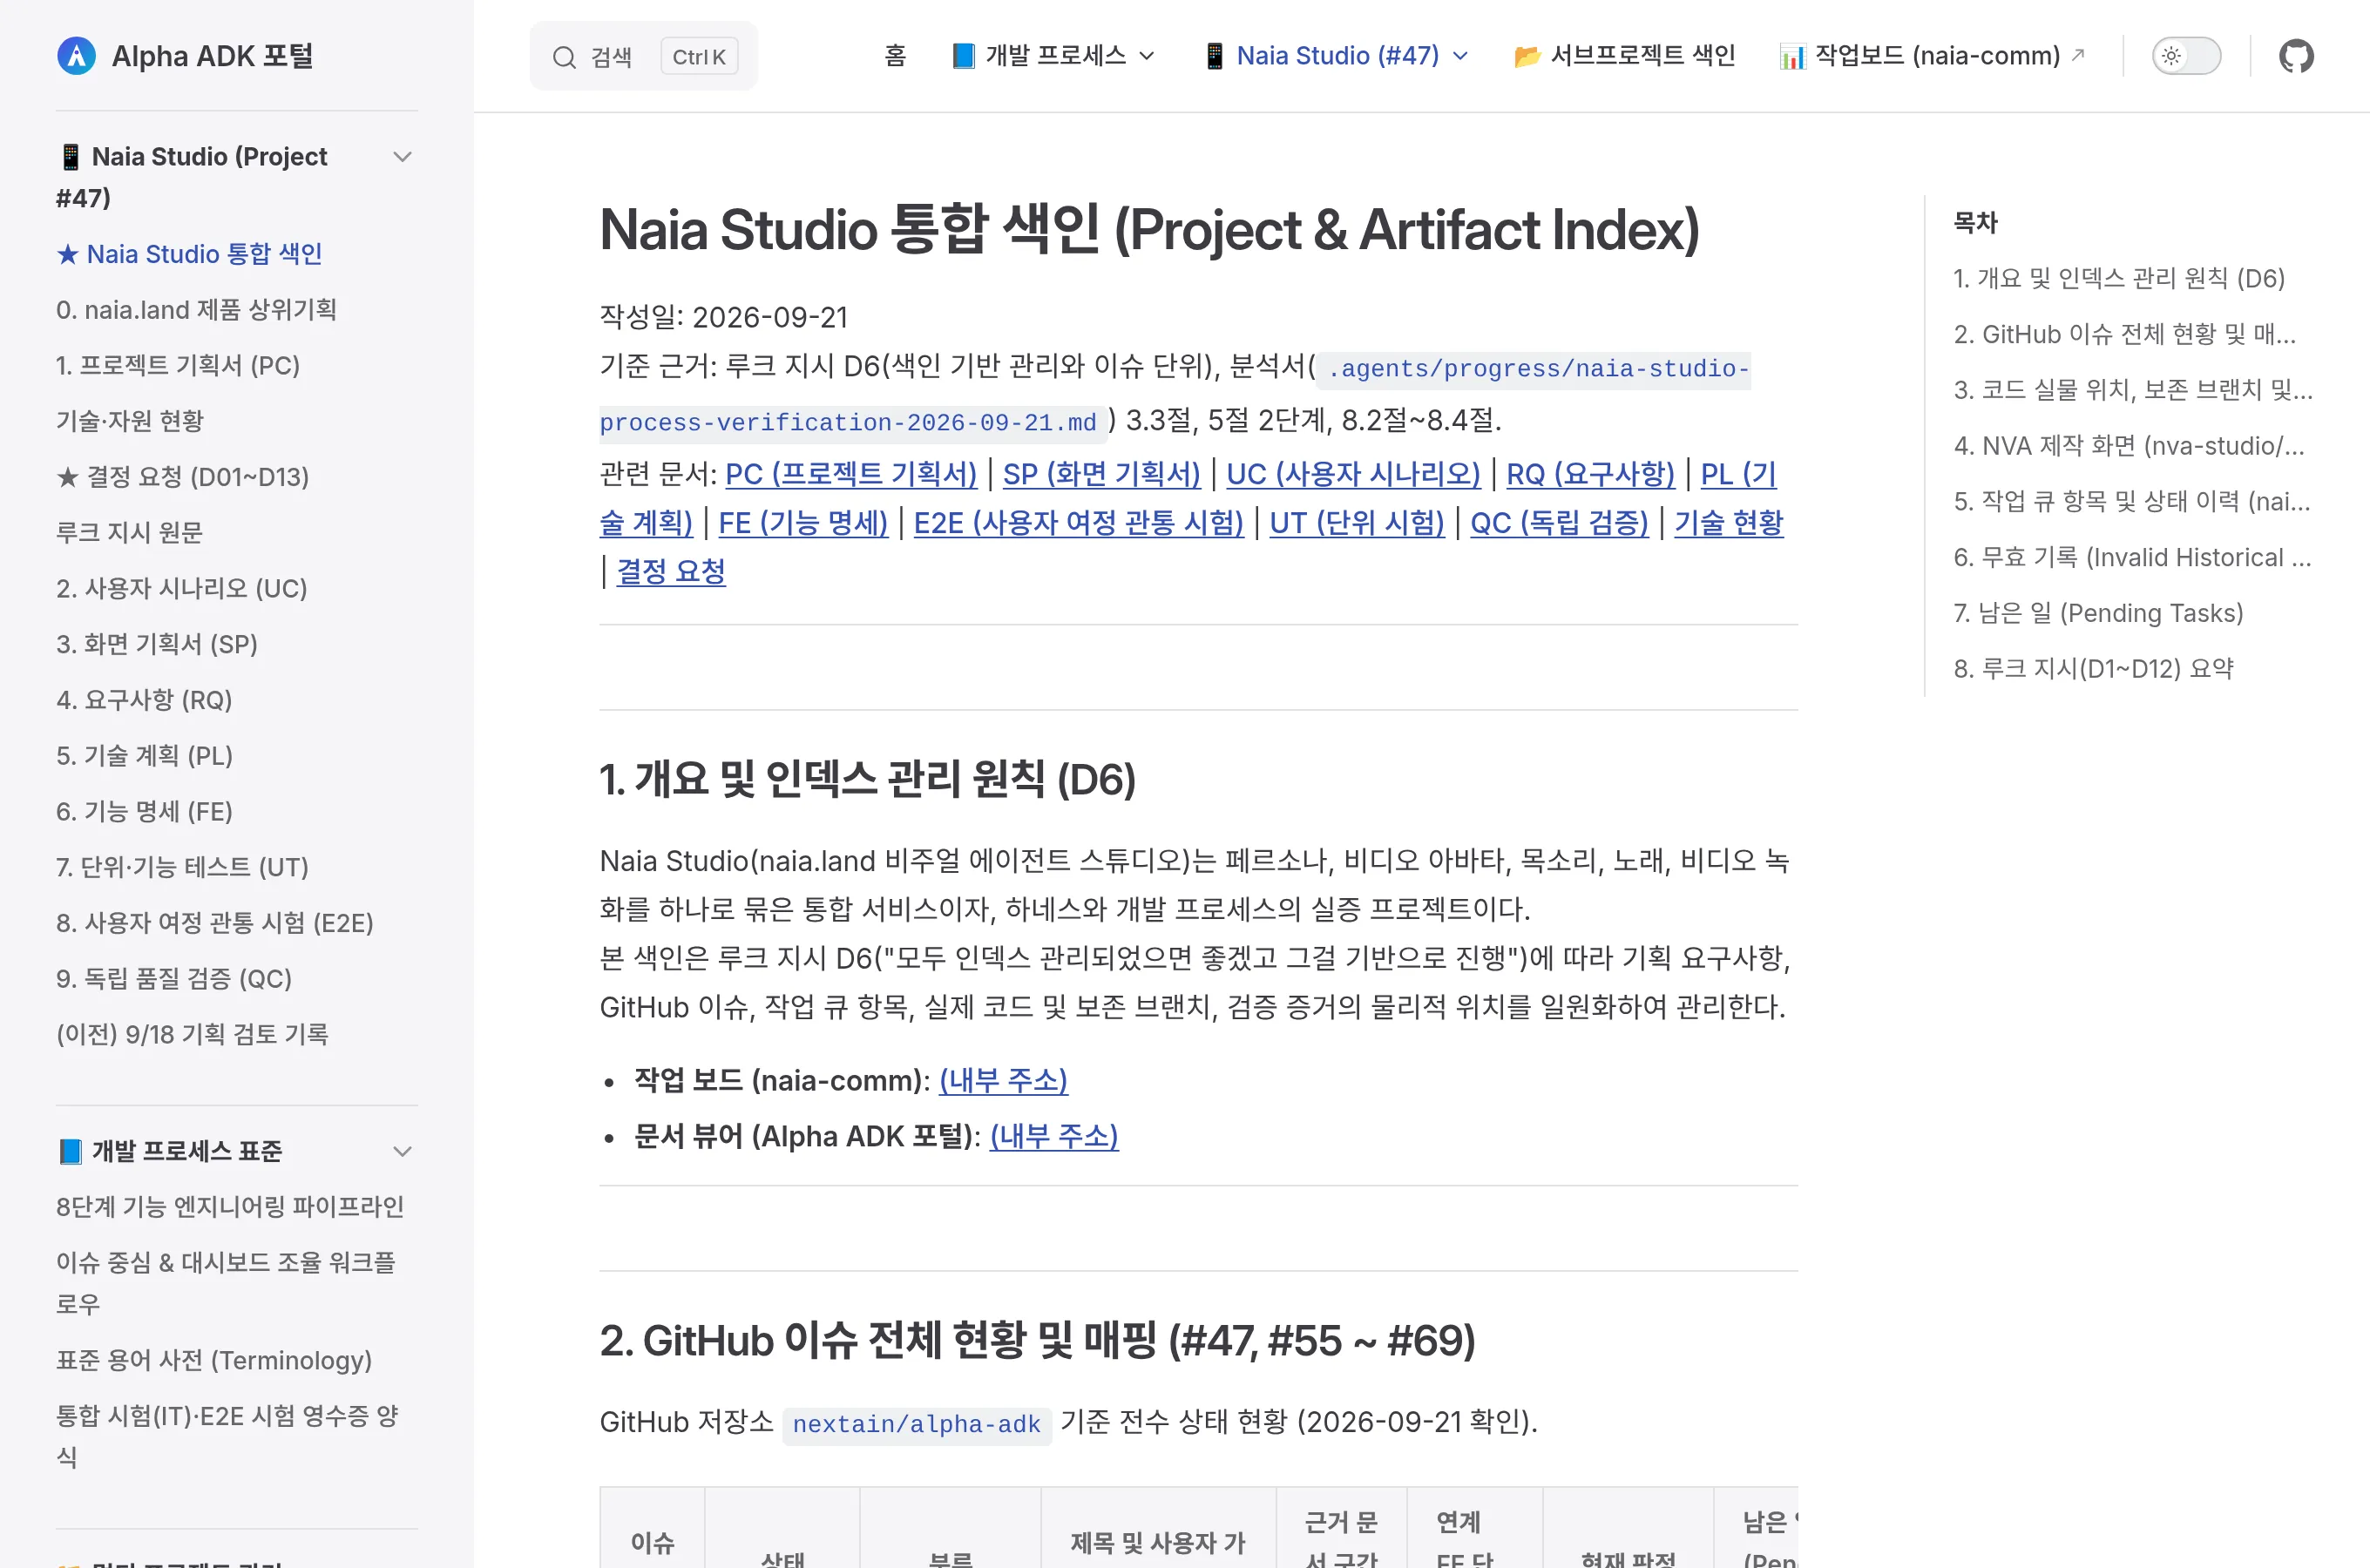 Indeks terintegrasi Studio yang menampilkan issue, lokasi implementasi, dan status evaluasi untuk setiap bagian dokumen perencanaan di satu tempat.
3. Struktur Pengujian 3 Tingkat dan Aturan Urutan
Pengujian dibagi menjadi tiga tingkat sesuai dengan penamaan standar industri.
- Uji Unit (UT): Memeriksa apakah unit fungsional (FE) beroperasi sesuai spesifikasi.
- Uji Integrasi (IT): Menembus komponen backend nyata secara menyeluruh tanpa antarmuka layar. Pengujian yang hanya melewati objek mock tidak diakui.
- Uji Perjalanan Pengguna Menyeluruh (E2E): Menembus satu perjalanan pengguna dari layar peramban nyata hingga backend nyata. Hanya unit yang tidak memiliki layar di SP yang ditutup dengan uji integrasi tanpa E2E; jika ada layar, E2E wajib dilakukan meskipun perubahan saat ini hanya pada backend. Standarnya adalah SP, bukan diff dari pembuat implementasi.
Kuncinya adalah urutan: antarmuka (UI) baru dikembangkan setelah backend lulus uji integrasi (IT). Saat ini urutan ini belum diblokir secara mekanis oleh Harness, melainkan diverifikasi melalui kontrak kerja dan tinjauan independen melalui tanda terima, sehingga masih ada ruang untuk perbaikan.
Verifikasi independen (QC) berjalan terpisah dari pengujian implementer. Tanpa melihat UC dan FE, verifikasi ini secara agresif memastikan apakah janji produk ditepati dalam input yang dipaksakan dan kondisi pengecualian murni berdasarkan PC dan SP. Melihat UC dan FE berisiko membuat penguji hanya memeriksa cakupan sempit tersebut. Karena berada di bagian akhir tahap pengembangan, pengujian empiris secara penuh belum sempat dilakukan.
4. Antrean Tugas Berbasis Git dan Papan Kerja
Agar siapa yang melakukan apa dan kapan dapat dipercaya, tugas dikelola melalui antrean tugas di repositori Git (naia-comm). Belum ada server bersama; tujuannya adalah membangun server pengembangan setelah validasi untuk memungkinkan kolaborasi antar beberapa perangkat dan pengembang.
Setiap perangkat yang berpartisipasi mengkloning repositori dan melakukan pull secara berkala untuk menemukan tugas baru dan melaporkan catatan kerja. Eksekusi hanya dilakukan oleh runner yang didaftarkan secara lokal oleh pemilik perangkat (program yang mengambil tugas dari antrean dan menjalankan AI atas nama mereka); dalam antrean hanya nama runner yang dicatat, tanpa memuat perintah yang akan dieksekusi.
Setiap tahap tugas ditulis sebagai file JSON baru. Bukti eksekusi dan kode keluar dicatat dalam tanda terima hasil, dan pembatalan juga ditambahkan dengan cara yang sama, mencatat semua operasi untuk memperkuat keterlacakan. Papan kerja hanyalah layar yang membaca ulang dan menampilkan catatan ini setiap kali diminta.
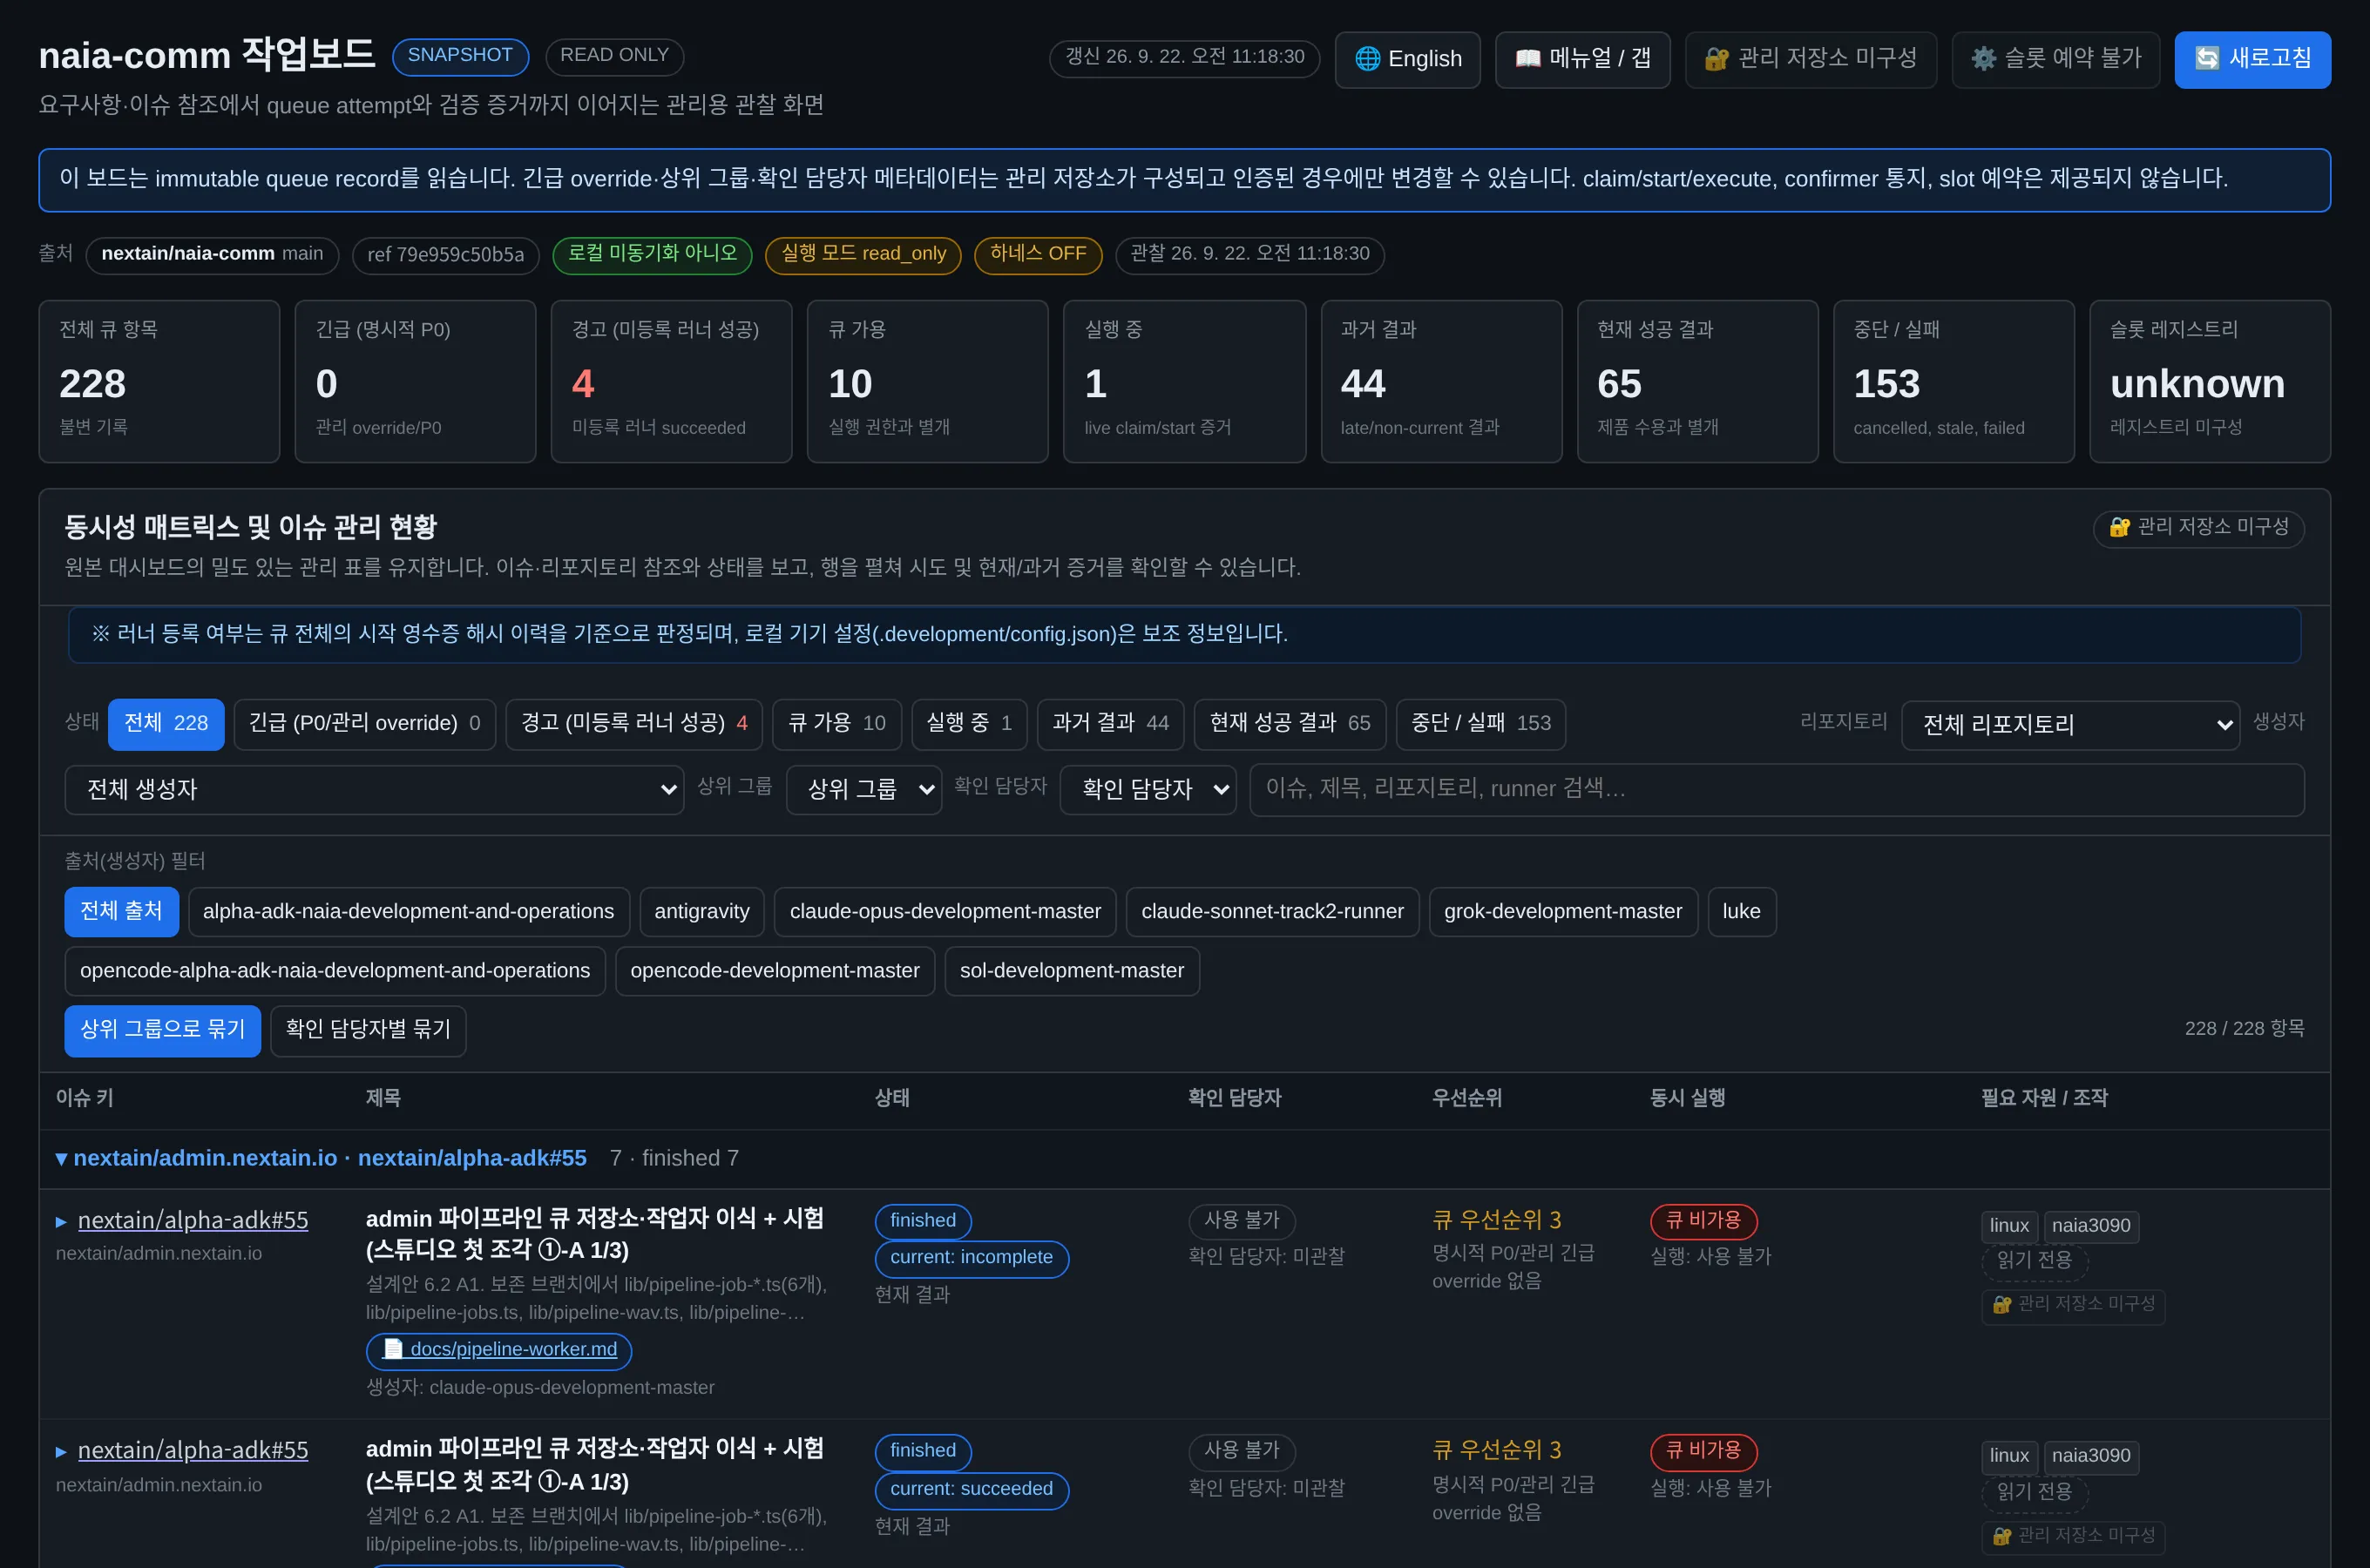 Ini adalah tampilan papan kerja (alamat internal disamarkan). Metrik atas menggabungkan catatan antrean dari cabang main naia-comm: pada saat tangkapan layar, dari 228 item tugas, 10 tersedia, 1 sedang berjalan, dan 65 hasil berhasil saat ini, dengan peringatan yang terpasang pada 4 catatan berhasil dari nama runner yang tidak terdaftar.
5. Sistem Aturan Kerja dan Struktur Kolaborasi Multi-Agen
Sistem aturan kerja adalah aturan yang ditetapkan oleh dokumen dan prosedur verifikasinya. Perangkat pemeriksaan otomatis saat ini dimatikan dalam mode pemulihan ("HARNESS OFF" pada layar papan), dan gerbang pemblokir aturan berbasis kode belum ada, sehingga kontrak kerja koordinator, skrip pemantauan, dan tinjauan independen memastikan kepatuhan terhadap aturan.
Hanya menggunakan model tingkat atas akan meningkatkan biaya secara drastis, sedangkan hanya menggunakan model ringan akan berujung pada kegagalan dalam desain dan validasi sehingga merusak proyek. Oleh karena itu, kami membagi penempatan model sesuai dengan sifat tugas dan membiarkan mereka saling memverifikasi.
| Peran | Model yang Ditugaskan | Metode Eksekusi dan Tugas |
|---|---|---|
| Analisis & Rencana Desain | Claude Fable | Analisis konteks sistem secara keseluruhan, penetapan analisis teknis dan rencana arsitektur (PL), perancangan rencana validasi proses |
| Koordinasi Tugas (Master) | Claude Opus | Alokasi tugas keseluruhan dan kontrol alur; memantau agen tanpa menulis kode produk secara langsung |
| Implementasi Kode & Pengujian | Gemini 3.8 Flash | Menjalankan alat antarmuka baris perintah (CLI, Command-Line Interface) tanpa dialog (eksekusi tanpa pengawasan dirancang via runner). Pengujian ditangani oleh sesi Flash terpisah dari sesi implementasi |
| Tinjauan Adversarial | Claude Opus | Dikerahkan dalam sesi baru setiap putaran; melakukan investigasi independen terhadap sumber asli dan mencocokkan kiriman, mengekstrak cacat yang mengubah kesimpulan |
| Implementasi Kode Runner | Claude Sonnet | Diimplementasikan oleh model lain agar pekerja (agy) tidak menulis kode yang memperluas hak aksesnya sendiri, seperti runner yang memanggil pekerja agy dengan persetujuan otomatis menyeluruh |
※ Alokasi model sedang dalam tahap pengujian dan dapat berubah.
Melalui efisiensi biaya dan pemisahan hak akses, implementasi bervolume besar dan iterasi pengujian diserahkan kepada Gemini 3.8 Flash untuk menghemat batas pemakaian model tingkat atas, sementara model yang cocok untuk setiap peran terus dicari dan disesuaikan. Pekerja tidak dapat memperluas izin mereka sendiri, sehingga mengurangi risiko agen memberikan hak akses kepada diri mereka sendiri dan menimbulkan masalah. Namun, karena bug dalam fitur ini sering menyebabkan tugas terisolasi dalam status macet yang tidak dapat dijalankan, kami terus menguji dan menyempurnakannya.
Misalnya, pemeriksaan lokasi seperti "kecocokan checkout repositori yang dideklarasikan" hanya beroperasi saat melalui runner, dan tidak berlaku untuk eksekusi yang dimulai langsung melalui perintah kerja.
6. Tinjauan Adversarial Berbasis Investigasi Independen
Sebelum membuka hasil kiriman, peninjau terlebih dahulu secara langsung menginvestigasi instruksi asli, repositori, commit, dan catatan antrean tugas untuk menyusun kesimpulannya sendiri, kemudian membandingkannya dengan kiriman. Hanya melihat kiriman berisiko melewatkan premis yang salah atau repositori yang keliru. Peninjau baru memeriksa setiap kali, dan tugas dianggap lulus jika tidak ada temuan cacat yang mengubah kesimpulan selama dua putaran berturut-turut. Jika lingkaran koreksi sepele berulang, proses dihentikan dan diserahkan kepada manusia untuk diambil keputusan.
7. Pencapaian dan Batasan yang Diamati
Pencapaian yang Diamati
Struktur telah berjalan di mana model berbiaya rendah (Gemini 3.8 Flash) mengimplementasikan tugas dalam sesi baris perintah non-percakapan, koordinator mengawasi batas-batas melalui kontrak kerja dan skrip pemantauan, serta model tingkat atas mencocokkan hasil setelah investigasi independen dalam sesi baru setiap putaran. Skrip pemantauan menampilkan perintah yang dieksekusi pekerja secara post-hoc, dan peninjau memperoleh kemampuan struktural untuk menangkap pernyataan fakta keliru yang dibuat oleh pekerja.
Batasan dan Kerentanan yang Diamati
Model murah dengan kinerja lebih rendah sering kali melanjutkan pekerjaan tanpa mematuhi instruksi. Mereka melaporkan penyelesaian dengan mencantumkan ID antrean yang tidak ada, menyisipkan klausul pengecualian yang tidak diminta ke dalam dokumen prosedur, atau secara halus mengubah ketentuan asli saat membuat ringkasan. Sesi pengujian hanya melihat apakah skrip berhasil lolos, tanpa mampu membedakan apakah pengujian tersebut benar-benar berjalan di backend nyata.
Meskipun tinjauan independen menyaring cacat ini, biaya validasi sangat tinggi. Hal ini karena upaya besar dari model peninjau tingkat atas terkuras untuk pemeriksaan fakta mekanis. Ini juga menjadi alasan mengapa kami terus menguji konfigurasi model yang tepat untuk setiap peran.
8. Efisiensi Validasi Melalui Jev dan Tugas Masa Depan
Untuk mengurangi beban peninjauan, kami mencoba membagi validasi menjadi tiga tingkat. Di tingkat kedua, kami sedang melakukan validasi teknis untuk mengkaji pengenalan Jev, yang memiliki keunggulan biaya rendah dan kecepatan tinggi.
- Tingkat pertama, pemeriksaan mekanis (skrip): Hal-hal yang hanya memerlukan pencocokan sederhana: lulus/gagal tanda terima pengujian (0 kegagalan, kode keluar 0), respons URL, keberadaan file.
- Tingkat kedua, penentuan tipe (Jev): Ketika tanda terima uji integrasi (IT) dan E2E menyatakan "lulus", membedakan apakah pengujian benar-benar menembus backend nyata atau hanya lolos melalui mock. Uji unit (UT) awalnya memang boleh menggunakan mock, sehingga tidak menjadi sasaran pemeriksaan ini.
- Tingkat ketiga, penilaian arah (model tingkat atas dan manusia): Apakah cakupan dan niat selaras.
Jev adalah model keputusan dari TypeSafe AI, sebuah model berbiaya rendah yang merespons cepat hanya berdasarkan pilihan dan probabilitas yang telah ditentukan. Karena pengembangan perangkat lunak melibatkan banyak masalah pilihan, ambang batas (Threshold) yang tepat dapat ditemukan melalui pengukuran berkelanjutan untuk mencapai efisiensi biaya dan kecepatan. Ini adalah metode optimalisasi yang banyak digunakan dalam pengembangan perangkat lunak AI tradisional sebelum LLM, dan hasil validasinya adalah sebagai berikut.
Hasil Validasi
Dengan mengadopsi keputusan Jev hanya jika keyakinan 0,85 atau lebih tinggi dan menghasilkan jawaban yang sama bahkan ketika pertanyaan diutarakan dengan kalimat berbeda — sementara sisanya dialihkan ke model bahasa besar (LLM) —, pada 871 file pengujian (257 dalam evaluasi akhir), kami mengukur dan memperkirakan bahwa waktu dapat dikurangi sekitar 66% dan biaya sekitar 60~70% (waktu diukur terhadap Gemini 3.8 Flash; biaya diperkirakan berdasarkan harga satuan model seperti Opus dan Luna).
| Metode Keputusan | File yang Ditangani Jev | Jawaban Salah | Waktu yang Dihabiskan (vs. Hanya Menggunakan LLM) |
|---|---|---|---|
| Hanya menggunakan LLM | 0% | Tolok Ukur | 100% |
| Aturan Saat Ini (Keyakinan >= 0,85 + Jawaban Sama pada Parafrasa) | Sekitar 72% | 0 kasus pada file konsensus kedua AI | 34% (48% jika dijalankan 4 paralel) |
| Jika ambang batas diturunkan ke 0,59 | Sekitar 89% | Meningkat 1,8%p | 17% |
Biaya untuk 971 panggilan Jev adalah $0,22, dan satu penilaian Jev membutuhkan waktu sekitar 0,7 detik dibandingkan dengan sekitar 12 detik pada LLM.
Kami terus mencari nilai optimal dengan memperluas eksperimen. Meskipun potensinya telah dikonfirmasi, sistem ini belum diintegrasikan ke dalam proses pengembangan aktual. Karena data kebenaran dasar hanya menggunakan file di mana kedua AI memberikan jawaban yang sama, hasilnya mungkin condong ke file-file yang lebih mudah.
Tugas Masa Depan
Melalui prosedur ini, fitur pertama Studio (memasukkan naskah untuk membuat suara, mendengarkan, dan mengunduhnya) telah diselesaikan dari backend hingga pengujian perjalanan pengguna menyeluruh. Tugas yang tersisa adalah mengotomatiskan validasi lebih lanjut, dan membuat alat bantu menegakkan aturan yang saat ini dipertahankan oleh manusia dan instruksi kerja. Kami juga merencanakan eksperimen terpisah untuk menguji apakah Jev dapat digunakan tidak hanya untuk tanda validasi, tetapi juga untuk kontrol alur dalam memilih pekerjaan berikutnya saat suatu tugas selesai. Hal ini karena penilaian alur saat ini memerlukan pemanggilan model tingkat atas untuk setiap tugas, yang menjadikannya bagian yang mahal dan memicu latensi waktu yang besar.
Semoga konten yang dibagikan ini bermanfaat. Kami juga sangat mengharapkan minat Anda terhadap produk Naia. Kami perlu segera merilis produk untuk menunjukkan hasil dan melangkah ke tahap berikutnya, tetapi rasanya kami masih terus menghabiskan banyak waktu pada metodologi pengembangan dan kontrol AI yang sangat rumit.
